Modelo e dados: que sistema você está usando
Modelo e aplicação
Um modelo de aprendizado de máquina é um sistema computacional treinado com dados para fazer previsões ou gerar conteúdo. Não é uma peça de hardware: é o sistema que realiza essas tarefas.
Parâmetros e dados de treinamento
Os parâmetros são valores numéricos que fazem parte de um modelo de aprendizado de máquina. Em modelos de linguagem, o sistema usa esses valores para estimar probabilidades de sequências de tokens e produzir previsões ou texto.
Um modelo pode produzir respostas coerentes ao aproveitar padrões estatísticos aprendidos, mas essa capacidade não demonstra consciência ou compreensão humana. É importante distinguir comportamento linguístico convincente de conhecimento comprovado: uma resposta bem redigida ainda pode conter erros.
Treinamento, inferência e ajuste fino
Treinamento e inferência
O treinamento é o processo de ajustar um modelo com dados. A inferência é a geração de uma saída ou previsão por meio de um modelo já treinado, a partir de uma entrada. Quando alguém faz uma pergunta a um chatbot, está usando o modelo para obter uma resposta; o ajuste fino, por sua vez, exige treinamento adicional.
O que significa ajuste fino?
O ajuste fino (fine-tuning) é um treinamento adicional que adapta um modelo a uma tarefa ou tipo de dado específico. Não é o mesmo que acrescentar uma instrução a uma conversa. Escrever «resuma este texto» altera a solicitação recebida pelo sistema; as instruções podem personalizar a saída sem mudar os parâmetros do modelo.
Essa distinção também importa ao avaliar a privacidade: inferência descreve como uma saída é obtida, não o que o provedor fará depois com os dados enviados. O uso durante a consulta e o tratamento posterior são questões diferentes; para saber se entradas ou registros são armazenados, é necessário verificar as condições, configurações e políticas do serviço específico.
LLM, tokens, contexto e memória
LLM e tokenizador
LLM é a sigla em inglês de Large Language Model, ou modelo de linguagem grande: um modelo que estima a probabilidade de tokens ou sequências de tokens e pode ser usado para gerar texto. Um token pode ser uma palavra, parte de uma palavra ou um caractere, dependendo do método de segmentação. O tokenizador converte o texto em tokens e depois em identificadores numéricos que o modelo consegue processar. Não existe equivalência universal entre token, palavra e caractere; a segmentação também varia conforme o idioma.
Janela de contexto e memória
A janela de contexto é o conjunto limitado de tokens incluído quando um modelo de linguagem gera uma saída. Pode reunir instruções, histórico de mensagens, ferramentas e dados externos. Gerenciar esse contexto significa selecionar as informações fornecidas ao modelo; em contextos extensos, a capacidade de recuperar dados com precisão pode diminuir.
A memória pode ser um recurso acrescentado a um modelo, junto com ferramentas ou recuperação de informações; seu funcionamento depende do sistema que a incorpora. Contexto presente não é o mesmo que lembrança permanente, e recuperar informações não equivale a treinar o modelo novamente.
Prompt: solicitar uma tarefa com contexto
Um prompt é uma entrada que pode incluir instruções e exemplos para orientar a resposta de um modelo. Por exemplo: «Resuma este texto fictício em três tópicos e indique qual dado não foi esclarecido». É uma forma de personalizar a saída, não uma fórmula que garanta um resultado correto.
As instruções ajudam a especificar a tarefa e orientar a resposta, mas não garantem que ela esteja correta. Incluir exemplos também pode ajudar a mostrar o tipo de saída esperado. A qualidade depende de como o contexto é organizado e da capacidade do modelo de realizar a tarefa.
Embeddings, busca semântica e RAG
Embeddings e busca semântica
Um embedding é uma representação numérica de dados. Em uma busca semântica, embeddings podem representar elementos para compará-los com base em relações aprendidas, como a semelhança entre conceitos.
RAG: recuperar antes de responder
RAG significa Retrieval-Augmented Generation, ou geração aumentada por recuperação. O sistema recupera informações de uma fonte externa e as acrescenta ao contexto recebido pelo modelo para gerar uma resposta. Assim, pode incorporar dados externos sem treiná-lo novamente. A recuperação pode usar diferentes métodos, inclusive a busca semântica.
O RAG pode fornecer documentos que não faziam parte do contexto original do modelo, sem treiná-lo novamente nem alterar seus parâmetros. Isso o distingue do fine-tuning. No entanto, recuperar um trecho não garante interpretá-lo corretamente: a resposta ainda pode resumi-lo de forma errada, omitir uma condição ou combiná-lo com informações que não constam no documento. Conferir a referência e o trecho relevante continua sendo útil.
Agentes, ferramentas e fluxos de trabalho
Ferramentas e agentes
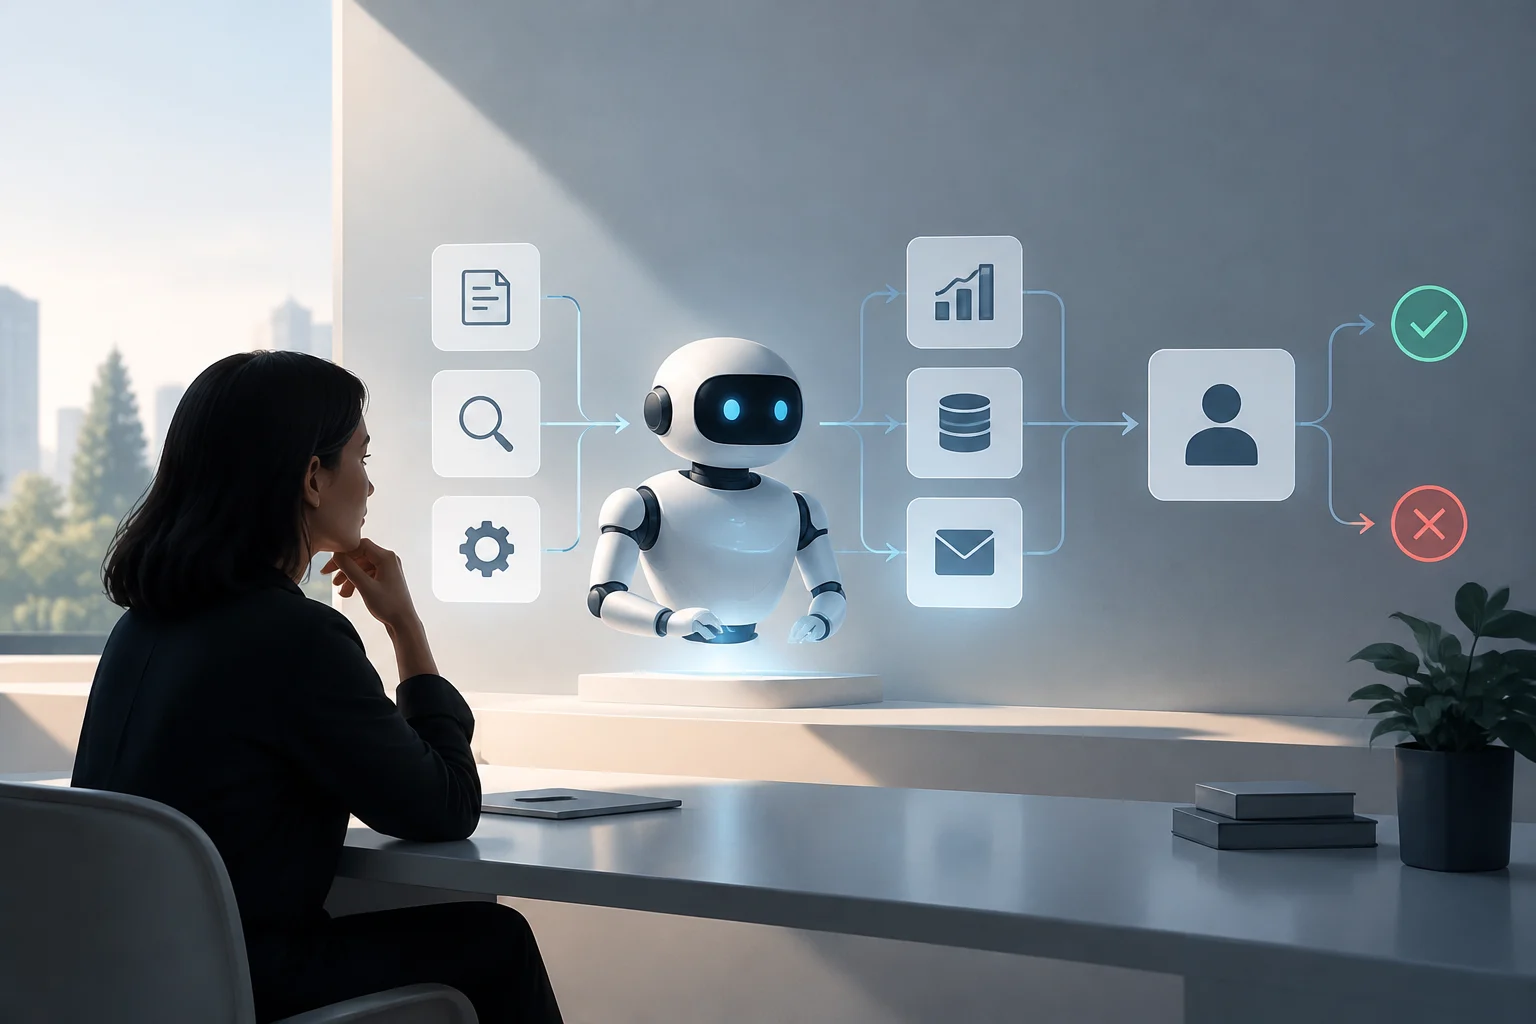
Uma ferramenta amplia as capacidades de um modelo, por exemplo, permitindo que ele recupere informações ou execute uma ação. Em geral, um agente é um sistema no qual um modelo dirige dinamicamente seus passos e o uso de ferramentas para cumprir uma tarefa. O termo também se aplica a sistemas com fluxos predefinidos, por isso seu significado pode variar conforme o contexto.
Fluxo de trabalho e autonomia
Um fluxo de trabalho organiza modelos e ferramentas em etapas definidas previamente. Em um agente, o modelo pode decidir dinamicamente quais ações realizar e quais ferramentas usar. A diferença prática está em quem determina as etapas; as ações possíveis dependem das ferramentas e permissões integradas ao sistema.
Quanto maior a capacidade de ação de um sistema, mais importante é revisar suas permissões e pontos de controle. Para operações sensíveis, convém restringir o acesso a contas e dados e pedir confirmação antes de enviar, publicar, comprar ou apagar algo. Um agente pode errar ou encadear erros; o rótulo não comprova autonomia confiável nem substitui a supervisão.
IA generativa e sistemas multimodais
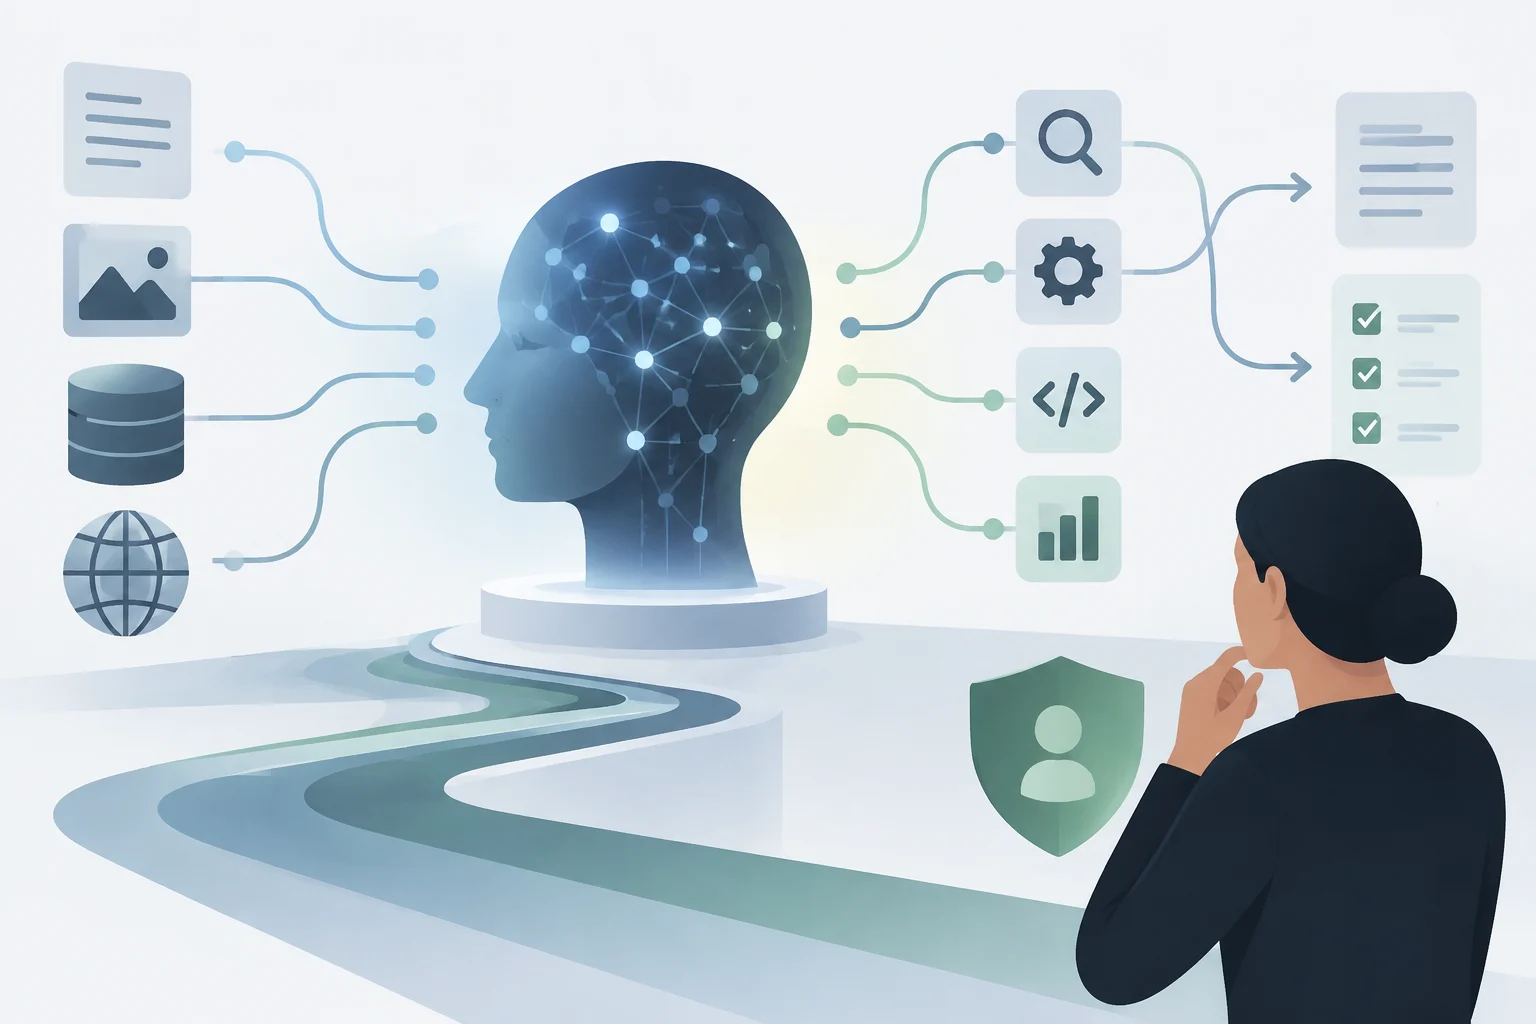
A IA generativa produz conteúdo — por exemplo, texto, imagens, áudio ou vídeo — a partir de padrões aprendidos nos dados e de uma entrada. Outros sistemas de aprendizado de máquina podem se concentrar em classificar algo ou prever um valor, como determinar se uma imagem pertence a uma categoria.
Um sistema multimodal pode processar mais de um tipo de conteúdo, como texto e imagens. Por exemplo, alguns modelos aceitam uma imagem junto com uma pergunta escrita. Os formatos aceitos dependem do modelo: a documentação do Transformers descreve modelos que recebem texto e imagens, além de alguns que aceitam vídeo.
Multimodalidade também não significa multitarefa nem acesso automático à Internet. Um sistema pode combinar imagem e texto sem estar conectado à web, ou executar várias tarefas apenas com texto. Para avaliar um recurso, verifique quais formatos ele aceita, quais resultados gera e quais serviços externos, se houver, pode consultar.
Alucinações, vieses e avaliação
Alucinação ou confabulação
Chama-se alucinação — também confabulação — uma resposta errada ou falsa que o sistema apresenta com segurança, ou que não é respaldada pelo contexto fornecido. Um exemplo hipotético seria atribuir uma afirmação a uma referência inexistente. Fluência não é prova de exatidão; convém verificar citações, nomes, datas e afirmações importantes.
Viés, avaliação e benchmark
Um viés é uma tendência sistemática que pode afetar as saídas ou suas consequências. Em sistemas de IA, pode se manifestar em diferenças de desempenho entre grupos ou em resultados que reproduzem vieses presentes nos dados. Por isso, não basta testar uma consulta genérica: é importante observar como o sistema responde a casos e grupos relevantes para o uso pretendido.
Um benchmark permite medir e comparar o desempenho de modelos por meio de métricas aplicadas a tarefas ou conjuntos de dados. As métricas adequadas dependem da tarefa e dos dados avaliados.
Para avaliar uma ferramenta, use exemplos representativos da sua tarefa e verifique exatidão, erros, limites, acessibilidade e custo, conforme o caso. Diferencie resultado medido em um teste de desempenho no uso cotidiano: o primeiro descreve condições específicas, não garante o segundo. Nenhuma avaliação isolada elimina todos os riscos.
Privacidade, dados, direitos autorais e licenças
Dados e privacidade
A inferência descreve como um modelo produz uma saída a partir de uma entrada, mas não determina, por si só, como os dados pessoais serão tratados. Antes de compartilhar informações, verifique quais dados o serviço solicita e quais controles oferece.
Como precaução, evite incluir dados pessoais ou sensíveis quando não forem necessários e use exemplos fictícios ao testar recursos.
Direitos autorais e licença
O Escritório de Direitos Autorais dos Estados Unidos analisa a proteção de obras criadas com inteligência artificial e o papel da contribuição humana. Em seu relatório sobre resultados gerados por IA, examina a autoria humana e o grau de controle criativo que uma pessoa pode exercer.
Nos Estados Unidos, o Escritório de Direitos Autorais conclui que a proteção de resultados gerados por IA depende da contribuição humana e deve ser analisada caso a caso. O relatório indica que as instruções, por si só, não bastam para determinar a autoria. Essa análise se aplica ao sistema jurídico dos Estados Unidos, não a uma regra mundial.
Diferenças essenciais em resumo
| Conceitos | Diferença prática |
|---|---|
| Modelo / aplicação | O modelo é um sistema treinado com dados para fazer previsões ou gerar conteúdo; uma aplicação pode usar suas previsões. |
| Treinamento / inferência | Treinar ajusta o modelo; inferir significa usá-lo para gerar uma saída. |
| Token / palavra | O token é uma unidade do tokenizador e pode ser uma palavra, parte dela ou outro fragmento. |
| Contexto / memória | O contexto reúne informações incluídas para o modelo gerar uma saída; a memória pode ser um recurso adicional do sistema. |
| RAG / ajuste fino | O RAG recupera informações para acrescentá-las ao contexto; o ajuste fino treina o modelo novamente para adaptá-lo. |
| Agente / fluxo | Um agente pode decidir etapas e ferramentas; um fluxo segue etapas definidas previamente. |
| Multimodal / multitarefa | Multimodal se refere a tipos de dados; multitarefa, a tarefas diferentes. |
| Benchmark / resultado real | Um benchmark mede o desempenho em condições específicas; não o garante em qualquer uso. |
Para decidir se uma ferramenta atende às suas necessidades, identifique qual modelo ou quais recursos ela usa, quais dados você precisa enviar, quais documentos ou serviços ela pode consultar, quais ações está autorizada a executar e quais condições de privacidade e direitos se aplicam. Se uma resposta afetar uma decisão importante, confira as informações em uma fonte adequada, em vez de tratar a segurança ou a fluência da resposta como garantia.