Modèle et données : quel système utilisez-vous
Modèle et application
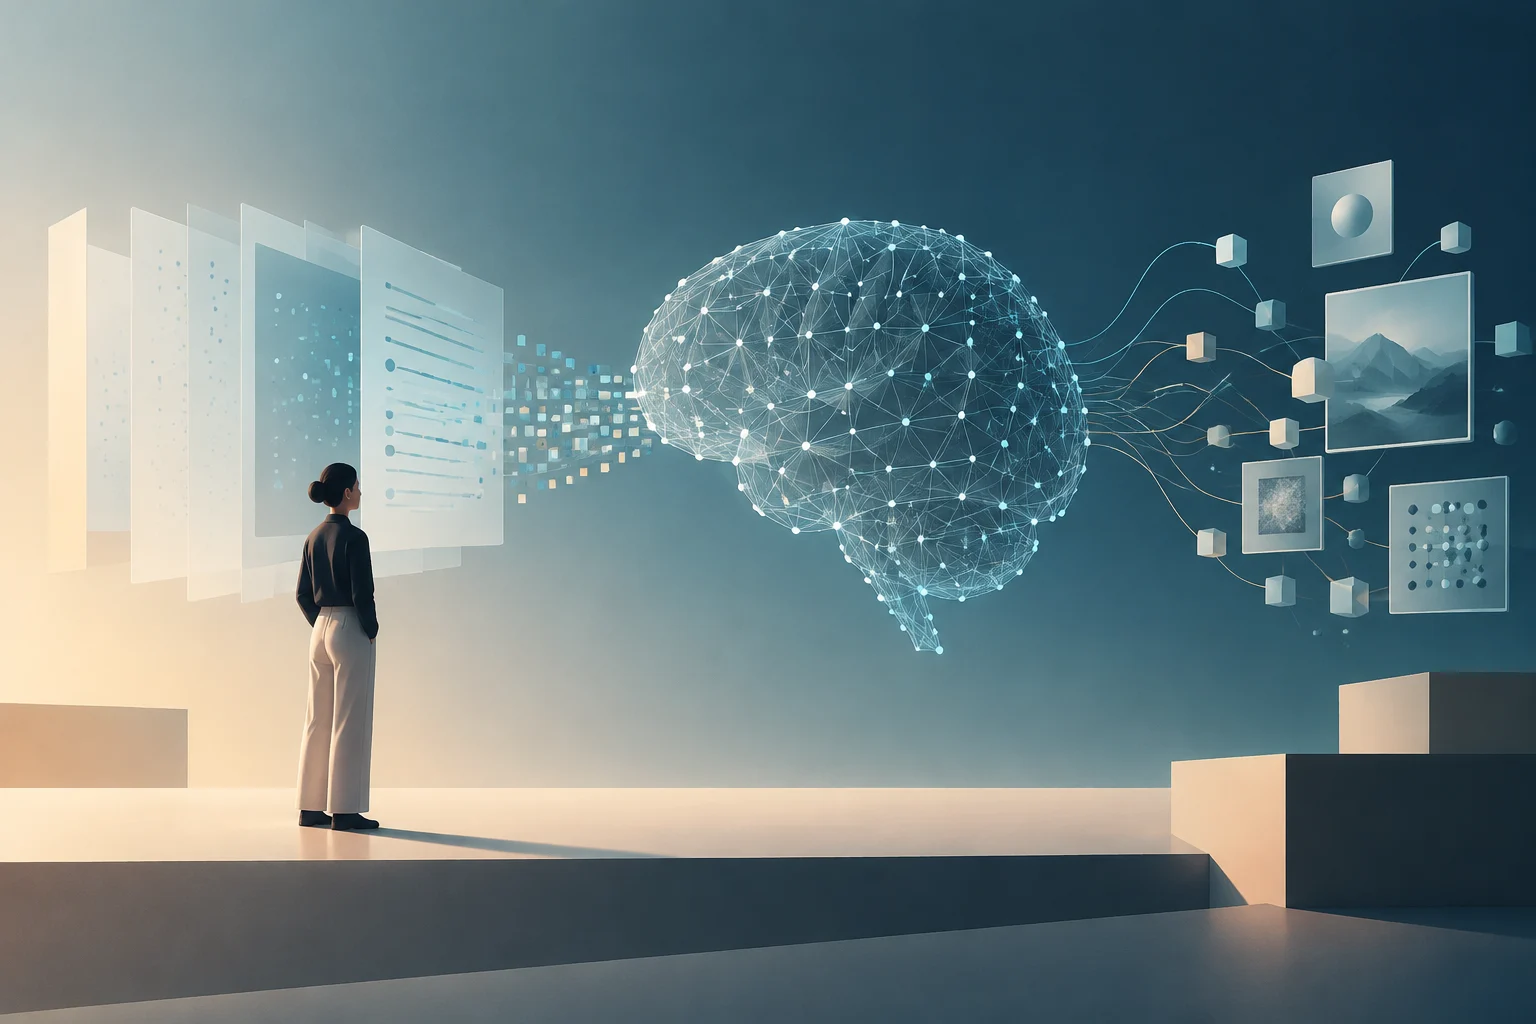
Un modèle d'apprentissage automatique est un système informatique entraîné sur des données pour effectuer des prédictions ou générer du contenu. Ce n'est pas un composant matériel : c'est le système qui exécute ces tâches.
Paramètres et données d'entraînement
Les paramètres sont des valeurs numériques faisant partie d'un modèle d'apprentissage automatique. Dans les modèles de langage, le système utilise ces valeurs pour estimer les probabilités de séquences de jetons et produire des prédictions ou du texte.
Un modèle peut produire des réponses cohérentes en exploitant des motifs statistiques appris, mais cette capacité ne prouve pas qu'il possède une conscience ou une compréhension humaine. Il est important de distinguer le comportement linguistique convaincant du savoir vérifié : une réponse bien rédigée peut encore contenir des erreurs.
Entraînement, inférence et fine-tuning
Entraînement et inférence
L'entraînement est le processus d'ajustement d'un modèle à l'aide de données. L'inférence est la génération d'une sortie ou d'une prédiction par un modèle déjà entraîné, à partir d'une entrée. Lorsqu'une personne pose une question à un chatbot, elle utilise le modèle pour obtenir une réponse ; le fine-tuning, en revanche, nécessite un entraînement supplémentaire.
Qu'est-ce que le fine-tuning ?
Le fine-tuning est un entraînement supplémentaire qui adapte un modèle à une tâche ou à un type de données spécifiques. Ce n'est pas la même chose que d'ajouter une instruction à une conversation. Écrire « résume ce texte » modifie la requête reçue par le système ; les instructions peuvent personnaliser la sortie sans modifier les paramètres du modèle.
Cette distinction est également importante pour évaluer la confidentialité : l'inférence décrit comment une sortie est obtenue, pas ce que le fournisseur fera des données envoyées ensuite. L'utilisation dans la requête et le traitement ultérieur sont deux questions distinctes ; pour savoir si les entrées ou les journaux sont conservés, il faut consulter les conditions, les réglages et les politiques du service spécifique.
LLM, jetons, contexte et mémoire
LLM et tokeniseur
LLM est l'acronyme anglais de Large Language Model, ou grand modèle de langage : un modèle qui estime la probabilité de jetons ou de séquences de jetons et peut être utilisé pour générer du texte. Un jeton peut être un mot, une partie de mot ou un caractère, selon la méthode de segmentation. Le tokeniseur convertit le texte en jetons, puis en identifiants numériques que le modèle peut traiter. Il n'existe pas d'équivalence universelle entre jeton, mot et caractère ; la segmentation varie également selon la langue.
Fenêtre de contexte et mémoire
La fenêtre de contexte est l'ensemble limité de jetons inclus lorsqu'un modèle de langage génère une sortie. Elle peut regrouper des instructions, l'historique des messages, des outils et des données externes. Gérer ce contexte implique de sélectionner les informations fournies au modèle ; avec des contextes étendus, sa capacité à récupérer des données avec précision peut diminuer.
La mémoire peut être une capacité ajoutée à un modèle, accompagnée d'outils ou de récupération d'informations ; son fonctionnement dépend du système qui l'intègre. Le contexte présent n'équivaut pas à un souvenir permanent, et récupérer une information ne revient pas à réentraîner le modèle.
Prompt : demander une tâche avec contexte
Un prompt est une entrée qui peut inclure des instructions et des exemples pour orienter la réponse d'un modèle. Par exemple : « Résume ce texte fictif en trois points et indique quelle donnée reste à clarifier ». C'est une façon de personnaliser la sortie, pas une formule garantissant un résultat correct.
Les instructions aident à préciser la tâche et à orienter la réponse, mais ne garantissent pas qu'elle soit correcte. Inclure des exemples peut également aider à montrer le type de sortie attendu. La qualité dépend de la manière dont le contexte est organisé et de la capacité du modèle à effectuer la tâche.
Embeddings, recherche sémantique et RAG
Embeddings et recherche sémantique
Un embedding est une représentation numérique de données. Dans une recherche sémantique, les embeddings peuvent représenter des éléments pour les comparer selon des relations apprises, comme la similarité entre concepts.
RAG : récupérer avant de répondre
RAG signifie Retrieval-Augmented Generation, ou génération augmentée par récupération. Le système récupère des informations d'une source externe et les ajoute au contexte reçu par le modèle pour générer une réponse. Il peut ainsi incorporer des données externes sans réentraînement. La récupération peut utiliser différentes méthodes, y compris la recherche sémantique.
Le RAG peut fournir des documents qui ne faisaient pas partie du contexte original du modèle, sans réentraînement ni modification de ses paramètres. Cela le distingue du fine-tuning. Cependant, récupérer un passage ne garantit pas son interprétation correcte : la réponse peut encore le résumer de manière erronée, omettre une condition ou le combiner avec des informations absentes du document. Vérifier la référence et le fragment pertinent reste utile.
Agents, outils et flux de travail
Outils et agents
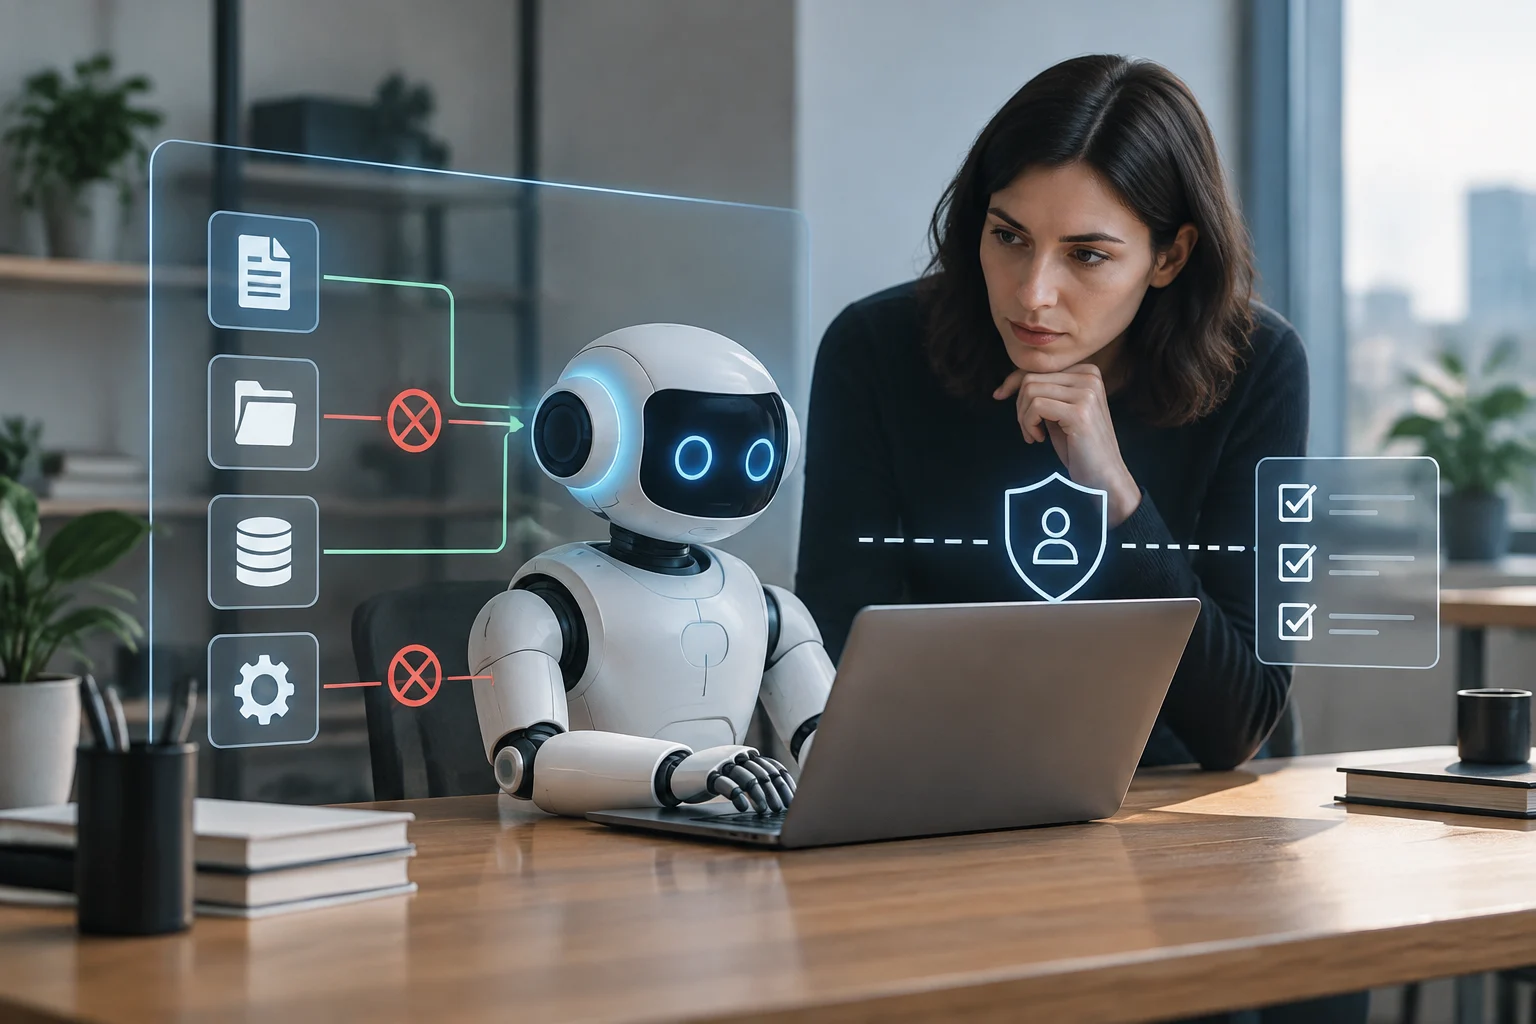
Un outil étend les capacités d'un modèle, par exemple en lui permettant de récupérer des informations ou d'exécuter une action. Un agent désigne généralement un système où un modèle dirige dynamiquement ses étapes et l'utilisation d'outils pour accomplir une tâche. Le terme s'applique aussi aux systèmes à flux prédéfinis, si bien que sa signification peut varier selon le contexte.
Flux de travail et autonomie
Un flux de travail organise les modèles et les outils via des étapes définies à l'avance. Dans un agent, le modèle peut décider dynamiquement quelles actions effectuer et quels outils utiliser. La différence pratique réside dans qui détermine les étapes ; les actions possibles dépendent des outils et des permissions intégrés au système.
Plus un système a de capacités d'action, plus il est important de vérifier ses permissions et ses points de contrôle. Pour les opérations sensibles, il est conseillé de restreindre l'accès aux comptes et aux données et de demander une confirmation avant d'envoyer, de publier, d'acheter ou de supprimer. Un agent peut se tromper ou enchaîner les erreurs ; l'étiquette n'atteste pas d'une autonomie fiable ni ne remplace la supervision.
IA générative et systèmes multimodaux
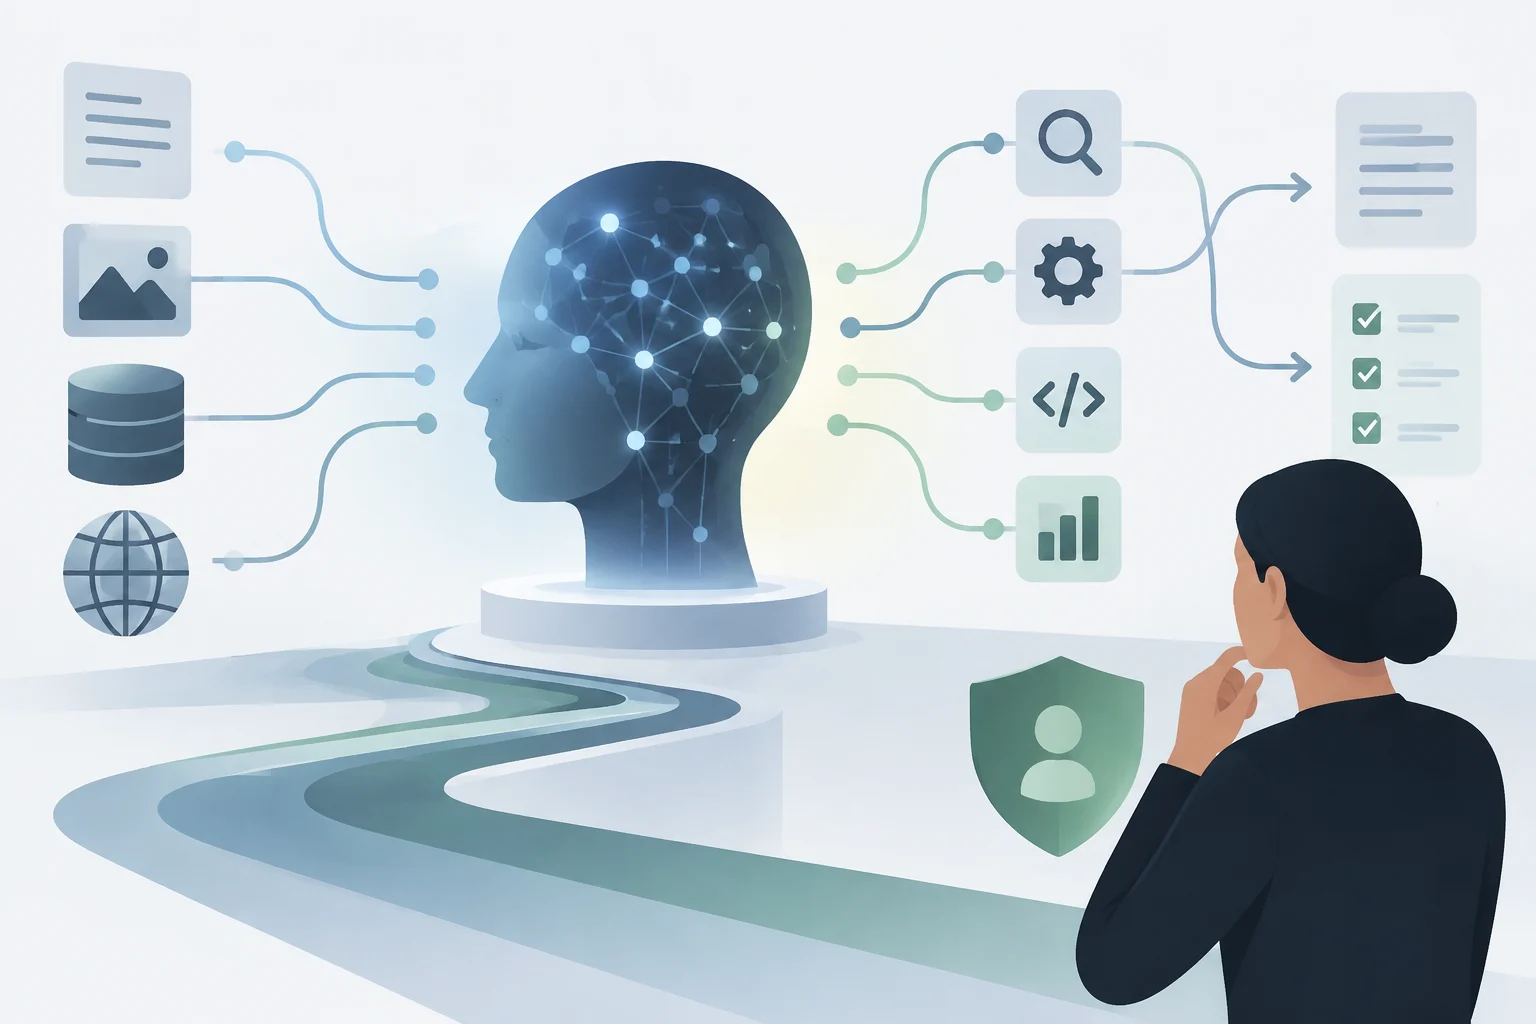
L'IA générative produit du contenu — par exemple, du texte, des images, de l'audio ou de la vidéo — à partir de motifs appris dans les données et d'une entrée. D'autres systèmes d'apprentissage automatique peuvent se concentrer sur la classification ou la prédiction d'une valeur, comme déterminer si une image appartient à une catégorie.
Un système multimodal peut traiter plus d'un type de contenu, comme du texte et des images. Par exemple, certains modèles acceptent une image accompagnée d'une question écrite. Les formats pris en charge dépendent du modèle : la documentation de Transformers décrit des modèles recevant du texte et des images, ainsi que certains acceptant de la vidéo.
La multimodalité ne signifie pas non plus multitâche ni accès automatique à Internet. Un système peut combiner image et texte sans connexion au web, ou effectuer plusieurs tâches exclusivement avec du texte. Pour évaluer une fonction, il faut vérifier les formats acceptés, les résultats générés et les services externes, s'il y en a, qu'il peut consulter.
Hallucinations, biais et évaluation
Hallucination ou confabulation
On appelle hallucination — ou confabulation — une réponse erronée ou fausse que le système présente avec assurance, ou qui n'est pas étayée par le contexte fourni. Un exemple hypothétique serait d'attribuer une affirmation à une référence inexistante. La fluidité n'est pas une preuve d'exactitude ; il convient de vérifier les citations, les noms, les dates et les affirmations importantes.
Biais, évaluation et benchmark
Un biais est une tendance systématique pouvant affecter les sorties ou leurs conséquences. Dans les systèmes d'IA, il peut se manifester par des différences de performance entre groupes ou par des résultats reproduisant des biais présents dans les données. C'est pourquoi il ne suffit pas de tester une requête générale : il importe d'observer comment le système répond aux cas et groupes pertinents pour l'usage prévu.
Un benchmark permet de mesurer et de comparer la performance des modèles via des métriques appliquées à des tâches ou des ensembles de données. Les métriques appropriées dépendent de la tâche et des données évaluées.
Pour évaluer un outil, utilisez des exemples représentatifs de votre tâche et vérifiez l'exactitude, les erreurs, les limites, l'accessibilité et le coût le cas échéant. Distinguez le résultat mesuré lors d'un test de la performance en usage quotidien : le premier décrit des conditions spécifiques, il ne garantit pas le second. Aucune vérification isolée n'élimine tous les risques.
Confidentialité, données, droits d'auteur et licences
Données et confidentialité
L'inférence décrit comment un modèle produit une sortie à partir d'une entrée, mais ne détermine pas à elle seule le traitement des données personnelles. Avant de partager des informations, vérifiez les données demandées par le service et les contrôles qu'il offre.
En guise de précaution, évitez d'inclure des données personnelles ou sensibles lorsqu'elles ne sont pas nécessaires et utilisez des exemples fictifs lors des tests de fonctionnalités.
Droits d'auteur et licence
L'Office of the United States Copyright Office analyse la protection des œuvres créées avec l'intelligence artificielle et le rôle de la contribution humaine. Dans son rapport sur les résultats générés par l'IA, il examine l'auteurship humain et le degré de contrôle créatif qu'une personne peut apporter.
Aux États-Unis, l'Office of the United States Copyright Office conclut que la protection des résultats générés par l'IA dépend de la contribution humaine et doit être analysée au cas par cas. Son rapport indique que les instructions, à elles seules, ne suffisent pas à déterminer l'auteurship. Cette analyse relève du cadre juridique américain, et non d'une règle mondiale.
Différences essentielles en un coup d'œil
| Concepts | Différence pratique |
|---|---|
| Modèle / application | Le modèle est un système entraîné sur des données pour prédire ou générer ; une application peut utiliser ses prédictions. |
| Entraînement / inférence | Entraîner ajuste le modèle ; inférer l'utilise pour générer une sortie. |
| Jeton / mot | Le jeton est une unité du tokeniseur et peut être un mot, une partie de mot ou un autre fragment. |
| Contexte / mémoire | Le contexte regroupe les informations incluses pour la génération ; la mémoire peut être une capacité supplémentaire du système. |
| RAG / fine-tuning | Le RAG récupère des informations pour les ajouter au contexte ; le fine-tuning réentraîne le modèle pour l'adapter. |
| Agent / flux | Un agent peut décider des étapes et des outils ; un flux suit des étapes prédéfinies. |
| Multimodal / multitâche | Multimodal concerne les types de données ; multitâche, les différentes tâches. |
| Benchmark / résultat réel | Un benchmark mesure dans des conditions concrètes ; il ne garantit pas la performance dans tout usage. |
Pour décider si un outil vous convient, clarifiez quel modèle ou quelles fonctions il utilise, quelles données vous devez envoyer, quels documents ou services il peut consulter, quelles actions il est autorisé à exécuter et quelles conditions de confidentialité et de droits s'appliquent. Si une réponse affecte une décision importante, vérifiez l'information dans une source appropriée plutôt que de prendre sa sécurité ou sa fluidité pour garantie.