Modelo y datos: qué sistema estás usando
Modelo y aplicación
Un modelo de aprendizaje automático es un sistema computacional entrenado con datos para hacer predicciones o generar contenido. No es una pieza de hardware: es el sistema que realiza esas tareas.
Parámetros y datos de entrenamiento
Los parámetros son valores numéricos que forman parte de un modelo de aprendizaje automático. En los modelos de lenguaje, el sistema utiliza estos valores para estimar probabilidades de secuencias de tokens y producir predicciones o texto.
Un modelo puede producir respuestas coherentes al aprovechar patrones estadísticos aprendidos, pero esa capacidad no demuestra que tenga conciencia o comprensión humana. Conviene distinguir conducta lingüística convincente de conocimiento comprobado: una respuesta bien redactada todavía puede contener errores.
Entrenamiento, inferencia y ajuste fino
Entrenamiento e inferencia
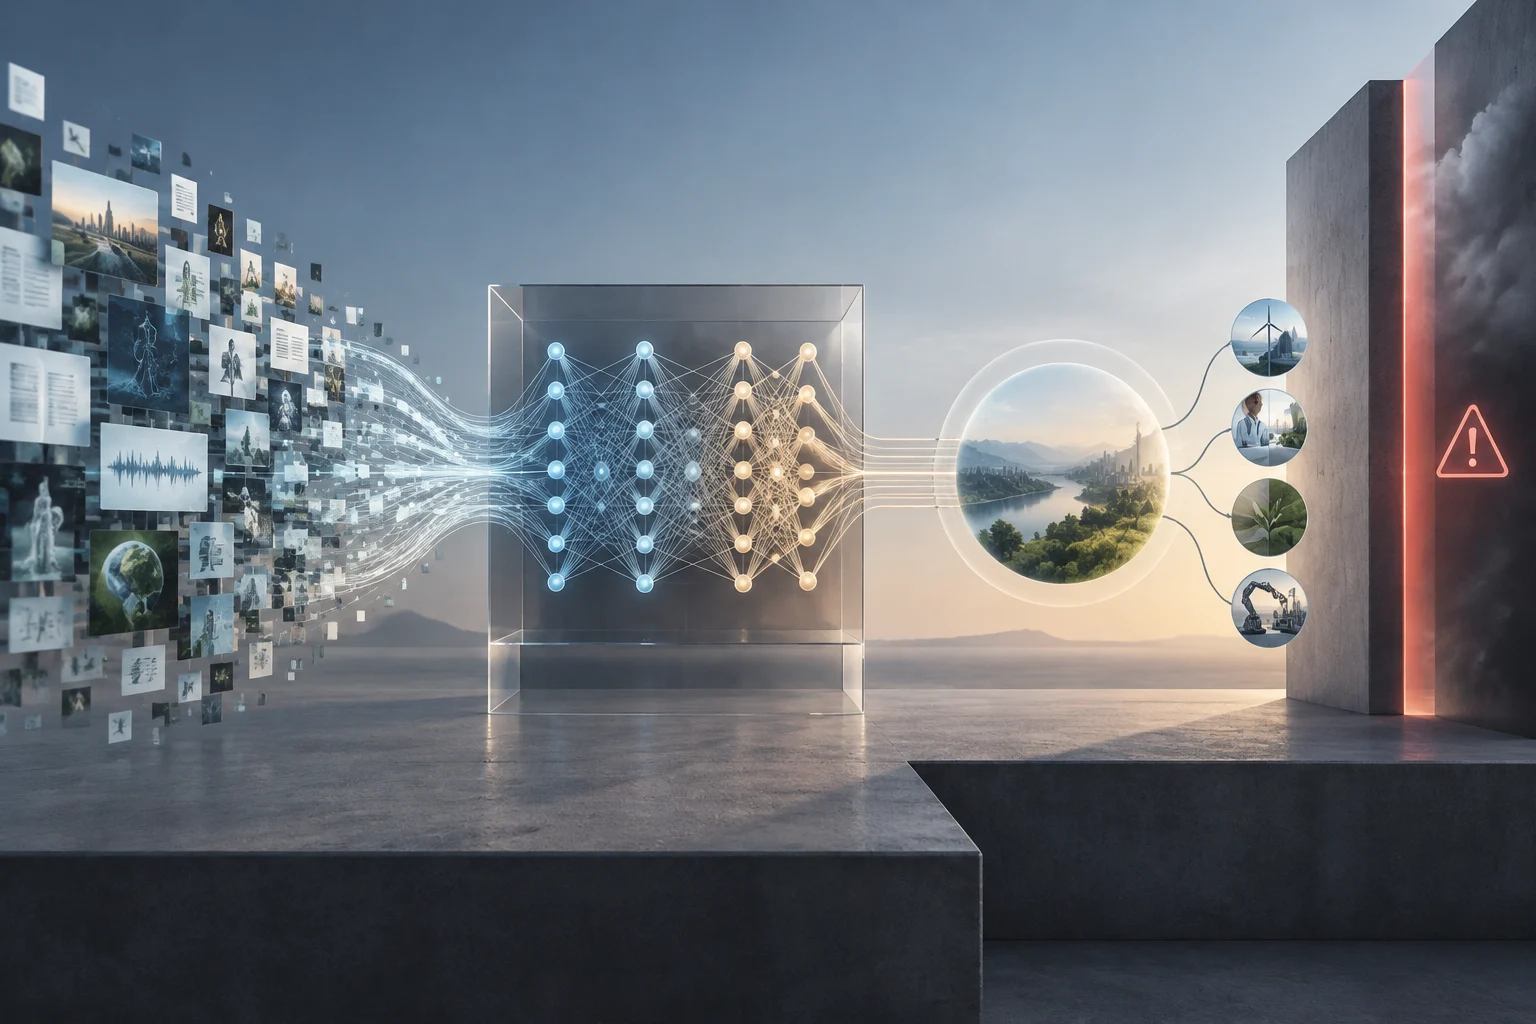
El entrenamiento es el proceso de ajustar un modelo con datos. La inferencia es la generación de una salida o una predicción mediante un modelo ya entrenado, a partir de una entrada. Cuando una persona hace una pregunta a un chatbot, está usando el modelo para obtener una respuesta; el ajuste fino, en cambio, requiere entrenamiento adicional.
¿Qué significa ajuste fino?
El ajuste fino (fine-tuning) es entrenamiento adicional que adapta un modelo a una tarea o a un tipo de datos determinados. No es lo mismo que añadir una instrucción a una conversación. Escribir «resume este texto» cambia la petición que recibe el sistema; las instrucciones pueden personalizar la salida sin cambiar los parámetros del modelo.
La separación también importa al evaluar privacidad: inferencia describe cómo se obtiene una salida, no qué hará el proveedor con los datos enviados después. Uso en la consulta y tratamiento posterior son preguntas distintas; para saber si se guardan entradas o registros, hay que revisar las condiciones, ajustes y políticas del servicio concreto.
LLM, tokens, contexto y memoria
LLM y tokenizador
LLM es la sigla inglesa de Large Language Model, o modelo de lenguaje grande: un modelo que estima la probabilidad de tokens o secuencias de tokens y puede utilizarse para generar texto. Un token puede ser una palabra, una parte de palabra o un carácter, según el método de segmentación. El tokenizador convierte el texto en tokens y luego en identificadores numéricos que el modelo puede procesar. No hay una equivalencia universal entre token, palabra y carácter; la segmentación también varía según el idioma.
Ventana de contexto y memoria
La ventana de contexto es el conjunto limitado de tokens que se incluye cuando un modelo de lenguaje genera una salida. Puede reunir instrucciones, historial de mensajes, herramientas y datos externos. Gestionar ese contexto implica seleccionar la información que se proporciona al modelo; con contextos extensos, su capacidad para recuperar datos con precisión puede disminuir.
La memoria puede ser una capacidad añadida a un modelo, junto con herramientas o recuperación de información; su funcionamiento depende del sistema que la incorpora. Contexto presente no equivale a recuerdo permanente, y recuperar información no es lo mismo que reentrenar el modelo.
Prompt: pedir una tarea con contexto
Un prompt es una entrada que puede incluir instrucciones y ejemplos para orientar la respuesta de un modelo. Por ejemplo: «Resume este texto ficticio en tres viñetas y señala qué dato queda sin aclarar». Es una forma de personalizar la salida, no una fórmula que garantice un resultado correcto.
Las instrucciones ayudan a precisar la tarea y a orientar la respuesta, pero no aseguran que sea correcta. Incluir ejemplos también puede ayudar a mostrar el tipo de salida esperado. La calidad depende de cómo se organiza el contexto y de la capacidad del modelo para realizar la tarea.
Embeddings, búsqueda semántica y RAG
Embeddings y búsqueda semántica
Un embedding es una representación numérica de datos. En una búsqueda semántica, los embeddings pueden representar elementos para compararlos según relaciones aprendidas, como la similitud entre conceptos.
RAG: recuperar antes de responder
RAG significa Retrieval-Augmented Generation, o generación aumentada por recuperación. El sistema recupera información de una fuente externa y la añade al contexto que recibe el modelo para generar una respuesta. Así puede incorporar datos externos sin volver a entrenarlo. La recuperación puede utilizar distintos métodos, incluida la búsqueda semántica.
RAG puede aportar documentos que no formaban parte del contexto original del modelo sin volver a entrenarlo ni cambiar sus parámetros. Eso lo distingue del fine-tuning. Sin embargo, recuperar un pasaje no asegura interpretarlo bien: la respuesta todavía puede resumirlo de forma incorrecta, omitir una condición o combinarlo con información que no está en el documento. Comprobar la referencia y el fragmento relevante sigue siendo útil.
Agentes, herramientas y flujos de trabajo
Herramientas y agentes
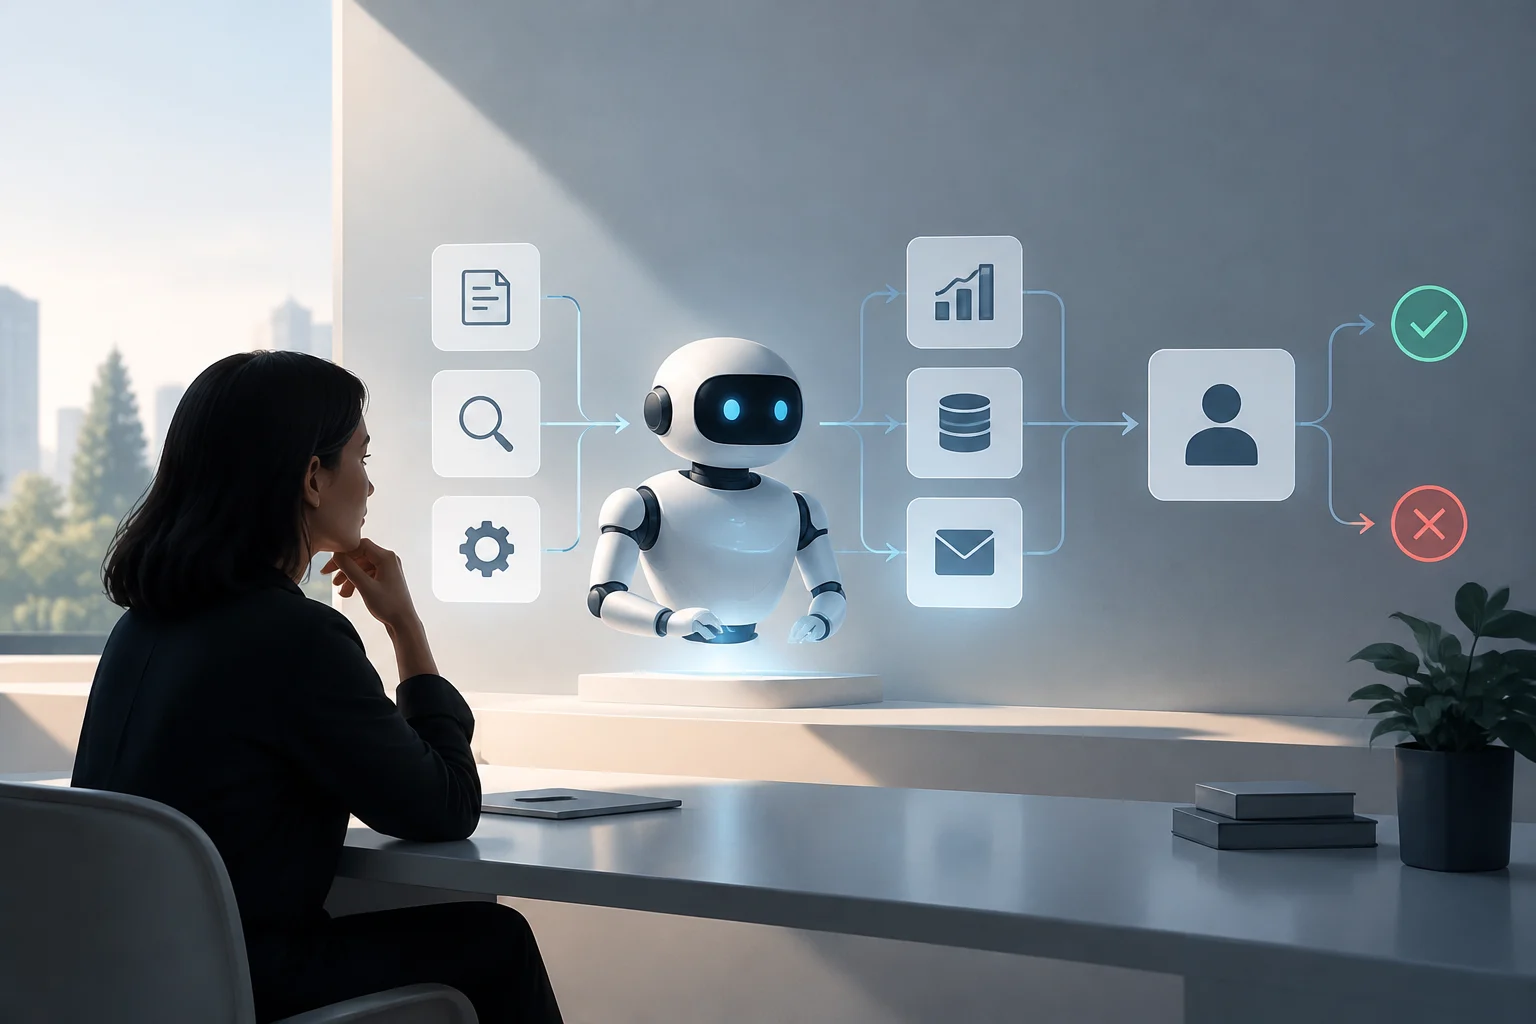
Una herramienta amplía las capacidades de un modelo, por ejemplo, al permitirle recuperar información o ejecutar una acción. Un agente suele referirse a un sistema en el que un modelo dirige dinámicamente sus pasos y el uso de herramientas para cumplir una tarea. El término también se aplica a sistemas con flujos predefinidos, por lo que su significado puede variar según el contexto.
Flujo de trabajo y autonomía
Un flujo de trabajo organiza modelos y herramientas mediante pasos definidos de antemano. En un agente, el modelo puede decidir dinámicamente qué acciones realizar y qué herramientas utilizar. La diferencia práctica está en quién determina los pasos; las acciones posibles dependen de las herramientas y permisos integrados en el sistema.
Cuanta más capacidad de acción tenga un sistema, más importante es revisar sus permisos y puntos de control. Para operaciones sensibles, conviene restringir el acceso a cuentas y datos y pedir confirmación antes de enviar, publicar, comprar o borrar algo. Un agente puede equivocarse o encadenar errores; la etiqueta no acredita autonomía fiable ni sustituye la supervisión.
IA generativa y sistemas multimodales
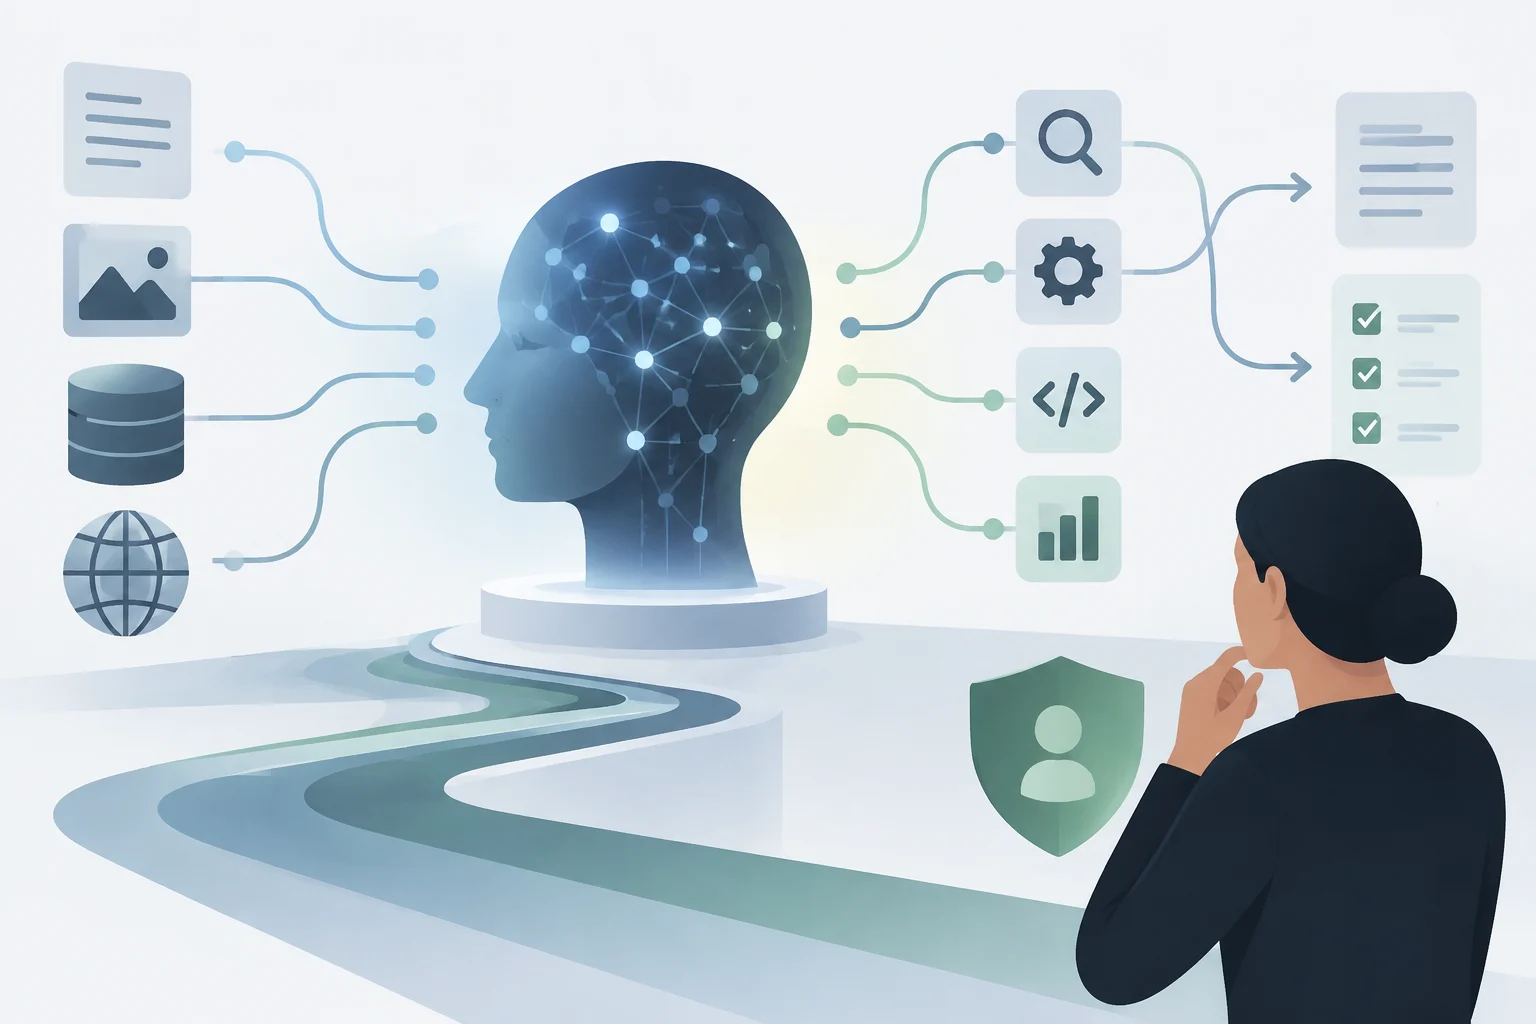
La IA generativa produce contenido —por ejemplo, texto, imágenes, audio o video— a partir de patrones aprendidos en datos y de una entrada. Otros sistemas de aprendizaje automático pueden centrarse en clasificar algo o predecir un valor, como determinar si una imagen pertenece a una categoría.
Un sistema multimodal puede procesar más de un tipo de contenido, como texto e imágenes. Por ejemplo, algunos modelos aceptan una imagen junto con una pregunta escrita. Los formatos admitidos dependen del modelo: la documentación de Transformers describe modelos que reciben texto e imágenes, y también algunos que admiten video.
Multimodalidad tampoco significa multitarea ni acceso automático a Internet. Un sistema puede combinar imagen y texto sin tener conexión a la web, o realizar varias tareas exclusivamente con texto. Para evaluar una función, hay que comprobar qué formatos acepta, qué resultados genera y qué servicios externos, si los hay, puede consultar.
Alucinaciones, sesgos y evaluación
Alucinación o confabulación
Se llama alucinación —también confabulación— a una respuesta errónea o falsa que el sistema presenta con seguridad, o que no está respaldada por el contexto aportado. Un ejemplo hipotético sería atribuir una afirmación a una referencia inexistente. La fluidez no es una prueba de exactitud; conviene verificar citas, nombres, fechas y afirmaciones importantes.
Sesgo, evaluación y benchmark
Un sesgo es una tendencia sistemática que puede afectar las salidas o sus consecuencias. En los sistemas de IA, puede reflejarse en diferencias de desempeño entre grupos o en resultados que reproduzcan sesgos presentes en los datos. Por eso, no basta con probar una consulta general: importa observar cómo responde el sistema ante casos y grupos pertinentes para el uso previsto.
Un benchmark permite medir y comparar el desempeño de modelos mediante métricas aplicadas a tareas o conjuntos de datos. Las métricas adecuadas dependen de la tarea y de los datos evaluados.
Para valorar una herramienta, usa ejemplos representativos de tu tarea y comprueba exactitud, errores, límites, accesibilidad y coste según corresponda. Separa resultado medido en una prueba de desempeño en el uso cotidiano: el primero describe condiciones específicas, no garantiza el segundo. Ninguna comprobación aislada elimina todos los riesgos.
Privacidad, datos, derechos de autor y licencias
Datos y privacidad
La inferencia describe cómo un modelo produce una salida a partir de una entrada, pero no determina por sí misma el tratamiento de los datos personales. Antes de compartir información, comprueba qué datos solicita el servicio y qué controles ofrece.
Como precaución, evita incluir datos personales o sensibles cuando no sean necesarios y usa ejemplos ficticios al probar funciones.
Derechos de autor y licencia
La Oficina de Derechos de Autor de Estados Unidos analiza la protección de obras creadas con inteligencia artificial y el papel de la contribución humana. En su informe sobre los resultados generados con IA, examina la autoría humana y el grado de control creativo que puede aportar una persona.
En Estados Unidos, la Oficina de Derechos de Autor concluye que la protección de los resultados generados con IA depende de la contribución humana y debe analizarse caso por caso. Su informe señala que las instrucciones, por sí solas, no bastan para determinar la autoría. Este análisis corresponde al marco jurídico estadounidense, no a una regla mundial.
Diferencias esenciales de un vistazo
| Conceptos | Diferencia práctica |
|---|---|
| Modelo / aplicación | El modelo es un sistema entrenado con datos para hacer predicciones o generar contenido; una aplicación puede utilizar sus predicciones. |
| Entrenamiento / inferencia | Entrenar ajusta el modelo; inferir lo usa para generar una salida. |
| Token / palabra | El token es una unidad del tokenizador y puede ser una palabra, parte de ella u otro fragmento. |
| Contexto / memoria | El contexto reúne información incluida para que el modelo genere una salida; la memoria puede ser una capacidad adicional de un sistema. |
| RAG / ajuste fino | RAG recupera información para añadirla al contexto; el ajuste fino vuelve a entrenar el modelo para adaptarlo. |
| Agente / flujo | Un agente puede decidir pasos y herramientas; un flujo sigue pasos definidos de antemano. |
| Multimodal / multitarea | Multimodal alude a tipos de datos; multitarea, a tareas diferentes. |
| Benchmark / resultado real | Un benchmark mide bajo condiciones concretas; no garantiza el desempeño en cualquier uso. |
Para decidir si una herramienta te sirve, aclara qué modelo o funciones utiliza, qué datos necesitas enviar, qué documentos o servicios puede consultar, qué acciones tiene permiso para ejecutar y qué condiciones de privacidad y derechos se aplican. Si una respuesta afecta una decisión importante, comprueba la información en una fuente adecuada en vez de tomar su seguridad o su fluidez como garantía.