Modello e dati: quale sistema stai usando
Modello e applicazione
Un modello di apprendimento automatico è un sistema informatico addestrato con dati per fare previsioni o generare contenuti. Non è un componente hardware: è il sistema che svolge queste attività.
Parametri e dati di addestramento
I parametri sono valori numerici che fanno parte di un modello di apprendimento automatico. Nei modelli linguistici, il sistema usa questi valori per stimare le probabilità di sequenze di token e produrre previsioni o testo.
Un modello può generare risposte coerenti sfruttando schemi statistici appresi, ma questo non dimostra che abbia coscienza o comprensione umana. È utile distinguere una produzione linguistica convincente da una conoscenza verificata: una risposta ben formulata può comunque contenere errori.
Addestramento, inferenza e fine-tuning
Addestramento e inferenza
L’addestramento è il processo con cui si adatta un modello usando dati. L’inferenza consiste nel generare un risultato o una previsione con un modello già addestrato, a partire da un input. Quando una persona pone una domanda a un chatbot, usa il modello per ottenere una risposta; il fine-tuning, invece, richiede ulteriore addestramento.
Che cosa significa fine-tuning?
Il fine-tuning, o adattamento fine, è un addestramento aggiuntivo che adatta un modello a un’attività o a un tipo di dati specifici. Non equivale ad aggiungere un’istruzione alla conversazione. Scrivere «riassumi questo testo» modifica la richiesta ricevuta dal sistema; le istruzioni possono personalizzare il risultato senza cambiare i parametri del modello.
Questa distinzione conta anche quando si valuta la privacy: l’inferenza descrive come si ottiene un risultato, non che cosa farà poi il fornitore con i dati inviati. Uso durante la richiesta e trattamento successivo sono aspetti distinti; per sapere se input o registri vengono conservati, occorre controllare condizioni, impostazioni e politiche del servizio specifico.
LLM, token, contesto e memoria
LLM e tokenizzatore
LLM è l’acronimo inglese di Large Language Model, cioè modello linguistico di grandi dimensioni: un modello che stima la probabilità di token o sequenze di token e può essere usato per generare testo. Un token può corrispondere a una parola, a una parte di parola o a un carattere, a seconda del metodo di segmentazione. Il tokenizzatore trasforma il testo in token e poi in identificatori numerici che il modello può elaborare. Non esiste un’equivalenza universale tra token, parola e carattere; la segmentazione varia anche in base alla lingua.
Finestra di contesto e memoria
La finestra di contesto è l’insieme limitato di token fornito a un modello linguistico quando genera un risultato. Può includere istruzioni, cronologia dei messaggi, strumenti e dati esterni. Gestire il contesto significa selezionare le informazioni da presentare al modello; con contesti molto estesi, la capacità di recuperare dati con precisione può diminuire.
La memoria può essere una funzionalità aggiunta a un modello, insieme a strumenti o sistemi di recupero delle informazioni; il suo funzionamento dipende dal sistema che la integra. Il contesto presente non equivale a un ricordo permanente, e recuperare informazioni non significa riaddestrare il modello.
Prompt: formulare una richiesta con il contesto
Un prompt è un input che può includere istruzioni ed esempi per orientare la risposta di un modello. Per esempio: «Riassumi questo testo fittizio in tre punti e indica quale dato resta da chiarire». È un modo per personalizzare il risultato, non una formula che ne garantisce la correttezza.
Le istruzioni aiutano a precisare il compito e a orientare la risposta, ma non ne assicurano l’accuratezza. Anche gli esempi possono chiarire il tipo di risultato atteso. La qualità dipende da come viene organizzato il contesto e dalla capacità del modello di svolgere il compito.
Embedding, ricerca semantica e RAG
Embedding e ricerca semantica
Un embedding è una rappresentazione numerica di dati. Nella ricerca semantica, gli embedding possono rappresentare elementi e consentire di confrontarli in base a relazioni apprese, come la somiglianza tra concetti.
RAG: recuperare prima di rispondere
RAG significa Retrieval-Augmented Generation, cioè generazione aumentata dal recupero. Il sistema recupera informazioni da una fonte esterna e le aggiunge al contesto ricevuto dal modello per generare una risposta. In questo modo può integrare dati esterni senza riaddestrare il modello. Il recupero può avvalersi di metodi diversi, tra cui la ricerca semantica.
RAG può fornire documenti che non facevano parte del contesto iniziale del modello, senza riaddestrarlo né modificarne i parametri. Questo lo distingue dal fine-tuning. Tuttavia, recuperare un passaggio non garantisce di interpretarlo correttamente: la risposta può riassumerlo male, omettere una condizione o mescolarlo con informazioni che il documento non contiene. È quindi utile controllare la fonte e il passaggio pertinente.
Agenti, strumenti e flussi di lavoro
Strumenti e agenti
Uno strumento amplia le capacità di un modello, per esempio consentendogli di recuperare informazioni o eseguire un’azione. Di solito si parla di agente quando un modello dirige dinamicamente i propri passaggi e l’uso degli strumenti per completare un compito. Il termine si applica anche a sistemi con flussi predefiniti, quindi il suo significato può variare a seconda del contesto.
Flusso di lavoro e autonomia
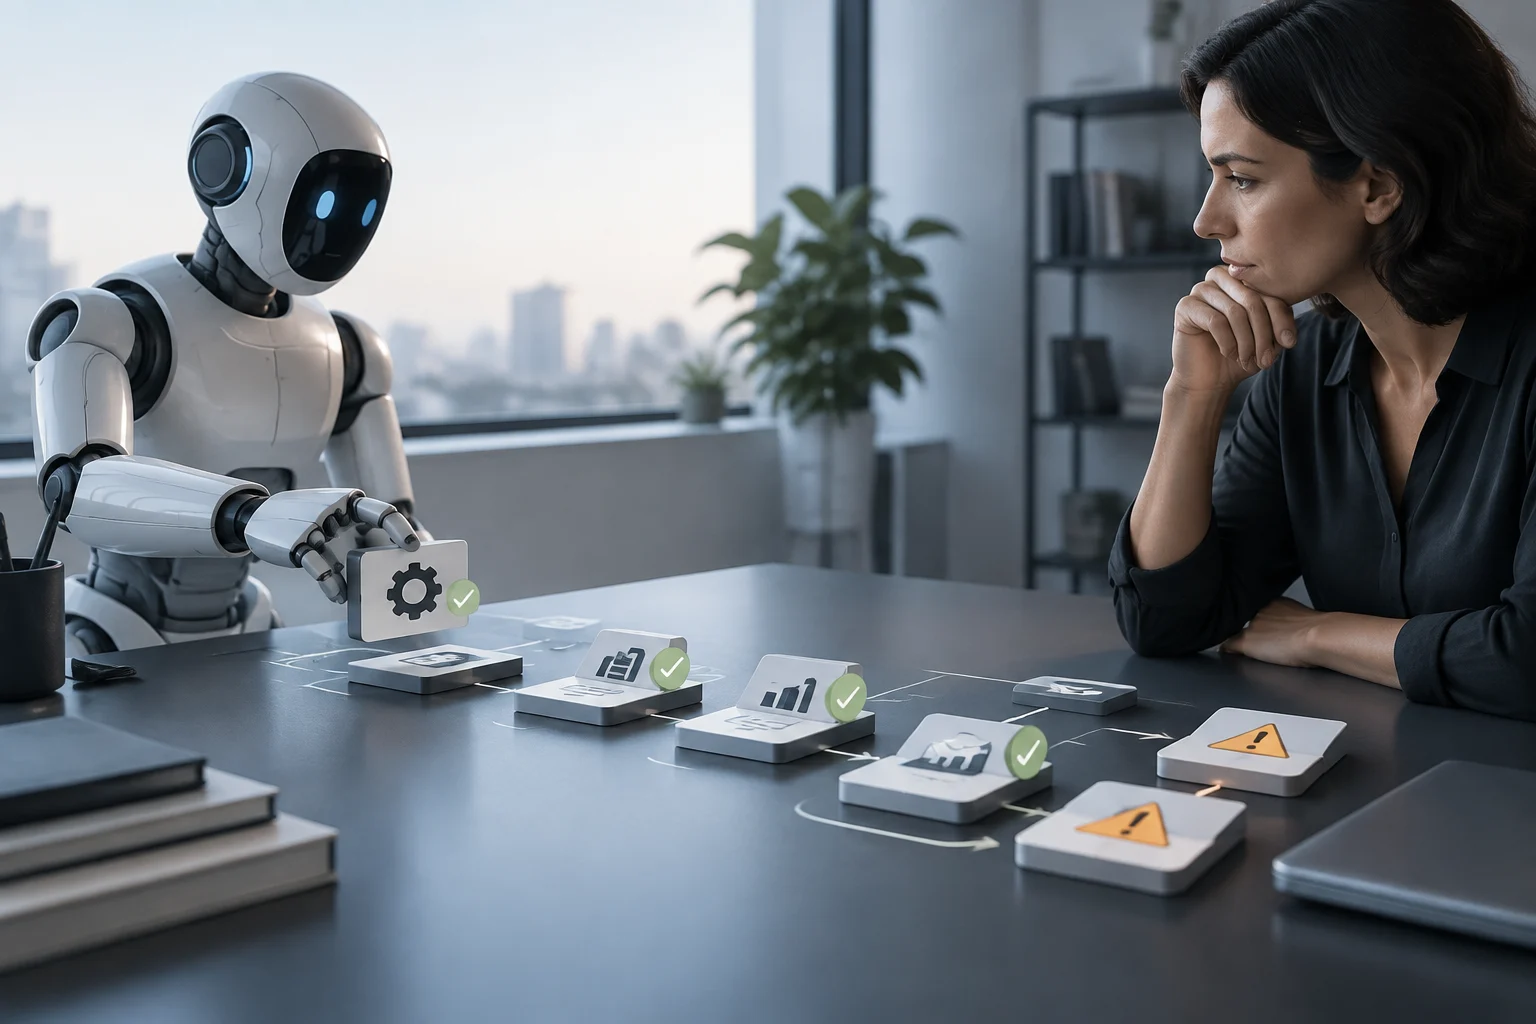
Un flusso di lavoro organizza modelli e strumenti in passaggi definiti in anticipo. In un agente, il modello può decidere dinamicamente quali azioni svolgere e quali strumenti utilizzare. La differenza pratica riguarda chi determina i passaggi; le azioni possibili dipendono dagli strumenti e dai permessi integrati nel sistema.
Quanto più un sistema può agire, tanto più è importante controllarne permessi e punti di verifica. Per le operazioni sensibili, è opportuno limitare l’accesso ad account e dati e richiedere una conferma prima di inviare, pubblicare, acquistare o cancellare qualcosa. Un agente può sbagliare o concatenare errori: l’etichetta non certifica un’autonomia affidabile e non sostituisce la supervisione.
IA generativa e sistemi multimodali
L’IA generativa produce contenuti — per esempio testo, immagini, audio o video — sulla base di schemi appresi dai dati e di un input. Altri sistemi di apprendimento automatico possono invece concentrarsi sulla classificazione o sulla previsione di un valore, come stabilire se un’immagine appartiene a una categoria.
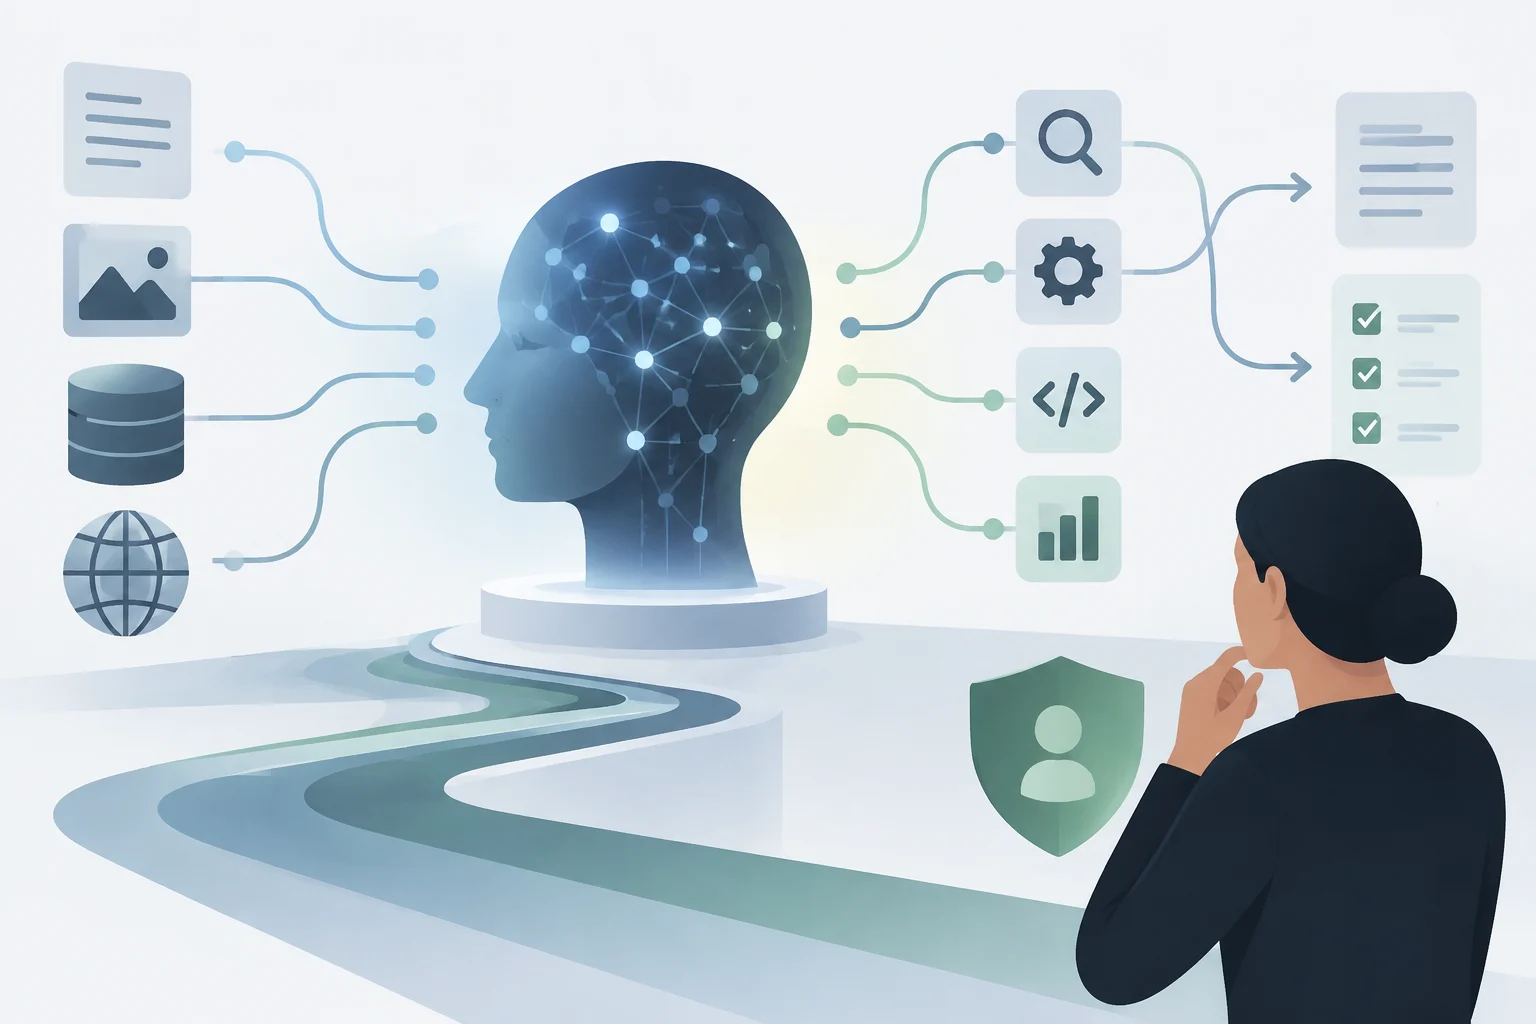
Un sistema multimodale può elaborare più di un tipo di contenuto, come testo e immagini. Per esempio, alcuni modelli accettano un’immagine insieme a una domanda scritta. I formati supportati dipendono dal modello: la documentazione di Transformers descrive modelli che ricevono testo e immagini e alcuni che supportano anche video.
La multimodalità non implica né la capacità di svolgere più compiti né l’accesso automatico a Internet. Un sistema può combinare immagini e testo senza collegarsi al web, oppure svolgere più compiti usando solo testo. Per valutare una funzione, occorre verificare quali formati accetta, quali risultati genera e a quali servizi esterni, se presenti, può accedere.
Allucinazioni, bias e valutazione
Allucinazione o confabulazione
Si parla di allucinazione — o confabulazione — quando il sistema presenta con sicurezza una risposta errata o falsa, oppure non supportata dal contesto fornito. Un esempio ipotetico è attribuire un’affermazione a una fonte inesistente. La fluidità non dimostra l’accuratezza: è opportuno verificare citazioni, nomi, date e affermazioni importanti.
Bias, valutazione e benchmark
Un bias è una tendenza sistematica che può influire sui risultati o sulle loro conseguenze. Nei sistemi di IA può manifestarsi come una differenza di prestazioni tra gruppi o come la riproduzione di distorsioni presenti nei dati. Per questo non basta provare una domanda generica: conta osservare come il sistema risponde a casi e gruppi pertinenti all’uso previsto.
Un benchmark misura e confronta le prestazioni dei modelli applicando metriche a compiti o insiemi di dati. Le metriche appropriate dipendono dall’attività e dai dati valutati.
Per valutare uno strumento, usa esempi rappresentativi del compito e controlla accuratezza, errori, limiti, accessibilità e costi, secondo necessità. Distingui un risultato misurato in una prova dalle prestazioni nell’uso quotidiano: il primo descrive condizioni specifiche, ma non garantisce il secondo. Nessuna singola verifica elimina tutti i rischi.
Privacy, dati, diritto d’autore e licenze
Dati e privacy
L’inferenza descrive come un modello produce un risultato a partire da un input, ma non determina di per sé come verranno trattati i dati personali. Prima di condividere informazioni, controlla quali dati richiede il servizio e quali strumenti di controllo offre.
Per precauzione, evita di inserire dati personali o sensibili quando non sono necessari e usa esempi fittizi per provare le funzioni.
Diritto d’autore e licenze
La US Copyright Office esamina la protezione delle opere create con l’intelligenza artificiale e il ruolo del contributo umano. Nel suo rapporto sui risultati generati dall’IA, analizza la paternità umana e il grado di controllo creativo che una persona può esercitare.
Negli Stati Uniti, la US Copyright Office conclude che la protezione dei risultati generati con l’IA dipende dal contributo umano e va valutata caso per caso. Il rapporto rileva che le sole istruzioni non bastano a determinare la paternità dell’opera. Questa analisi riguarda il quadro giuridico statunitense, non costituisce una regola mondiale.
Le differenze essenziali a colpo d’occhio
| Concetti | Differenza pratica |
|---|---|
| Modello / applicazione | Il modello è un sistema addestrato con dati per fare previsioni o generare contenuti; un’applicazione può utilizzare i suoi risultati. |
| Addestramento / inferenza | L’addestramento adatta il modello; l’inferenza lo usa per generare un risultato. |
| Token / parola | Il token è un’unità del tokenizzatore e può essere una parola, una sua parte o un altro frammento. |
| Contesto / memoria | Il contesto raccoglie le informazioni fornite al modello per generare un risultato; la memoria può essere una funzionalità aggiuntiva del sistema. |
| RAG / fine-tuning | RAG recupera informazioni e le aggiunge al contesto; il fine-tuning riaddestra il modello per adattarlo. |
| Agente / flusso | Un agente può decidere passaggi e strumenti; un flusso segue passaggi definiti in anticipo. |
| Multimodale / multitasking | Multimodale si riferisce ai tipi di dati; multitasking, ad attività diverse. |
| Benchmark / risultato reale | Un benchmark misura prestazioni in condizioni specifiche; non garantisce risultati in ogni situazione. |
Per capire se uno strumento fa al caso tuo, chiarisci quale modello o quali funzioni usa, quali dati devi inviare, quali documenti o servizi può consultare, quali azioni è autorizzato a compiere e quali condizioni si applicano a privacy e diritti. Se una risposta incide su una decisione importante, verifica le informazioni con una fonte adeguata anziché considerare la sicurezza o la fluidità della risposta una garanzia.