Was geräteinterne KI bedeutet
Geräteinterne KI verarbeitet eine Funktion der künstlichen Intelligenz auf dem Gerät, das sie nutzt, etwa auf einem Smartphone, Computer oder in einem Browser. Technisch führt das Modell dort die Inferenz aus: Es erhält eine Eingabe, berechnet ein Ergebnis und gibt es an die Anwendung zurück. Je nach Modell kann die Eingabe Text, ein Bild, Audio oder eine andere Datenart sein.
Der Begriff beschreibt den Ort der Berechnung, nicht die Art der Intelligenz des Systems oder dessen Hersteller. Es kann sich um ein herkömmliches maschinelles Lernmodell oder ein generatives Modell handeln, um eine kleine Funktion wie Texterkennung in einem Bild oder eine komplexere Sprachaufgabe. Die lokale Ausführung bedeutet für sich genommen nicht, dass der gesamte Dienst, die Anwendung oder ihre Daten vom Internet getrennt bleiben.
Geräteinterne KI bezeichnet Inferenz, die auf dem Gerät des Nutzers läuft. Eine Anwendung kann dabei lokale und serverseitige Verarbeitung kombinieren oder Anfragen an ein Cloud-Modell weiterleiten, etwa wenn das lokale Modell nicht verfügbar oder für eine Aufgabe nicht geeignet ist. Entscheidend ist daher der Datenweg der jeweiligen Funktion.
Wie ein Gerät eine Anfrage verarbeitet
Der grundlegende Ablauf beginnt, wenn eine Anwendung eine Eingabe vorbereitet – etwa einen Satz, der zusammengefasst, oder ein Bild, das beschrieben werden soll – und sie an ein lokal verfügbares Modell übergibt. Das Modell wandelt die Eingabe in mathematische Operationen um und erzeugt eine Antwort; die Anwendung zeigt sie an oder nutzt sie für eine Aufgabe. Die Inferenz findet auf dem Gerät statt, wenn die Berechnung nicht an einen Server ausgelagert werden muss.
Das Modell kann im Betriebssystem enthalten, separat heruntergeladen oder Teil der Anwendung sein. Eine Softwareschicht legt fest, wie es aufgerufen wird und welche Hardware-Ressourcen zum Einsatz kommen. Google beschreibt AICore unter Android beispielsweise als Systemdienst zwischen Anwendungen und Gemini Nano; die Plattform verwaltet den Zugang zum Modell und dessen Verteilung. Das ist ein Architekturbeispiel und keine Funktion, die jedes Smartphone bietet.
Auf Hardwareebene kann die CPU den allgemeinen Ablauf der Anwendung steuern und kompatible Modelle ausführen; die GPU kann parallele Berechnungen beschleunigen, während die NPU für bestimmte maschinelle Lernoperationen ausgelegt ist. Nicht jedes Modell nutzt die NPU: Das hängt vom Gerät, Betriebssystem, Modellformat und der Software ab. Unter Windows können Inferenzwerkzeuge einen kompatiblen Beschleuniger auswählen und in bestimmten Fällen auf CPU oder GPU zurückgreifen, wenn ein anderer Pfad nicht verfügbar ist.
Auch der verfügbare Speicher und die Darstellung des Modells spielen eine Rolle. Ein größeres Modell oder eine längere Eingabe kann mehr Speicher und Rechenzeit benötigen. Quantisierung verringert die numerische Genauigkeit der Modellgewichte, um bestimmte Modelle kompakter oder effizienter zu machen – möglicherweise auf Kosten der Qualität. Ein vorhandener Beschleuniger garantiert daher nicht, dass jedes Modell oder jede Funktion darauf mit guter Leistung läuft.
Lokale KI, Cloud-KI und hybride Inferenz
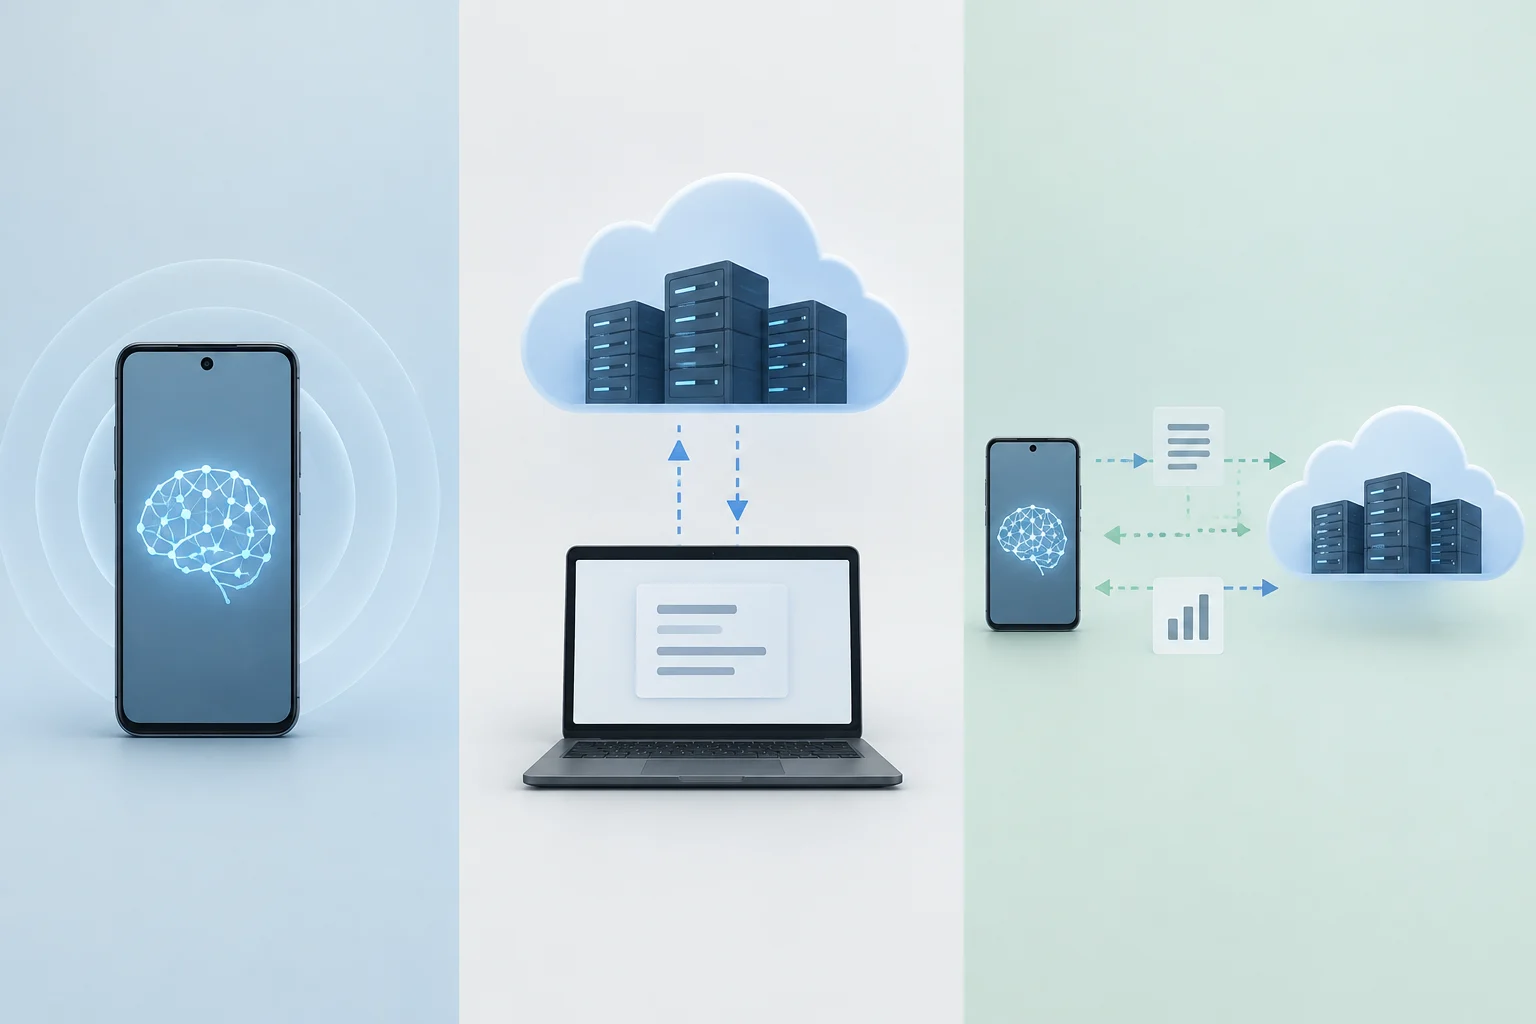
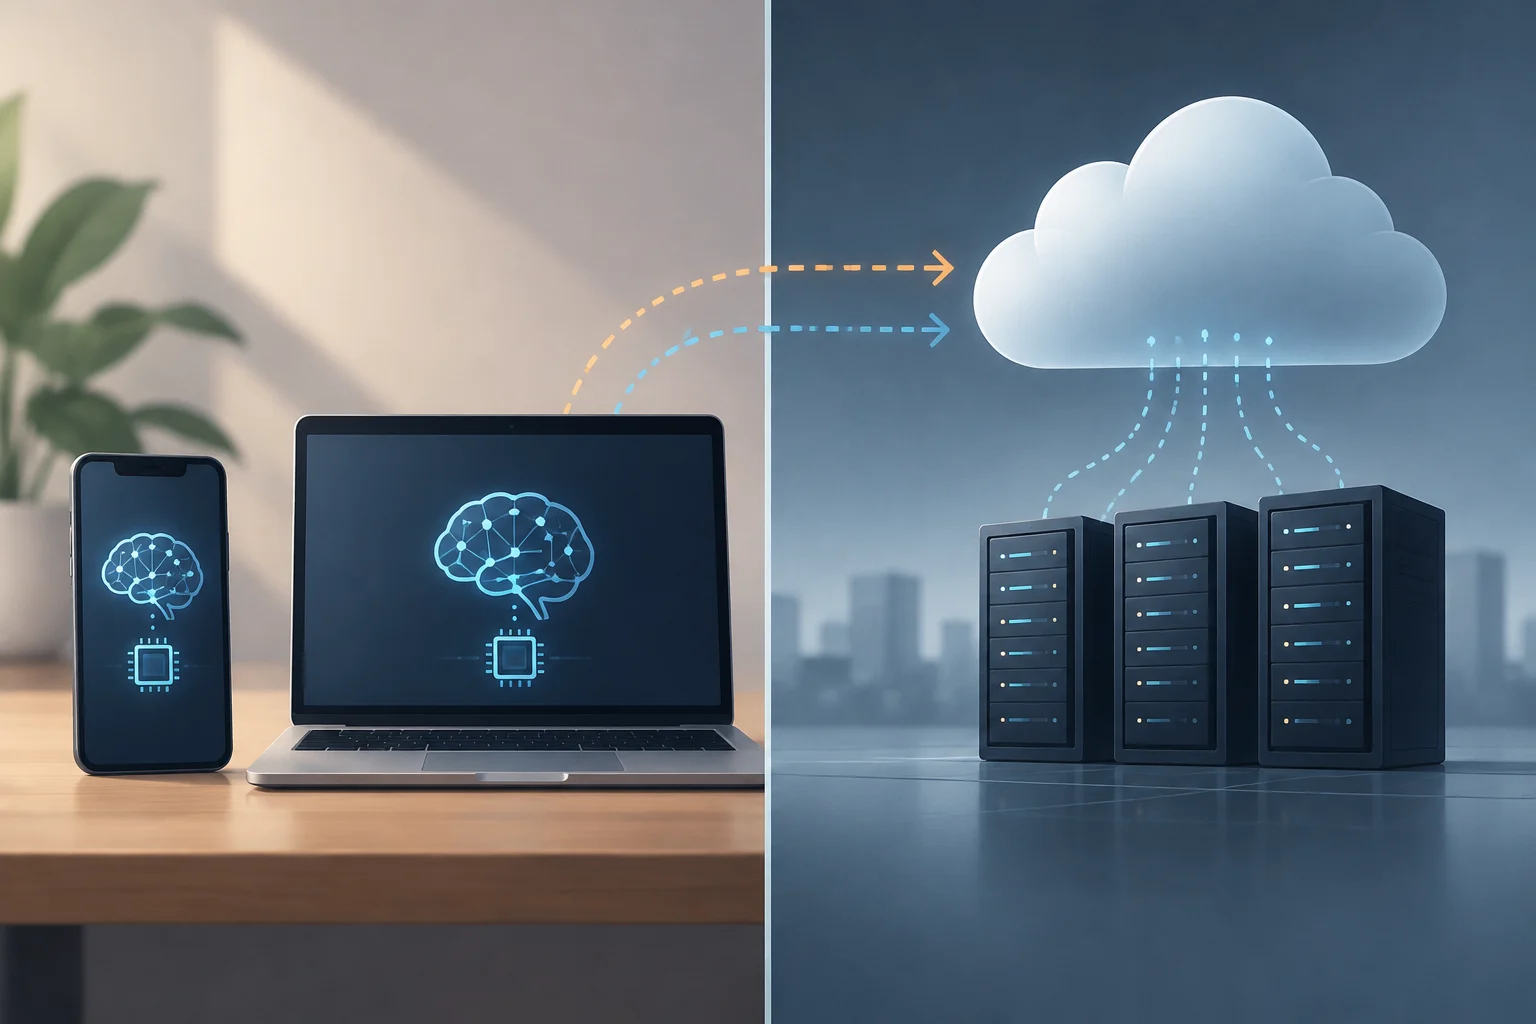
Der wesentliche Unterschied besteht darin, wo die Antwort berechnet wird. Bei einem lokalen Ablauf verarbeitet das Modell die Anfrage auf dem Gerät. Bei einem Cloud-Ablauf sendet die Anwendung Daten an einen entfernten Dienst, der das Modell ausführt und das Ergebnis zurückgibt. Eine hybride Architektur kann Schritte auf beide Seiten verteilen oder je nach Aufgabe und Geräteleistung einen Pfad auswählen.
| Aspekt | Verarbeitung auf dem Gerät | Verarbeitung in der Cloud |
|---|---|---|
| Ort der Berechnung | Auf dem Smartphone, Computer oder einem anderen Gerät des Nutzers | Auf den entfernten Servern des Anbieters |
| Verbindung für die Inferenz | Kann offline funktionieren, wenn Modell und Funktion bereits verfügbar sind | Erfordert normalerweise eine Verbindung zum Senden der Anfrage und Empfangen der Antwort |
| Mögliche Latenz | Vermeidet den Netzwerkweg, hängt aber von Hardware und Modell ab | Fügt zur entfernten Verarbeitung die Kommunikationszeit hinzu |
| Daten | Die Anfrage kann auf dem Gerät bleiben, wenn die Funktion entsprechend gestaltet ist | Gesendete Daten werden nach den Regeln und Richtlinien des Dienstes außerhalb des Geräts verarbeitet |
Die Tabelle zeigt Tendenzen, keine Garantien: Eine Anwendung kann Daten synchronisieren, Modelle herunterladen oder Telemetriedaten senden, auch wenn eine bestimmte Inferenz lokal erfolgt.
Hybride Inferenz verbindet beide Wege. Eine App kann zunächst eine lokale Antwort versuchen und ein entferntes Modell verwenden, wenn das lokale Modell nicht verfügbar ist, die Anfrage dessen Grenzen überschreitet oder eine gewünschte Funktion Online-Dienste benötigt. Die Android-Entwicklerdokumentation beschreibt eine solche Ausweichmöglichkeit: Bestimmte Anfragen können an Cloud-Modelle gesendet werden, wenn Gemini Nano nicht verfügbar oder nicht geeignet ist.
„Lokal“ und „Cloud“ sind für eine gesamte Anwendung also nicht immer ausschließliche Kategorien. Eine Funktion kann Text auf dem Gerät analysieren und das Ergebnis anschließend synchronisieren; eine andere kann für einfache Aufgaben ein lokales Modell und für komplexere Anfragen einen entfernten Dienst nutzen. Der Datenweg kann je nach Funktion variieren. Deshalb ist es sinnvoller, eine konkrete Operation zu betrachten, als der ganzen App ein einziges Etikett zu geben.
Welche Aufgaben lokal ausgeführt werden können
Für Geräte geeignete Aufgaben haben meist einen klar umrissenen Umfang und passen in die verfügbaren Ressourcen. Von Plattformen dokumentierte Beispiele sind das Transkribieren oder Übersetzen von Sprache, das Zusammenfassen kurzer Texte, das Umformulieren von Nachrichten, die Beschreibung von Bildern, die Texterkennung in einem Foto und die Erzeugung strukturierter Ergebnisse. Auch Systemfunktionen wie Handschrifterkennung oder Geräuschreduzierung bei Anrufen sind möglich.
Ein praktisches Beispiel ist Text aus einem Bild auszulesen. Die Kamera erfasst ein visuelles Signal, und ein Modell zur optischen Zeichenerkennung (OCR) identifiziert die Zeichen; die Anwendung kann den Text anzeigen oder kopierbar machen. Android bietet Texterkennungs-APIs, die Kamerabilder auf dem Gerät verarbeiten können. Benötigt die Funktion nur das Bild und das lokale Modell, kann sie arbeiten, ohne jede Aufnahme an einen entfernten Dienst zu senden – das konkrete Verhalten hängt jedoch von der jeweiligen App ab.
Ein für Android dokumentierter Anwendungsfall ist das Zusammenfassen von Sprachaufnahmen: Die Google Pixel Recorder App verwendet Gemini Nano, um Zusammenfassungen offline und auf dem Gerät zu erstellen. Unabhängig davon ermöglichen die generativen KI-APIs von ML Kit, gesprochene Audiodaten in Text umzuwandeln, Sprache zu übersetzen und aus Text Sprache zu erzeugen. Ob diese Funktionen verfügbar sind, hängt von der Anwendung und einem kompatiblen Gerät ab.
Weniger sichtbar sind Anwendungen wie das Klassifizieren von Inhalten oder das Finden von Dateien nach ihrer Bedeutung statt nur nach exakten Übereinstimmungen. Ein Modell kann numerische Darstellungen von Texten oder Bildern erzeugen – sogenannte Embeddings –, damit ein lokaler Index verwandte Elemente findet. In anderen Fällen interpretiert das System Bildschirminhalte, um passende Aktionen vorzuschlagen. Lokale Verarbeitung macht ein Ergebnis nicht automatisch richtig: Die Qualität hängt vom Modell und Kontext ab, und sensible Aufgaben können eine menschliche Prüfung erfordern.
Mögliche Vorteile und Leistungsgrenzen
Der unmittelbarste Vorteil lokaler Inferenz ist, einen Teil des Netzwerkwegs zu vermeiden: Wird eine Anfrage auf dem Gerät gelöst, muss die Antwort nicht warten, bis eine Anfrage den Server erreicht und zurückkommt. Das kann die Latenz verringern, garantiert aber keine schnelle Berechnung. Ein anspruchsvolles Modell kann auf einem leistungsschwachen Gerät länger brauchen als ein leistungsstarker entfernter Dienst.
Eine weitere Möglichkeit ist der Offline-Betrieb. Dafür müssen das Modell und die benötigten Komponenten bereits installiert sein, und die Funktion darf nicht von einer externen Anfrage abhängen. Der erste Download, eine Modellaktualisierung, die Dateisynchronisierung oder ein internetverbundenes Werkzeug können weiterhin eine Verbindung erfordern. „Kann offline funktionieren“ bedeutet nicht „braucht nie Internet“.
Die Hardware setzt konkrete Grenzen: Rechenleistung, Speicher, Speicherplatz, Temperatur und verfügbare Energie. Eine NPU kann kompatible Vorgänge beschleunigen und andere Ressourcen entlasten, beseitigt aber nicht den Aufwand für die Modellausführung. Bei längeren Aufgaben bleiben Stromverbrauch und Wärmeentwicklung relevant; Herstellerangaben allein lassen keine sicheren Rückschlüsse auf die Leistung jeder Anwendung oder Arbeitslast zu.
Auch Größe und Leistungsfähigkeit des Modells bestimmen, was es leisten kann. Ein kompaktes Modell kann eng umrissene Aufgaben schnell erledigen, bei langen Anweisungen, umfangreichem Kontext oder komplexen Fragen aber weniger leistungsfähig sein. Google nennt für Gemini Nano Grenzen bei Hardware, Token und Modellkapazität und schlägt hybride Inferenz vor, wenn ein größerer Umfang erforderlich ist. Die praktische Wahl besteht darin, das lokale Modell einzusetzen, wenn es die Aufgabe mit den verfügbaren Ressourcen gut bewältigt, und den entfernten Weg Funktionen vorzubehalten, die ihn tatsächlich benötigen.
Datenschutz und Sicherheit: Was gewährleistet ist und was nicht
Lokale Verarbeitung kann die Menge an Informationen verringern, die eine Funktion übertragen muss: Wird eine Anfrage auf dem Gerät gelöst, muss die Eingabe für diese Inferenz nicht an einen Server gesendet werden. Das ist eine Eigenschaft des Datenwegs, keine allgemeine Datenschutzbescheinigung. Die Anwendung kann weiterhin andere Daten übertragen, Inhalte synchronisieren, Aktivitäten protokollieren oder für andere Funktionen entfernte Dienste nutzen.
Datenschutzerklärung, Anwendungskontrollen und Systemeinstellungen bestimmen, welche Daten zu welchen Zwecken erhoben werden. Ebenso wichtig ist, wo Eingaben, Ausgaben und temporäre Daten gespeichert werden, wer darauf zugreifen kann und ob die Anwendung sie nach der Verarbeitung behält. Bei einer sensiblen Entscheidung sollten Berechtigungen, Funktionseinstellungen und die Richtlinien des Anbieters geprüft werden; außerdem sollte klar sein, ob sich die Funktion deaktivieren oder ihre Daten löschen lassen.
Lokale Verarbeitung schließt Risiken durch schädliche Anwendungen, kompromittierte Geräte, unbefugten Kontozugriff oder fehlerhafte Modellausgaben nicht aus. Lokal bedeutet nicht automatisch sicher – ebenso wenig macht eine Cloud-Verbindung einen Dienst von sich aus unsicher.
Einige Plattformen bieten funktionsbezogene Kontrollen. Microsofts Dokumentation zu Recall beschreibt beispielsweise verschlüsselte lokale Speicherung, eine freiwillige Aktivierung und Möglichkeiten, Daten anzuhalten oder zu löschen. Diese Bedingungen gelten für die betreffende Funktion und lassen sich nicht auf alle geräteinternen KI-Funktionen übertragen. Wichtig ist zu klären, welche Daten eine Funktion verarbeitet, wo sie sie speichert, ob sie das Gerät verlassen und welche Kontrollmöglichkeiten der Nutzer hat.
So bewerten Sie eine Funktion vor der Nutzung
Die Bezeichnung „geräteinterne KI“ kann eine erste Orientierung geben; entscheidend ist jedoch das Verhalten der konkreten Funktion. Prüfen Sie praktisch, welche Eingaben verarbeitet werden, welche Schritte lokal stattfinden und was ohne Netzwerkverbindung geschieht. Achten Sie außerdem darauf, ob Daten gespeichert, geteilt oder synchronisiert werden.
Eine praktische Prüfung kann sich auf vier Fragen konzentrieren: Welche Eingabe wird verarbeitet? Welche Teile laufen lokal? Was geschieht ohne Verbindung? Welche Daten werden gespeichert oder geteilt? Gehen Sie nicht davon aus, dass der Offline-Modus aktiv ist, nur weil das Modell lokal ausgeführt wird.
Bei dem Vergleich geht es nicht darum, eine Architektur zum Sieger zu erklären. Das Gerät ist ein sinnvoller Weg, wenn Offline-Zugriff, unmittelbare Antworten oder die Verringerung bestimmter Übertragungen wichtig sind. Die Cloud kann helfen, wenn eine Funktion ein leistungsfähigeres Modell oder Ressourcen benötigt, die das Gerät nicht besitzt. Die Entscheidung hängt von Nutzung und Daten ab sowie von den tatsächlichen Optionen der App – nicht allein von der Produktbezeichnung der Funktion.
Zusammengefasst bedeutet geräteinterne KI, dass ein Teil der Inferenz auf dem Gerät des Nutzers stattfindet. Das kann die Verfügbarkeit verbessern und die Datenübertragung für diesen Vorgang begrenzen; die Ergebnisse hängen jedoch von Hardware, Modell und Softwaredesign ab. Für den Datenschutz muss der vollständige Datenweg betrachtet werden, und die lokale Leistungsfähigkeit ist an der jeweiligen Aufgabe zu messen.