Positionierung des DGX Spark am Desktop
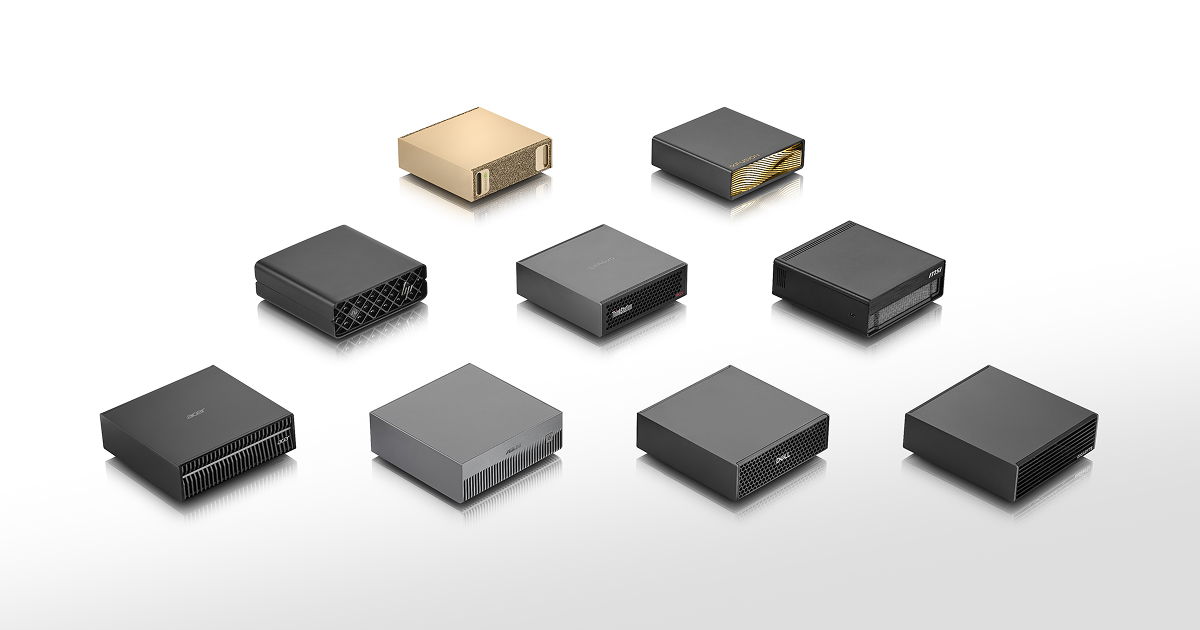
Der NVIDIA DGX Spark wird als eine Kategorie von Desktop-Computern vorgestellt, die speziell zum Bau und zur Ausführung von künstlichen Intelligenz-Modellen konzipiert ist. Im Gegensatz zu traditionellen Workstations, die eine x86-CPU mit einer diskreten GPU kombinieren, integriert er beide Komponenten in einem einzigen Superchip. Das Angebot zielt darauf ab, die Hürde zu senken, die beim Datentransfer zwischen Prozessor und Beschleuniger entsteht, und bietet eine kohärente Architektur, um KI-Workloads von einem einzigen System aus zu verwalten.
Mit Abmessungen von 150 x 150 x 50,5 mm und einem Gewicht von 1,2 kg ermöglicht sein kompaktes Format, ihn auf einem Schreibtisch zu platzieren, ohne auf ein Tower-Gehäuse zurückzugreifen. NVIDIA richtet ihn an Entwickler, die Prototypen erstellen, anpassen und lokal die Inferenz von Modellen mit bis zu 200 Milliarden Parametern ausführen müssen. Die Verfügbarkeit der Modelle auf dem Gerät selbst reduziert die Abhängigkeit von der Cloud während der Entwicklung und bei der Arbeit mit autonomen Agenten, was jedoch nicht bedeutet, dass das Gerät jede Recheninfrastruktur ersetzt.
Architektur des GB10-Superchips
Der Kern des Systems ist der GB10 Grace Blackwell-Superchip, der eine 20-Kern-Arm-CPU mit einer Blackwell-GPU kombiniert. Die CPU vereint 10 Hochleistungs-Cortex-X925-Kerne und 10 Effizienz-Cortex-A725-Kerne; die GPU incorporates fünfte Generation Tensor Cores und vierte Generation RT-Kerne. Die Verbindung zwischen beiden Komponenten erfolgt über NVLink-C2C, was eine Hochgeschwindigkeitskommunikation ermöglicht und zum Aufrechterhalten des Datenflusses zwischen CPU und GPU beiträgt.
Der Speicher ist eines der auffälligsten Merkmale dieser Architektur. Das System verfügt über 128 GB kohärenten einheitlichen Speicher LPDDR5x, der zwischen CPU und GPU geteilt wird, ohne dass Daten von der einen zur anderen kopiert werden müssen. So kann ein Modell in den Systemspeicher geladen werden, ohne sich ausschließlich auf den VRAM einer diskreten GPU zu verlassen, der in der Regel auf 24 oder 32 GB begrenzt ist. Die Kapazität allein garantiert keine schnelle Inferenz, ermöglicht aber die Bearbeitung von Modellen, die in diese Menge an Grafikspeicher nicht passen würden.
Inferenzleistung und Vergleiche
In Bezug auf die rohe Leistung bietet der DGX Spark bis zu 1 PetaFLOP FP4-Leistung mit Sparsity. Diese Zahl beschreibt die Rechenkapazität unter einer bestimmten Präzision und Bedingungen; sie entspricht nicht direkt der Geschwindigkeit, die eine Person bei der Textgenerierung wahrnimmt. Bei der Inferenz von Sprachmodellen ist auch wichtig, wie lange das System braucht, um die für jede Operation benötigten Daten bereitzustellen.
Die Speicherbandbreite von 273 GB/s, die zwischen CPU und GPU geteilt wird, beeinflusst diese Versorgung und damit das Tempo der Token-Generierung. Verfügbarer Speicher und Zugriffsgeschwindigkeit sind unterschiedliche Maße: Eine hohe Kapazität ermöglicht das Laden großer Modelle, während die Bandbreite die Verarbeitungsgeschwindigkeit beeinflusst. Daher reicht die beworbene maximale Leistung nicht aus, um die tatsächliche Leistung einer Arbeitslast vorherzusagen.
Unabhängige Benchmarks zeigen, dass der DGX Spark bei kleinen Modellen mit weniger als 20B Parametern effektiv mit High-End-GPUs konkurriert. Bei größeren Modellen wird die Bandbreitenbeschränkung sichtbarer. In Tests mit GPT-OSS 20B generierte eine RTX 5090 205,5 Token pro Sekunde, im Vergleich zu 60,9 beim DGX Spark. Die diskrete GPU behält den Vorteil in der reinen Dekodiergeschwindigkeit, ein relevanter Unterschied, wenn die Priorität darin besteht, Antworten mit der geringstmöglichen Wartezeit zu erhalten.
Speicher- und Bandbreitenbeschränkungen
Obwohl die 128 GB das Laden quantisierter Modelle mit bis zu 200B Parametern ermöglichen, stellt die Bandbreite von 273 GB/s einen erheblichen Engpass dar. Bei Modellen mit mehr als 30B Parametern sinkt die Token-Generierungsgeschwindigkeit deutlich. Folglich bedeutet die Fähigkeit, das vollständige Modell zu laden, nicht, dass die Interaktion so flüssig sein wird wie auf einem System mit höherer Speicherbandbreite.
Diese Beschränkung ist mit der LPDDR5x-Technologie verbunden, die Dichte und Energieeffizienz gegenüber der Übertragungsgeschwindigkeit priorisiert. Das Design ermöglicht es, eine große Speicherkapazität im System zusammenzufassen, aber diese Kapazität und das Tempo, mit dem Daten gelesen werden, skalieren nicht auf dieselbe Weise. Die Modellgröße verändert das Gleichgewicht: Je anspruchsvoller die Last, desto wichtiger ist es, auch den Speicherzugriff zu berücksichtigen.
Für diejenigen, die schnelle Inferenz mit großen Modellen benötigen, ist der DGX Spark trotz seiner Fähigkeit, umfangreiche Modelle zu laden, möglicherweise nicht die ideale Option. Die Wahl hängt davon ab, was priorisiert wird: genügend Speicher zum Ausführen des vollständigen Modells oder die Maximierung der Antwortgeschwindigkeit. In Anwendungen, in denen Latenz kritisch ist, können Lösungen mit mehr Bandbreite geeigneter sein; wenn Kapazität im Vordergrund steht, bietet einheitlicher Speicher einen anderen Vorteil.
Machbarkeit für lokale KI-Workloads
Der DGX Spark erweist sich besonders als nützlich für die Entwicklung autonomer Agenten und andere Inferenzaufgaben, bei denen Latenz nicht der Hauptfaktor ist. Seine Fähigkeit, Modelle lokal kontinuierlich auszuführen, kann angemessen sein, wenn die Datensicherheit Priorität hat oder wenn kein Cloud-Zugriff gewünscht oder möglich ist. Der Nutzen in diesen Szenarien stammt daraus, die Last auf dem Gerät zu halten, nicht daraus, dass die Geschwindigkeit immer über der einer diskreten GPU liegt.
Die Option, bis zu vier Einheiten über ConnectX-7 zu interconnecten, ermöglicht es, den einheitlichen Speicher auf 512 GB und die KI-Leistung auf 4 PetaFLOPS zu skalieren. Die Erweiterung durch Einheiten bietet einen Weg, Ressourcen zu erhöhen, ohne direkt auf ein vollständiges Rechenzentrum umzusteigen. Dies kann das System für kleine Teams machbar machen, die fortgeschrittene Inferenzfähigkeiten benötigen, obwohl die konkrete Bequemlichkeit von ihren Modellen und der Bedeutung abhängt, die sie Kapazität und Geschwindigkeit beimessen.
Fazit und Relevanz für 2026
Der NVIDIA DGX Spark schlägt eine Desktop-Alternative zu den traditionellen Konfigurationen aus CPU und diskreter GPU vor. Seine einheitliche Architektur adressiert die Speicherkapazitätsbeschränkung, die das Laden großer Modelle auf einer GPU verhindern kann, führt aber eine Bandbreitenbeschränkung ein, die die Leistung dieser Modelle beeinträchtigt. Sein Angebot definiert sich durch dieses Gleichgewicht zwischen der Möglichkeit, mehr Daten zu hosten, und ihrer Verarbeitung mit einer durch den Speicher bedingten Geschwindigkeit.
Blickend auf 2026 positioniert sich das Gerät als Werkzeug für Entwickler, die mit mittelgroßen Modellen und lokalen Agenten arbeiten. Die Entscheidung, es zu adoptieren, muss sowohl die erforderliche Speicherkapazität als auch die von jeder Aufgabe geforderte Inferenzgeschwindigkeit berücksichtigen. High-End-diskrete GPUs bleiben in der reinen Dekodierleistung überlegen; daher passt der DGX Spark besser, wenn das lokale Laden des Modells und das Halten der Daten auf dem Gerät mehr wiegen als das Erreichen der maximalen Geschwindigkeit.