Positionnement du DGX Spark sur le bureau
Le NVIDIA DGX Spark se présente comme une catégorie d'ordinateur de bureau conçue spécifiquement pour construire et exécuter des modèles d'intelligence artificielle. Contrairement aux stations de travail traditionnelles qui combinent un CPU x86 avec un GPU discret, il intègre les deux composants dans un seul superpuce. La proposition vise à réduire la barrière que représente le transfert de données entre processeur et accélérateur, et offre une architecture cohérente pour gérer les charges de travail d'IA depuis un même système.
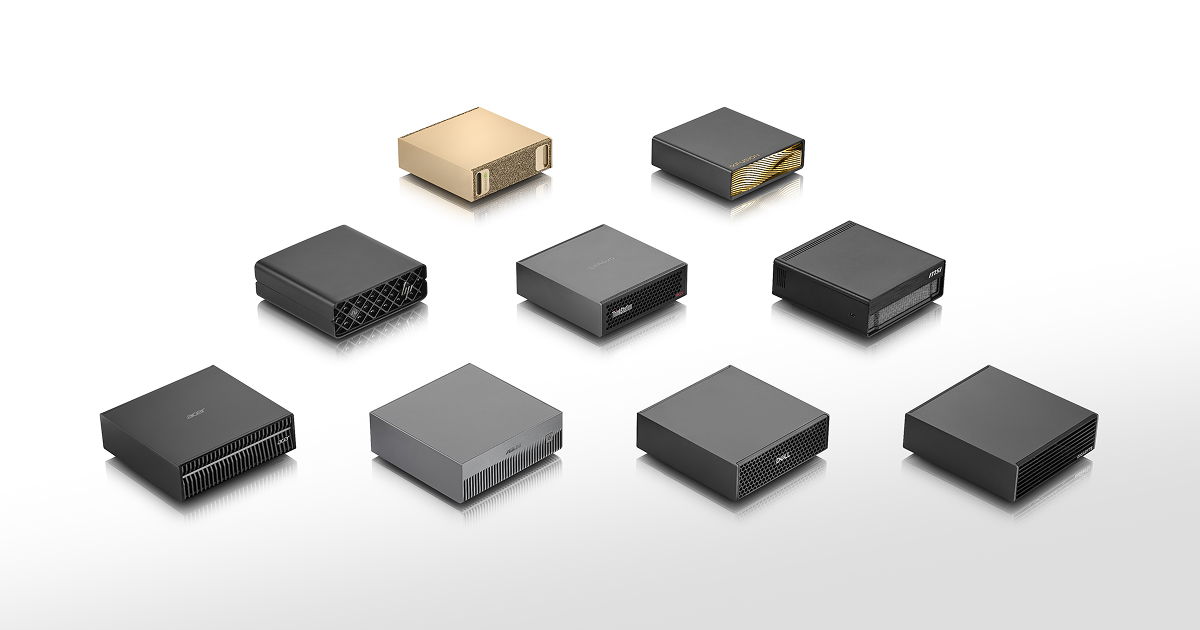
Avec des dimensions de 150 x 150 x 50,5 mm et un poids de 1,2 kg, son format compact permet de le placer sur un bureau sans recourir à un châssis tour. NVIDIA le destine aux développeurs qui ont besoin de prototyper, d'ajuster et d'exécuter localement l'inférence de modèles de jusqu'à 200 milliards de paramètres. Avoir les modèles disponibles sur l'équipement réduit la dépendance au cloud pendant le développement et lors du travail avec des agents autonomes, bien que cela ne signifie pas que l'appareil remplace toute infrastructure de calcul.
Architecture du superpuce GB10
Le cœur du système est le superpuce GB10 Grace Blackwell, qui combine un CPU Arm à 20 cœurs avec un GPU Blackwell. Le CPU réunit 10 cœurs haute performance Cortex-X925 et 10 cœurs d'efficacité Cortex-A725 ; le GPU incorpore des Tensor Cores de cinquième génération et des cœurs RT de quatrième génération. La connexion entre les deux composants est réalisée via NVLink-C2C, qui permet une communication à haute vitesse et contribue à maintenir le flux de données entre CPU et GPU.
La mémoire est l'un des traits les plus distinctifs de cette architecture. Le système dispose de 128 Go de mémoire unifiée cohérente LPDDR5x, partagée entre le CPU et le GPU sans qu'il soit nécessaire de copier les données de l'un à l'autre. Ainsi, un modèle peut être chargé en mémoire système sans dépendre uniquement de la VRAM disponible sur un GPU discret, qui est généralement limitée à 24 ou 32 Go. La capacité ne garantit pas à elle seule une inférence rapide, mais permet d'aborder des modèles qui ne tiendraient pas dans cette quantité de mémoire graphique.
Performances d'inférence et comparatifs
En puissance brute, le DGX Spark offre jusqu'à 1 petaFLOP de performance en FP4 avec sparsité. Ce chiffre décrit une capacité de calcul sous une précision et des conditions concrètes ; il n'équivaut pas directement à la vitesse perçue par une personne lors de la génération de texte. Dans l'inférence de modèles de langage, il importe aussi de savoir combien de temps le système met à fournir les données nécessaires à chaque opération.
La bande passante mémoire, de 273 Go/s partagée entre CPU et GPU, conditionne cet approvisionnement et, par conséquent, le rythme de génération de jetons. La mémoire disponible et la vitesse d'accès sont des mesures distinctes : une capacité élevée permet de charger de grands modèles, tandis que la bande passante influence la rapidité de traitement. C'est pourquoi la puissance maximale annoncée ne suffit pas à anticiper les performances réelles d'une charge de travail.
Les benchmarks indépendants indiquent que, pour les petits modèles, de moins de 20B paramètres, le DGX Spark concurrence efficacement les GPU haut de gamme. Dans les modèles plus grands, la limitation de bande passante devient plus visible. Dans des tests avec GPT-OSS 20B, une RTX 5090 a généré 205,5 jetons par seconde, contre 60,9 pour le DGX Spark. Le GPU discret conserve l'avantage en vitesse de décodage pure, une différence pertinente lorsque la priorité est d'obtenir des réponses avec le moins d'attente possible.
Limites de mémoire et de bande passante
Bien que les 128 Go permettent de charger des modèles quantifiés de jusqu'à 200B paramètres, la bande passante de 273 Go/s constitue un goulot d'étranglement significatif. Pour les modèles de plus de 30B paramètres, la vitesse de génération de jetons diminue notablement. Par conséquent, pouvoir charger le modèle complet ne signifie pas que l'interaction sera aussi fluide que sur un système avec une bande passante mémoire supérieure.
Cette limitation est liée à la technologie LPDDR5x, qui privilégie la densité et l'efficacité énergétique par rapport à la vitesse de transfert. La conception permet de réunir une grande capacité de mémoire dans le système, mais cette capacité et le rythme de lecture des données n'évoluent pas de la même manière. La taille du modèle modifie l'équilibre : plus la charge est exigeante, plus il est important de considérer également l'accès à la mémoire.
Pour ceux qui ont besoin d'une inférence rapide avec de grands modèles, le DGX Spark peut ne pas être l'option idéale, malgré sa capacité à charger des modèles étendus. Le choix dépend de ce qui est prioritaire : disposer de mémoire suffisante pour exécuter le modèle complet ou maximiser la vitesse de réponse. Dans les usages où la latence est critique, les solutions avec plus de bande passante peuvent s'avérer plus adaptées ; si la capacité prime, la mémoire unifiée offre un avantage différent.
Viabilité pour les charges de travail IA locales
Le DGX Spark s'avère particulièrement utile pour le développement d'agents autonomes et d'autres tâches d'inférence où la latence n'est pas le facteur principal. Sa capacité à exécuter des modèles localement de manière continue peut être adéquate lorsque la confidentialité des données est prioritaire ou lorsque l'accès au cloud n'est pas souhaité ou possible. L'utilité dans ces scénarios provient du maintien de la charge sur l'équipement, et non du fait que la vitesse soit toujours supérieure à celle d'un GPU discret.
L'option d'interconnecter jusqu'à quatre unités via ConnectX-7 permet d'élargir la mémoire unifiée jusqu'à 512 Go et les performances IA jusqu'à 4 petaFLOPS. L'expansion par unités offre une voie pour augmenter les ressources sans passer directement à un centre de données complet. Cela peut rendre le système viable pour les petites équipes ayant besoin de capacités d'inférence avancées, bien que la convenance concrète dépendra de leurs modèles et de l'importance qu'ils accordent à la capacité et à la vitesse.
Conclusion et pertinence pour 2026
Le NVIDIA DGX Spark propose une alternative de bureau aux configurations traditionnelles de CPU plus GPU discret. Son architecture unifiée aborde la limitation de capacité mémoire qui peut empêcher de charger de grands modèles sur un GPU, mais introduit une restriction de bande passante qui affecte les performances de ces modèles. Sa proposition se définit par cet équilibre entre pouvoir héberger plus de données et les traiter à une vitesse conditionnée par la mémoire.
À l'horizon 2026, l'appareil se positionne comme un outil pour les développeurs travaillant avec des modèles de taille moyenne et des agents locaux. La décision de l'adopter doit prendre en compte à la fois la capacité mémoire nécessaire et la vitesse d'inférence exigée par chaque tâche. Les GPU discrets haut de gamme restent supérieurs en performance pure de décodage ; par conséquent, le DGX Spark s'inscrit mieux lorsque charger le modèle localement et garder les données sur l'équipement pèsent plus que d'atteindre la vitesse maximale.