Posizionamento del DGX Spark sul desktop
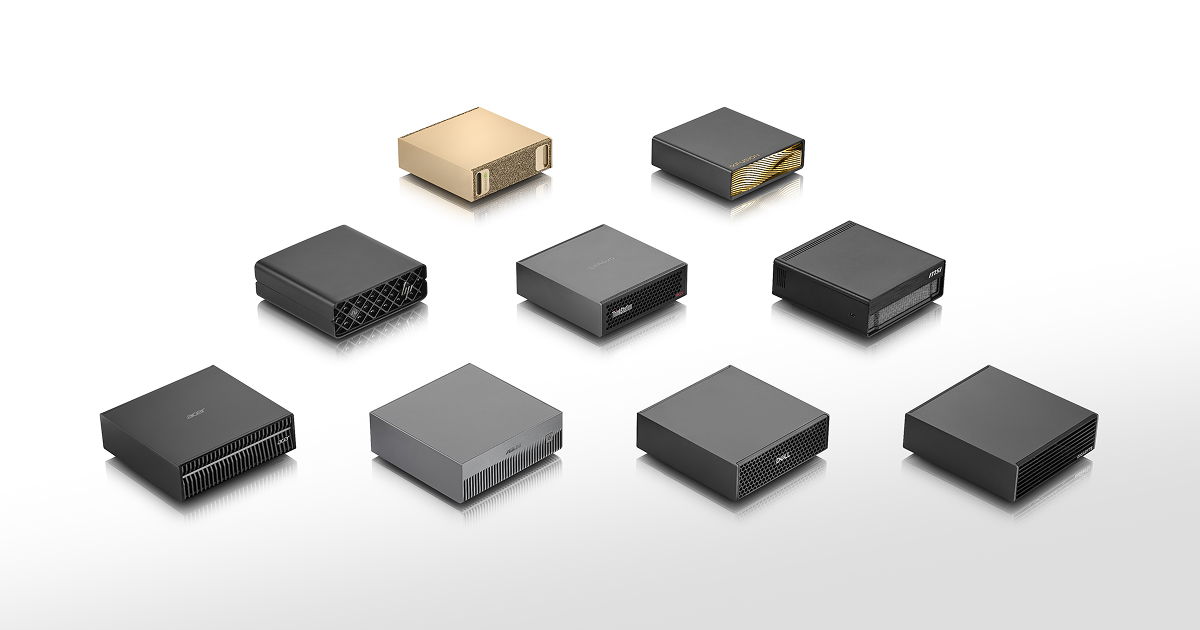
Il NVIDIA DGX Spark si presenta come una categoria di computer desktop progettata specificamente per costruire ed eseguire modelli di intelligenza artificiale. A differenza delle workstation tradizionali che combinano una CPU x86 con una GPU discreta, integra entrambi i componenti in un unico superchip. La proposta mira a ridurre la bariera rappresentata dal trasferimento di dati tra processore e acceleratore, offrendo un'architettura coerente per gestire i carichi di lavoro di IA da un unico sistema.
Con dimensioni di 150 x 150 x 50,5 mm e un peso di 1,2 kg, il suo formato compatto consente di posizionarlo su una scrivania senza ricorrere a un case tower. NVIDIA lo rivolge agli sviluppatori che hanno bisogno di prototipare, regolare ed eseguire localmente l'inferenza di modelli fino a 200 miliardi di parametri. Avere i modelli disponibili sul dispositivo stesso riduce la dipendenza dal cloud durante lo sviluppo e quando si lavora con agenti autonomi, sebbene non significhi che il dispositivo sostituisca qualsiasi infrastruttura di calcolo.
Architettura del superchip GB10
Il cuore del sistema è il superchip GB10 Grace Blackwell, che combina una CPU Arm a 20 core con una GPU Blackwell. La CPU riunisce 10 core ad alte prestazioni Cortex-X925 e 10 core di efficienza Cortex-A725; la GPU incorpora Tensor Cores di quinta generazione e core RT di quarta generazione. La connessione tra i due componenti avviene tramite NVLink-C2C, che consente una comunicazione ad alta velocità e contribuisce a mantenere il flusso di dati tra CPU e GPU.
La memoria è uno dei tratti più distintivi di questa architettura. Il sistema dispone di 128 GB di memoria unificata coerente LPDDR5x, condivisa tra CPU e GPU senza la necessità di copiare i dati da uno all'altro. In questo modo, un modello può essere caricato nella memoria di sistema senza dipendere esclusivamente dalla VRAM disponibile su una GPU discreta, che di solito si limita a 24 o 32 GB. La capacità da sola non garantisce un'inferenza rapida, ma consente di affrontare modelli che non rientrerebbero in quella quantità di memoria grafica.
Prestazioni di inferenza e confronti
In termini di potenza bruta, il DGX Spark offre fino a 1 petaFLOP di prestazioni in FP4 con sparsità. Questa cifra descrive la capacità di calcolo sotto una precisione e condizioni specifiche; non equivale direttamente alla velocità percepita da una persona durante la generazione di testo. Nell'inferenza dei modelli linguistici conta anche quanto tempo impiega il sistema a fornire i dati necessari per ogni operazione.
La banda di memoria, di 273 GB/s condivisa tra CPU e GPU, condiziona questo approvvigionamento e, quindi, il ritmo di generazione dei token. La memoria disponibile e la velocità di accesso sono misure distinte: un'alta capacità consente di caricare modelli grandi, mentre la banda influisce sulla rapidità di elaborazione. Per questo, la potenza massima annunciata non basta per anticipare le prestazioni reali di un carico di lavoro.
I benchmark indipendenti indicano che, per i modelli piccoli, di meno di 20B parametri, il DGX Spark compete efficacemente con le GPU di fascia alta. Nei modelli più grandi, la limitazione di banda diventa più visibile. In test con GPT-OSS 20B, una RTX 5090 ha generato 205,5 token al secondo, contro i 60,9 del DGX Spark. La GPU discreta conserva il vantaggio in velocità di decodifica pura, una differenza rilevante quando la priorità è ottenere risposte con l'attesa minima possibile.
Limiti di memoria e banda
Sebbene i 128 GB consentano di caricare modelli quantizzati fino a 200B parametri, la banda di 273 GB/s rappresenta un collo di bottiglia significativo. Per i modelli di oltre 30B parametri, la velocità di generazione dei token diminuisce notevolmente. Di conseguenza, poter caricare il modello completo non significa che l'interazione sarà fluida come su un sistema con maggiore banda di memoria.
Questa limitazione è legata alla tecnologia LPDDR5x, che privilegia la densità e l'efficienza energetica rispetto alla velocità di trasferimento. Il design rende possibile riunire una grande capacità di memoria nel sistema, ma quella capacità e il ritmo di lettura dei dati non scalano allo stesso modo. La dimensione del modello modifica l'equilibrio: più il carico è esigente, più è importante considerare anche l'accesso alla memoria.
Per chi ha bisogno di inferenza rapida con modelli grandi, il DGX Spark potrebbe non essere l'opzione ideale, nonostante la sua capacità di caricare modelli estesi. La scelta dipende da cosa si privilegia: disporre di memoria sufficiente per eseguire il modello completo o massimizzare la velocità di risposta. In usi dove la latenza è critica, le soluzioni con più banda possono risultare più adatte; se la capacità è prioritaria, la memoria unificata offre un vantaggio diverso.
Fattibilità per carichi di lavoro IA locali
Il DGX Spark risulta particolarmente utile per lo sviluppo di agenti autonomi e altre attività di inferenza in cui la latenza non è il fattore principale. La sua capacità di eseguire modelli localmente in modo continuo può essere adeguata quando la privacy dei dati è prioritaria o quando non si desidera o non si può accedere al cloud. L'utilità in quegli scenari deriva dal mantenere il carico sul dispositivo, non dal fatto che la velocità sia sempre superiore a quella di una GPU discreta.
L'opzione di interconnettere fino a quattro unità tramite ConnectX-7 consente di scalare la memoria unificata fino a 512 GB e le prestazioni IA fino a 4 petaFLOPS. L'espansione per unità offre una via per aumentare le risorse senza passare direttamente a un centro dati completo. Questo può rendere il sistema fattibile per piccoli team che necessitano di capacità di inferenza avanzate, sebbene la convenienza concreta dipenderà dai loro modelli e dall'importanza che assegnano a capacità e velocità.
Conclusione e rilevanza per il 2026
Il NVIDIA DGX Spark propone un'alternativa desktop alle configurazioni tradizionali di CPU più GPU discreta. La sua architettura unificata affronta la limitazione di capacità di memoria che può impedire di caricare modelli grandi su una GPU, ma introduce una restrizione di banda che incide sulle prestazioni di quei modelli. La sua proposta si definisce per quell'equilibrio tra poter ospitare più dati e elaborarli a una velocità condizionata dalla memoria.
In vista del 2026, il dispositivo si posiziona come uno strumento per sviluppatori che lavorano con modelli di dimensioni medie e agenti locali. La decisione di adottarlo deve considerare sia la capacità di memoria necessaria sia la velocità di inferenza richiesta da ogni attività. Le GPU discrete di fascia alta rimangono superiori in prestazioni pure di decodifica; pertanto, il DGX Spark si adatta meglio quando caricare il modello localmente e mantenere i dati sul dispositivo pesano più che raggiungere la velocità massima.