Posicionamento do DGX Spark no desktop
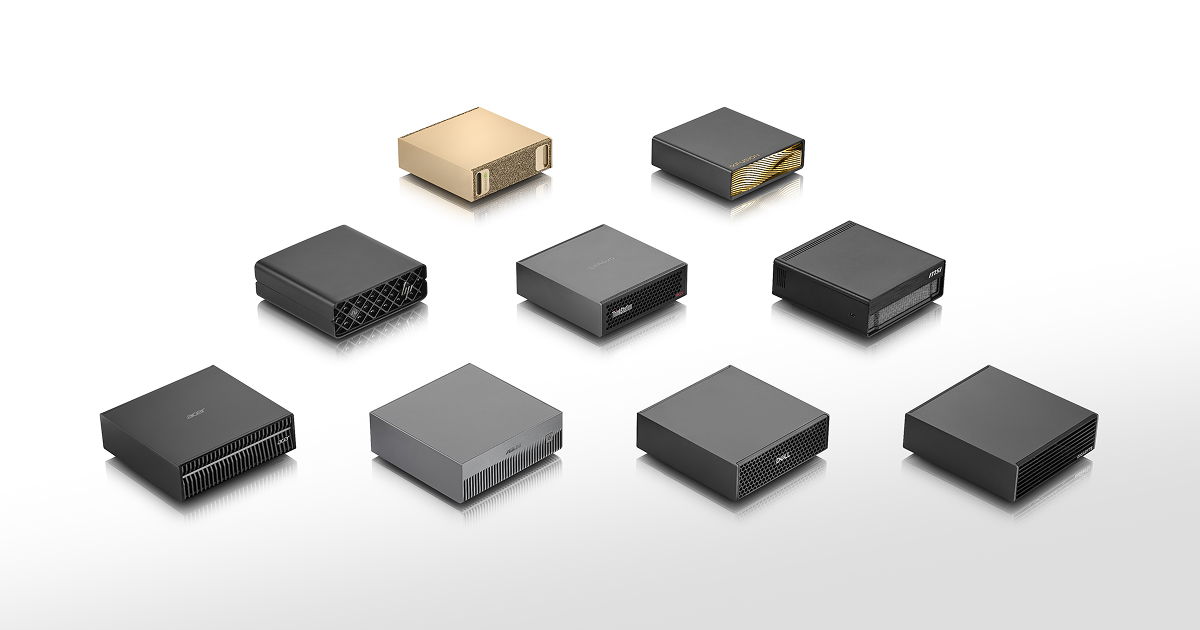
O NVIDIA DGX Spark é apresentado como uma categoria de computador de mesa projetada especificamente para construir e executar modelos de inteligência artificial. Diferentemente das estações de trabalho tradicionais, que combinam uma CPU x86 com uma GPU discreta, ele integra ambos os componentes em um único superchip. A proposta busca reduzir a barreira que representa transferir dados entre processador e acelerador, e oferece uma arquitetura coerente para gerenciar cargas de trabalho de IA a partir de um mesmo sistema.
Com dimensões de 150 x 150 x 50,5 mm e peso de 1,2 kg, seu formato compacto permite colocá-lo em uma mesa sem recorrer a um chassi torre. A NVIDIA o direciona a desenvolvedores que precisam prototipar, ajustar e executar localmente a inferência de modelos de até 200 bilhões de parâmetros. Ter os modelos disponíveis no próprio equipamento reduz a dependência da nuvem durante o desenvolvimento e ao trabalhar com agentes autônomos, embora não signifique que o dispositivo substitua qualquer infraestrutura de computação.
Arquitetura do superchip GB10
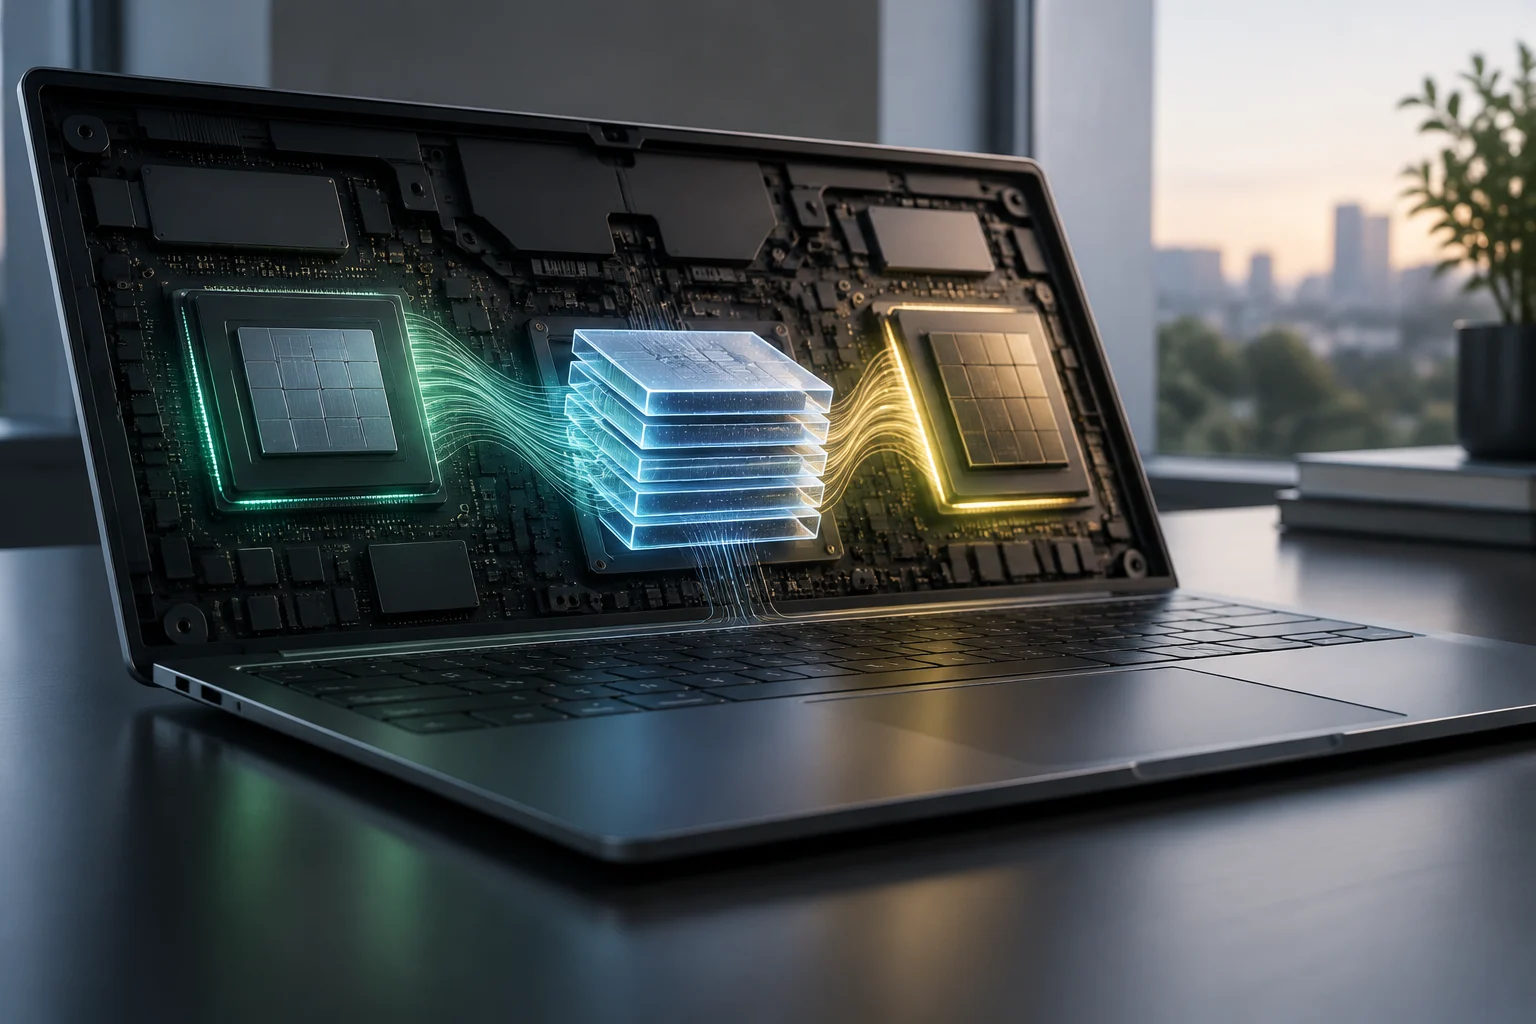
O núcleo do sistema é o superchip GB10 Grace Blackwell, que combina uma CPU Arm de 20 núcleos com uma GPU Blackwell. A CPU reúne 10 núcleos de alto desempenho Cortex-X925 e 10 núcleos de eficiência Cortex-A725; a GPU incorpora Tensor Cores de quinta geração e núcleos RT de quarta geração. A conexão entre ambos os componentes é realizada via NVLink-C2C, que permite comunicação de alta velocidade e contribui para manter o fluxo de dados entre CPU e GPU.
A memória é um dos traços mais distintivos desta arquitetura. O sistema conta com 128 GB de memória unificada coerente LPDDR5x, compartilhada entre a CPU e a GPU sem que seja necessário copiar os dados de uma para a outra. Dessa forma, um modelo pode ser carregado na memória do sistema sem depender exclusivamente da VRAM disponível em uma GPU discreta, que costuma se limitar a 24 ou 32 GB. A capacidade por si só não garante uma inferência rápida, mas permite abordar modelos que não caberiam nessa quantidade de memória gráfica.
Desempenho de inferência e comparativos
Em potência bruta, o DGX Spark oferece até 1 petaFLOP de desempenho em FP4 com esparsidade. Essa cifra descreve capacidade de cálculo sob uma precisão e condições concretas; não equivale diretamente à velocidade que uma pessoa percebe ao gerar texto. Na inferência de modelos de linguagem também importa quanto tempo o sistema leva para fornecer os dados que cada operação necessita.
A largura de banda de memória, de 273 GB/s compartilhada entre CPU e GPU, condiciona esse fornecimento e, portanto, o ritmo de geração de tokens. A memória disponível e a velocidade de acesso são medidas distintas: uma capacidade alta permite carregar modelos grandes, enquanto a largura de banda influencia a rapidez com que são processados. Por isso, a potência máxima anunciada não basta para antecipar o desempenho real de uma carga de trabalho.
Benchmarks independentes indicam que, para modelos pequenos, de menos de 20B parâmetros, o DGX Spark compete eficazmente com GPUs de gama alta. Em modelos maiores, a limitação de largura de banda torna-se mais visível. Em testes com GPT-OSS 20B, uma RTX 5090 gerou 205,5 tokens por segundo, frente aos 60,9 do DGX Spark. A GPU discreta conserva a vantagem em velocidade de decodificação pura, uma diferença relevante quando a prioridade é obter respostas com a menor espera possível.
Limitações de memória e largura de banda
Embora os 128 GB permitam carregar modelos quantizados de até 200B parâmetros, a largura de banda de 273 GB/s representa um gargalo significativo. Para modelos de mais de 30B parâmetros, a velocidade de geração de tokens diminui notavelmente. Em consequência, poder carregar o modelo completo não significa que a interação será tão fluida quanto em um sistema com maior largura de banda de memória.
Esta limitação está vinculada à tecnologia LPDDR5x, que prioriza a densidade e a eficiência energética sobre a velocidade de transferência. O design torna possível reunir uma grande capacidade de memória no sistema, mas essa capacidade e o ritmo no qual os dados são lidos não escalam da mesma maneira. O tamanho do modelo modifica o equilíbrio: quanto mais exigente for a carga, mais importante resulta considerar também o acesso à memória.
Para quem precisa de inferência rápida com modelos grandes, o DGX Spark pode não ser a opção ideal, apesar de sua capacidade de carregar modelos extensos. A escolha depende do que se prioriza: dispor de memória suficiente para executar o modelo completo ou maximizar a velocidade de resposta. Em usos onde a latência é crítica, soluções com mais largura de banda podem resultar mais adequadas; se a capacidade é primordial, a memória unificada oferece uma vantagem distinta.
Viabilidade para cargas de trabalho de IA local
O DGX Spark resulta especialmente útil para o desenvolvimento de agentes autônomos e outras tarefas de inferência nas quais a latência não é o fator principal. Sua capacidade de executar modelos localmente de forma contínua pode ser adequada quando a privacidade dos dados é prioritária ou quando não se deseja ou não se pode acessar a nuvem. A utilidade nesses cenários provém de manter a carga no equipamento, não de que a velocidade seja sempre superior à de uma GPU discreta.
A opção de interconectar até quatro unidades via ConnectX-7 permite escalar a memória unificada até 512 GB e o desempenho de IA até 4 petaFLOPS. A expansão por unidades oferece uma via para aumentar os recursos sem passar diretamente a um centro de dados completo. Isso pode tornar o sistema viável para equipes pequenas que precisam de capacidades de inferência avançadas, embora a conveniência concreta dependerá de seus modelos e da importância que atribuam a capacidade e velocidade.
Conclusão e relevância para 2026
O NVIDIA DGX Spark propõe uma alternativa de mesa às configurações tradicionais de CPU mais GPU discreta. Sua arquitetura unificada aborda a limitação de capacidade de memória que pode impedir carregar modelos grandes em uma GPU, mas introduz uma restrição de largura de banda que repercute no desempenho desses modelos. Sua proposta se define por esse equilíbrio entre poder alojar mais dados e processá-los a uma velocidade condicionada pela memória.
De cara para 2026, o dispositivo se posiciona como uma ferramenta para desenvolvedores que trabalham com modelos de tamanho médio e agentes locais. A decisão de adotá-lo deve considerar tanto a capacidade de memória necessária quanto a velocidade de inferência que cada tarefa exige. As GPUs discretas de gama alta continuam sendo superiores em desempenho puro de decodificação; por isso, o DGX Spark encaixa melhor quando carregar o modelo localmente e manter os dados no equipamento pesam mais que alcançar a máxima velocidade.