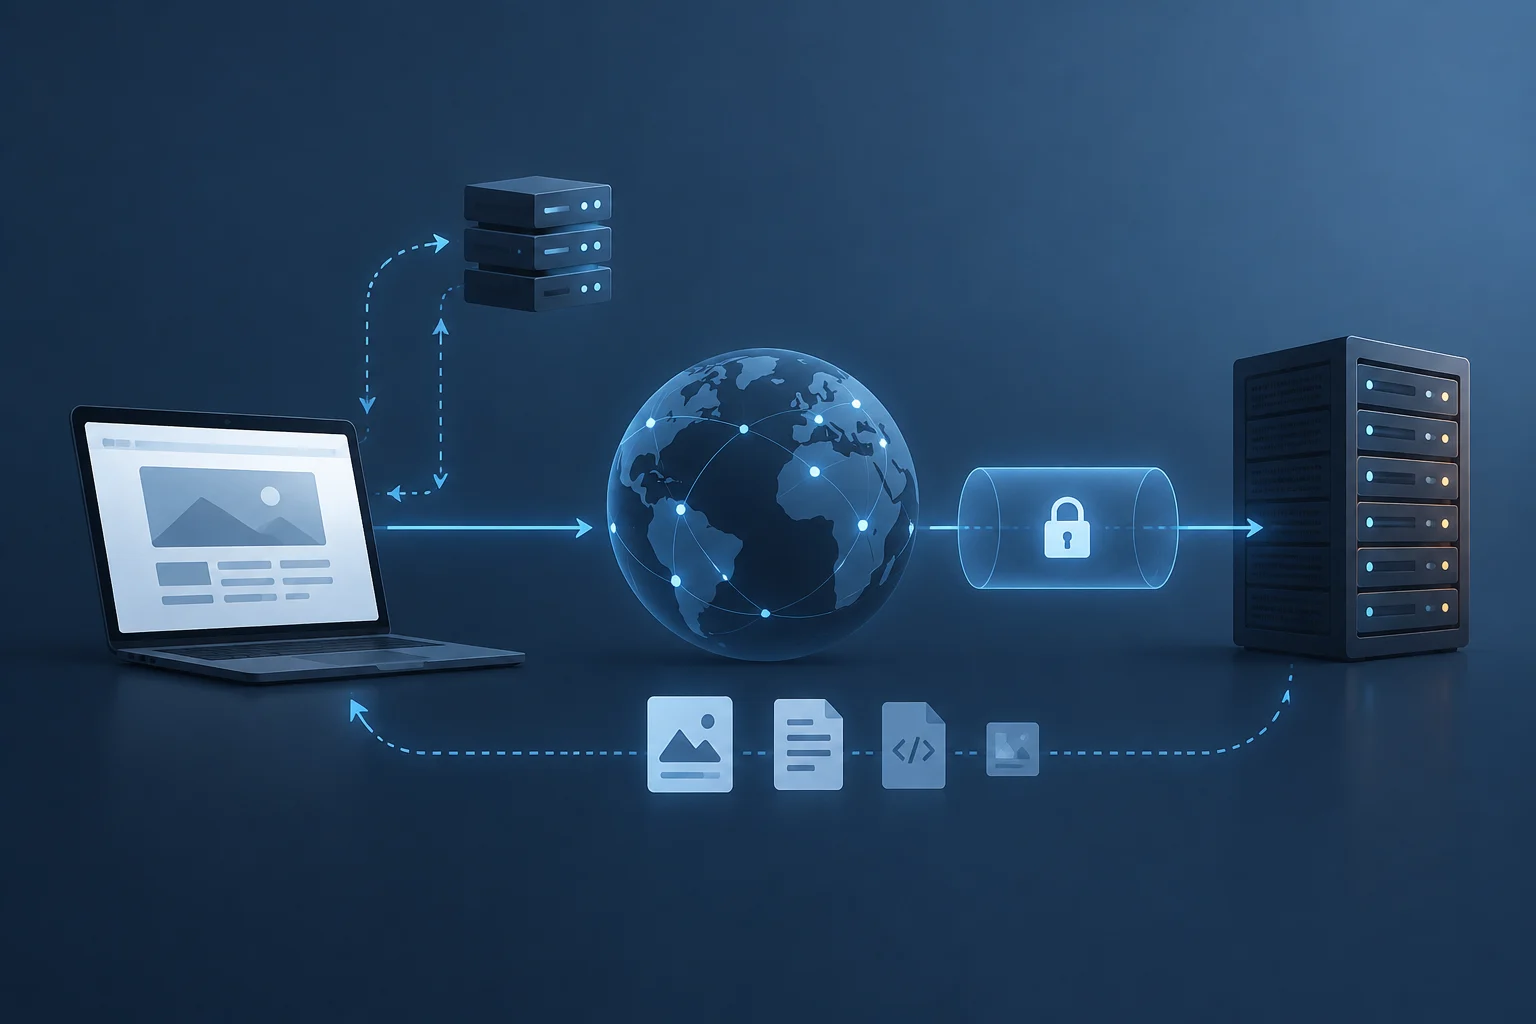
De l’adresse saisie à une adresse IP
Lorsque vous saisissez une adresse web, le navigateur en sépare les éléments : le schéma (par exemple HTTPS), le nom d’hôte, le chemin et, le cas échéant, des paramètres supplémentaires. Pour contacter le serveur, il doit connaître une adresse réseau associée à ce nom. C’est là qu’intervient le système de noms de domaine, ou DNS : un système distribué de noms et d’enregistrements, et non un répertoire contenant nécessairement une adresse permanente unique pour chaque site.
Le navigateur ou le système d’exploitation peut conserver temporairement des réponses. En l’absence de réponse valide dans le cache, l’appareil interroge un résolveur, qui peut être celui du fournisseur d’accès à Internet, d’un réseau d’entreprise ou un résolveur configuré par l’utilisateur. Celui-ci obtient la réponse au moyen de la hiérarchie DNS, qui comprend des serveurs faisant autorité pour différentes parties de l’espace de noms. Le mécanisme et les enregistrements relèvent de la spécification DNS ; les résultats dépendent du nom demandé et de la configuration du domaine.
La conséquence pratique est importante : résoudre un nom ne signifie pas charger une page. Une réponse DNS obtenue avec succès permet seulement de poursuivre vers une adresse IP. Elle ne confirme pas que le serveur est disponible, qu’il accepte les connexions, qu’il présente un certificat valide ou que l’application répondra correctement. Il peut aussi exister plusieurs adresses, ou celles-ci peuvent changer au fil du temps : une requête isolée ne décrit donc pas forcément ce que voit chaque utilisateur. En d’autres termes, le DNS prend en charge une étape précise du parcours : il fournit des informations permettant de tenter d’atteindre la destination, mais ne vérifie pas les étapes suivantes. Si le navigateur n’affiche aucun contenu, savoir qu’une réponse DNS a été obtenue aide à mieux cerner le problème, sans exclure une difficulté de connexion ou d’application.
TCP ou QUIC : comment commence l’échange
Une fois qu’il dispose d’une adresse, le client doit échanger des données avec la destination à l’aide d’un protocole de transport. Avec HTTP/1.1 et HTTP/2 sur TLS, le parcours courant utilise TCP : le client et le serveur établissent une connexion logique avant d’échanger un flux d’octets. TCP assure une livraison ordonnée et des mécanismes de retransmission, mais l’existence d’un parcours TCP ne prouve pas à elle seule que le service web répondra.
HTTP/3 utilise QUIC, qui fonctionne au-dessus d’UDP et fournit un transport fiable et sécurisé pour HTTP/3. Affirmer que toutes les pages commencent par une connexion TCP est donc une simplification trompeuse. Le navigateur et le serveur négocient le protocole qu’ils peuvent utiliser ; le résultat peut varier selon la compatibilité, la configuration et les conditions du réseau. Pour l’utilisateur, ces différences sont souvent invisibles, même si elles influent sur l’organisation des échanges.
En cas de panne, distinguer les étapes évite les conclusions hâtives. Le fait que le DNS renvoie une adresse IP ne signifie pas que le port du service répond. Et l’échec d’une tentative TCP ou QUIC n’en identifie pas à lui seul la cause : une interruption locale, une règle réseau, un problème de routage ou un serveur qui ne traite pas les demandes sont autant de possibilités. Les outils fournissent des observations faites depuis un point précis, et non une explication complète de ce qui se passe entre l’appareil et le site. Lorsqu’on compare des résultats, il est donc utile de noter l’appareil et le réseau utilisés pour chaque test. Une connexion qui fonctionne sur un réseau et échoue sur un autre apporte une différence utile à examiner, mais ne permet pas de désigner automatiquement le composant responsable.
TLS et la signification limitée du cadenas
Pour les connexions HTTPS, TLS protège les échanges entre le client et le serveur. Le protocole permet de négocier des paramètres de sécurité et d’établir des clés afin de protéger les données contre la lecture ou la modification pendant leur transit. Le navigateur vérifie également l’identité du site en fonction du nom demandé et de la chaîne de certificats reçue. TLS 1.3 est spécifié dans la RFC 8446 ; TLS 1.2 est documenté dans la RFC 5246.
L’indicateur de sécurité du navigateur doit être interprété avec précision : il signale que la connexion satisfait à certains contrôles du navigateur, et non que le site est honnête, que son contenu est exact ou que l’appareil est exempt de logiciels malveillants. HTTPS protège la connexion au site identifié par le certificat ; il ne rend pas fiables les choix éditoriaux, commerciaux ou de sécurité de ce site. Il n’empêche pas non plus le serveur lui-même de lire les données qu’il reçoit.
Si le navigateur affiche un avertissement concernant un certificat, ne l’ignorez pas et ne le contournez pas par habitude. Vérifiez que l’adresse est correctement saisie et que la date et l’heure de l’appareil sont raisonnables. Sur un réseau administré, un portail de connexion ou une règle d’entreprise peut intervenir dans la navigation, mais l’avertissement reste un signal à prendre au sérieux. Ne saisissez pas de mots de passe ni de données de paiement tant que vous n’avez pas compris pourquoi il apparaît. L’avertissement n’explique pas toujours à lui seul l’origine du problème, mais indique que le navigateur n’a pas pu effectuer l’une des vérifications d’identité prévues.
HTTP demande des ressources ; une page n’est pas un fichier unique
Après avoir établi le canal nécessaire, le navigateur envoie une requête HTTP. Elle contient une méthode, un chemin et des champs d’en-tête ; le serveur renvoie une réponse avec un code d’état, des en-têtes et, souvent, un corps. HTTP décrit la sémantique des requêtes et des réponses, mais ne garantit ni la disponibilité du serveur ni l’utilité du contenu. Le code de réponse donne un indice sur le résultat d’une requête précise, pas un diagnostic universel du site.
La première réponse peut être un document HTML qui fait référence à des feuilles de style, des images, des polices, des scripts et d’autres ressources. Le navigateur traite le document et peut envoyer de nouvelles requêtes, y compris vers d’autres noms d’hôte. Une page partiellement visible ne signifie donc pas que toutes ses dépendances ont été téléchargées. Une image qui ne s’affiche pas, par exemple, peut avoir échoué alors que le document principal est bien arrivé.
L’inverse est également possible : le serveur renvoie une réponse, mais le navigateur n’affiche pas de page utilisable. Le contenu peut dépendre de scripts, de données provenant d’une API ou de ressources bloquées. Par conséquent, « le site répond » et « la page fonctionne » ne sont pas des affirmations équivalentes. HTTP normalise les échanges ; le comportement final dépend aussi de l’application, du navigateur et des ressources nécessaires à la page. Il est utile de distinguer la réception du document principal de l’achèvement de la chaîne de requêtes qui permet de l’afficher comme l’utilisateur s’y attend. La réponse à une requête renseigne sur cette requête précise ; elle ne résume pas nécessairement l’état de toutes les autres requêtes associées à la page.
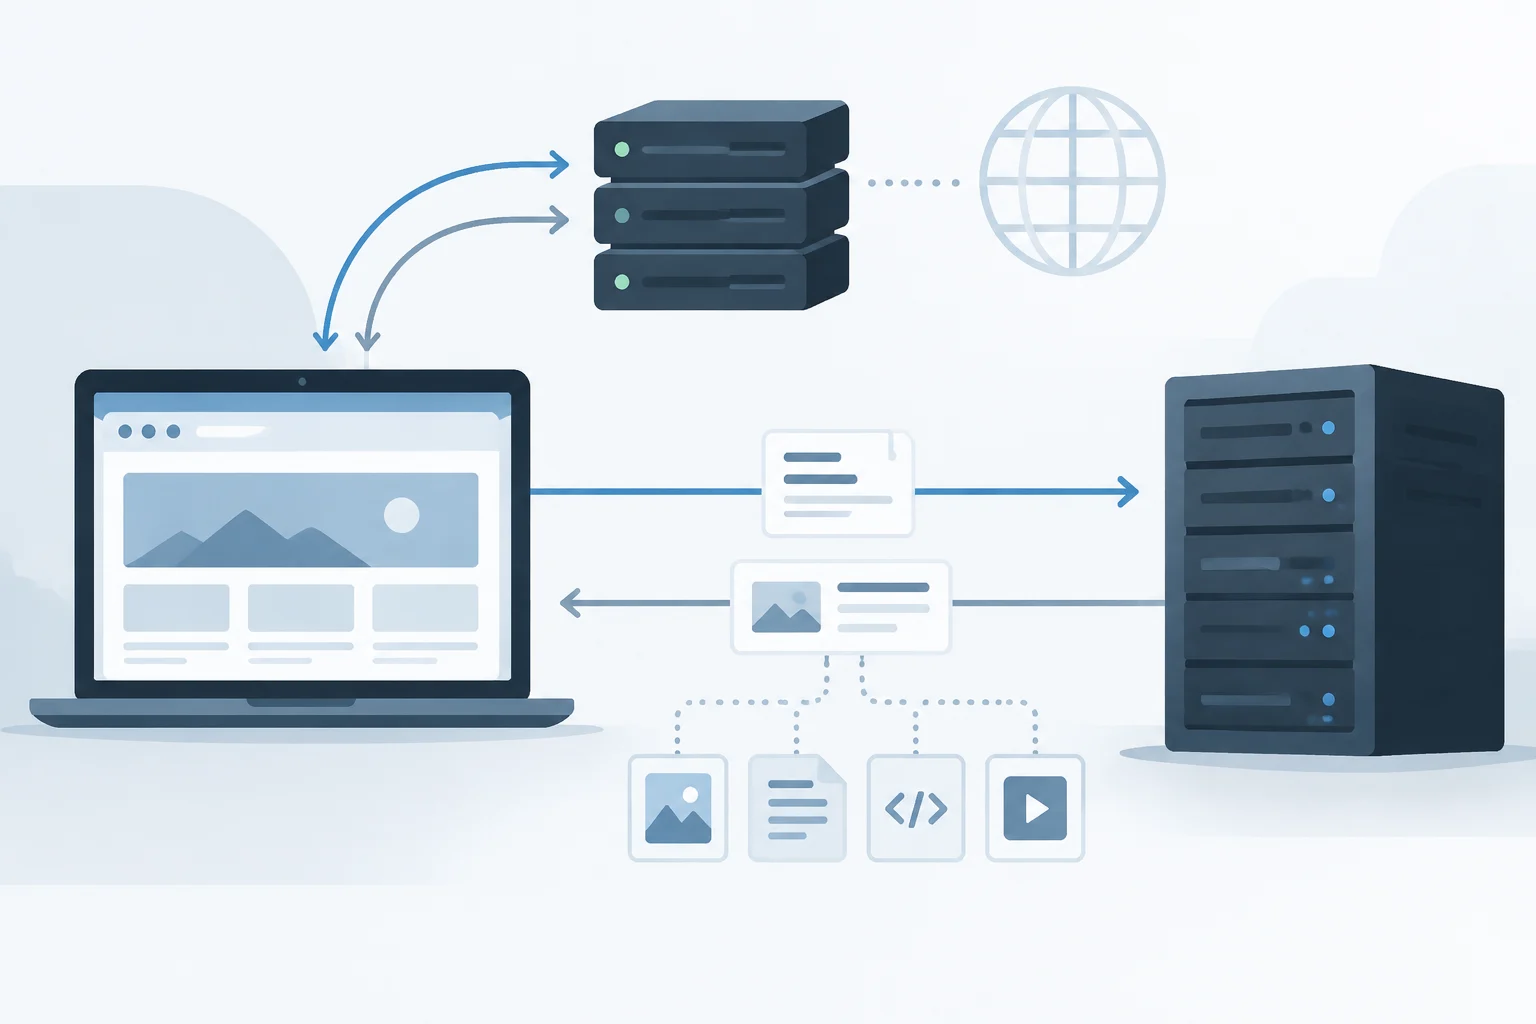
Premiers repères de diagnostic : trouver l’étape en échec
Commencez par déterminer l’étendue du problème : un seul site est-il inaccessible, plusieurs sites ou seulement une application ? Le problème apparaît-il sur un appareil ou sur tous les appareils du même réseau ? Essayez de recharger la bonne adresse et, si cela ne présente pas de risque, comparez le résultat sur un autre réseau. Ces comparaisons ne prouvent pas la cause, mais aident à distinguer une panne peut-être locale d’un problème qui semble toucher un service ou un parcours plus large.
Considérez le message du navigateur comme un indice, pas comme un verdict. Une erreur de résolution invite à examiner le DNS ; un délai d’attente dépassé peut survenir à différentes étapes ; un avertissement explicite de certificat oriente vers TLS ou la validation de l’identité ; et un code d’erreur HTTP prouve qu’une réponse HTTP a été reçue, sans établir que la cause se trouve sur l’appareil. Le texte exact et son interprétation varient selon le navigateur.
Une séquence prudente de vérifications peut être la suivante :
- Confirmez le nom du site et essayez un rechargement normal, sans recommencer indéfiniment.
- Vérifiez si d’autres sites fonctionnent et si le problème touche d’autres appareils sur le même réseau.
- Si un avertissement de certificat apparaît, ne le contournez pas pour continuer.
- Si une seule ressource de la page échoue, distinguez cet échec de la réponse du document principal.
- Si le problème persiste, notez le message et l’heure afin de les communiquer à l’administrateur du réseau ou au service concerné.
Ces vérifications servent à organiser les observations ; elles ne constituent pas une séquence garantissant l’identification de la cause. Par exemple, si d’autres sites se chargent, la connectivité ne connaît pas le même échec pour toutes les destinations, mais cela n’explique pas pourquoi ce site précis ne fonctionne pas. Noter le message exact évite de se fier à un souvenir approximatif et facilite la comparaison si le problème se reproduit.
Outils simples et limites de leurs résultats
Une requête DNS peut montrer la réponse qu’un résolveur fournit pour un nom à un moment donné. Comparer des résolveurs ou des réseaux peut révéler des différences, mais ne prouve pas automatiquement que l’un d’eux est défaillant : les réponses peuvent varier en raison du cache, de la configuration ou de la distribution du service. Les normes DNS décrivent la représentation et l’interrogation des noms et des enregistrements ; une requête ponctuelle ne reconstitue pas toute la chaîne de décisions qui a produit le résultat.
Des outils de connexion peuvent tester si une destination répond depuis l’appareil et le réseau utilisés. Un résultat positif ne vérifie pas tous les parcours possibles et ne confirme pas que HTTPS, l’application ou chaque ressource fonctionne. Un résultat négatif ne prouve pas non plus que le serveur est en panne : des filtres, des pare-feu, des routes et des règles peuvent empêcher le test. Pour interpréter une mesure, il faut savoir quel protocole et quelle destination ont été testés. La conclusion doit rester au niveau de ce qui a été mesuré : par exemple, une tentative précise n’a pas reçu de réponse depuis ce point, et non qu’aucun utilisateur ne peut accéder au service.
Les outils du navigateur permettent d’observer les requêtes et réponses HTTP, les ressources en attente et les erreurs de certificat. Ils aident à savoir si le document principal ou une dépendance précise échoue, mais l’affichage dépend de la session, des options du navigateur et du moment de la capture. Un diagnostic solide consiste à combiner des indices et à limiter chaque conclusion à ce qu’ils démontrent, plutôt qu’à prendre une commande ou un message pour une preuve définitive. Ce guide est indicatif : sans examiner l’appareil, le réseau et le service concernés, il est impossible d’attribuer une panne précise. Une lecture attentive peut réduire le nombre de pistes à explorer, mais une mesure isolée ne reste qu’une observation partielle du parcours.