GPU und Grafikkarte sind nicht dasselbe
Im Alltag werden GPU und Grafikkarte oft synonym verwendet, obwohl sie unterschiedliche Dinge beschreiben. Die Grafikkarte ist das physische Bauteil; die GPU ist der Prozessor, der Rechenanweisungen im System ausführt. In manchen Geräten ist die GPU integriert und bildet keine separate Karte, sodass ein vorhandenes GPU nicht zwangsläufig eine dedizierte Karte bedeutet.
Der Unterschied ist wichtig, weil allgemeines Rechnen stattfindet auf dem CPU und in der Software, die ihn nutzt, nicht einfach durch das Installieren einer Karte. Eine GPU kann an Aufgaben außerhalb des Renderings teilnehmen, aber das Programm muss ihr kompatiblen Arbeit zuweisen und die Interaktion mit dem CPU verwalten. Daher verwandelt eine leistungsfähigere Karte keine Anwendung, die weiterhin auf dem CPU läuft.
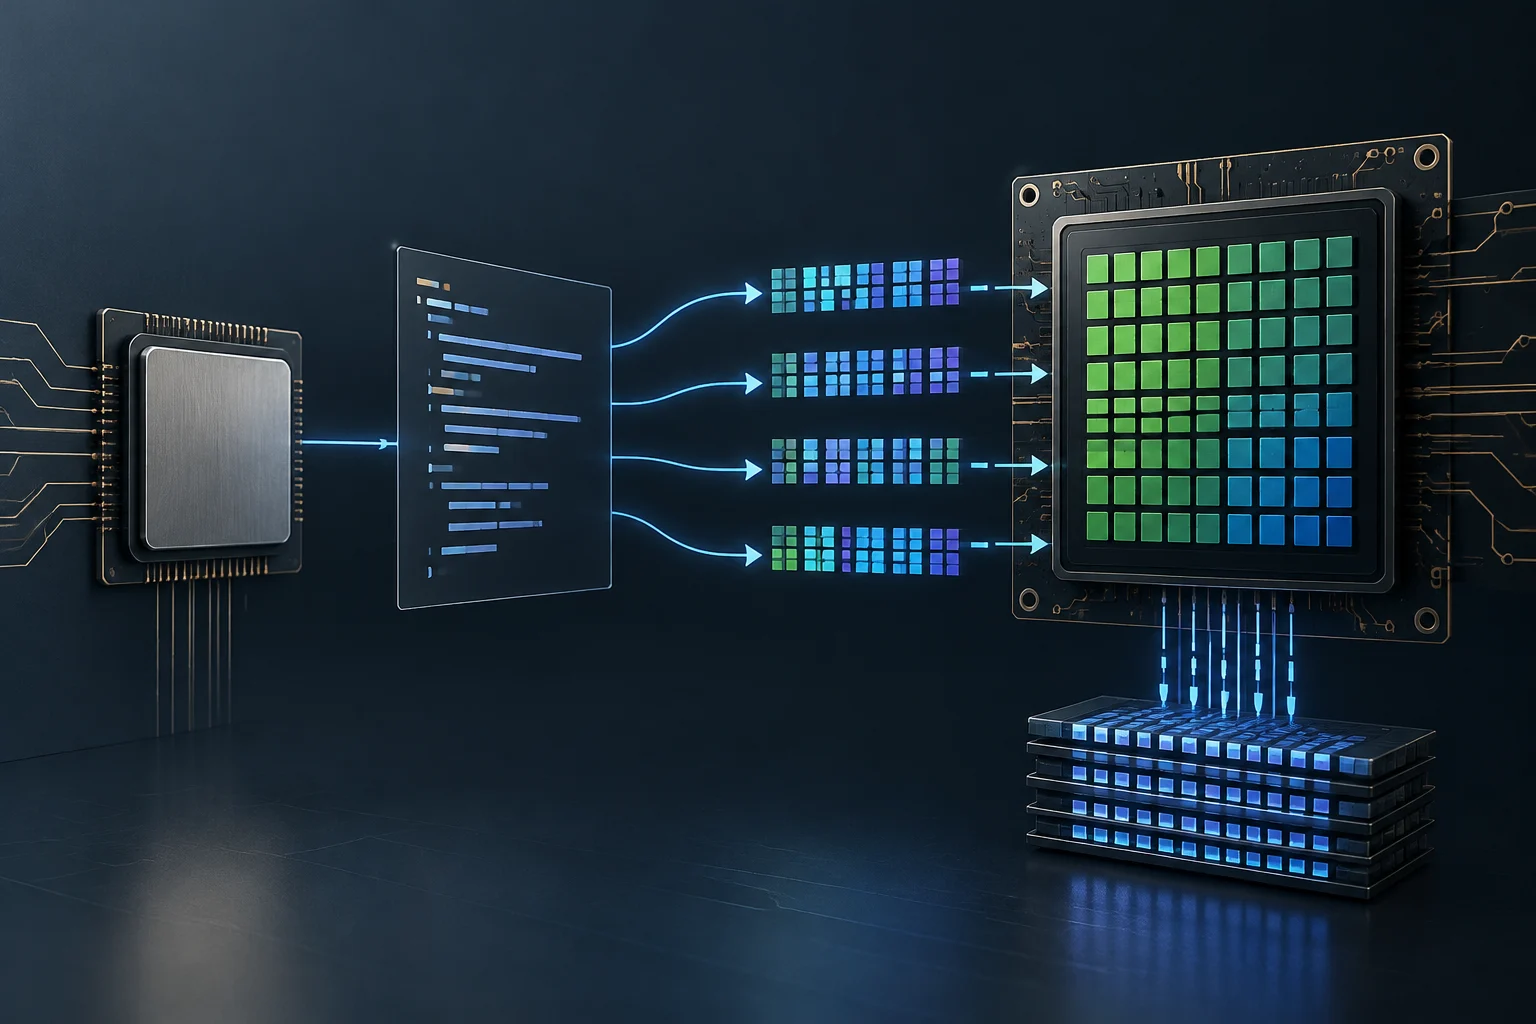
Die sinnvolle Frage ist also nicht nur, wie viele Ressourcen die GPU hat, sondern ob das Programm seinen Arbeitsaufwand teilen, diesen Teil an die GPU senden und das Ergebnis zu vernünftigen Kosten zurückholen kann. Dieser Weg umfasst Designentscheidungen des Programms und der Laufzeitumgebung. Beschleunigung ist eine Eigenschaft der Kombination aus Last, Hardware und Software, nicht eine universelle Funktion, die für alles im System aktiviert wird.
Parallelität begünstigt bestimmte Arbeitstypen
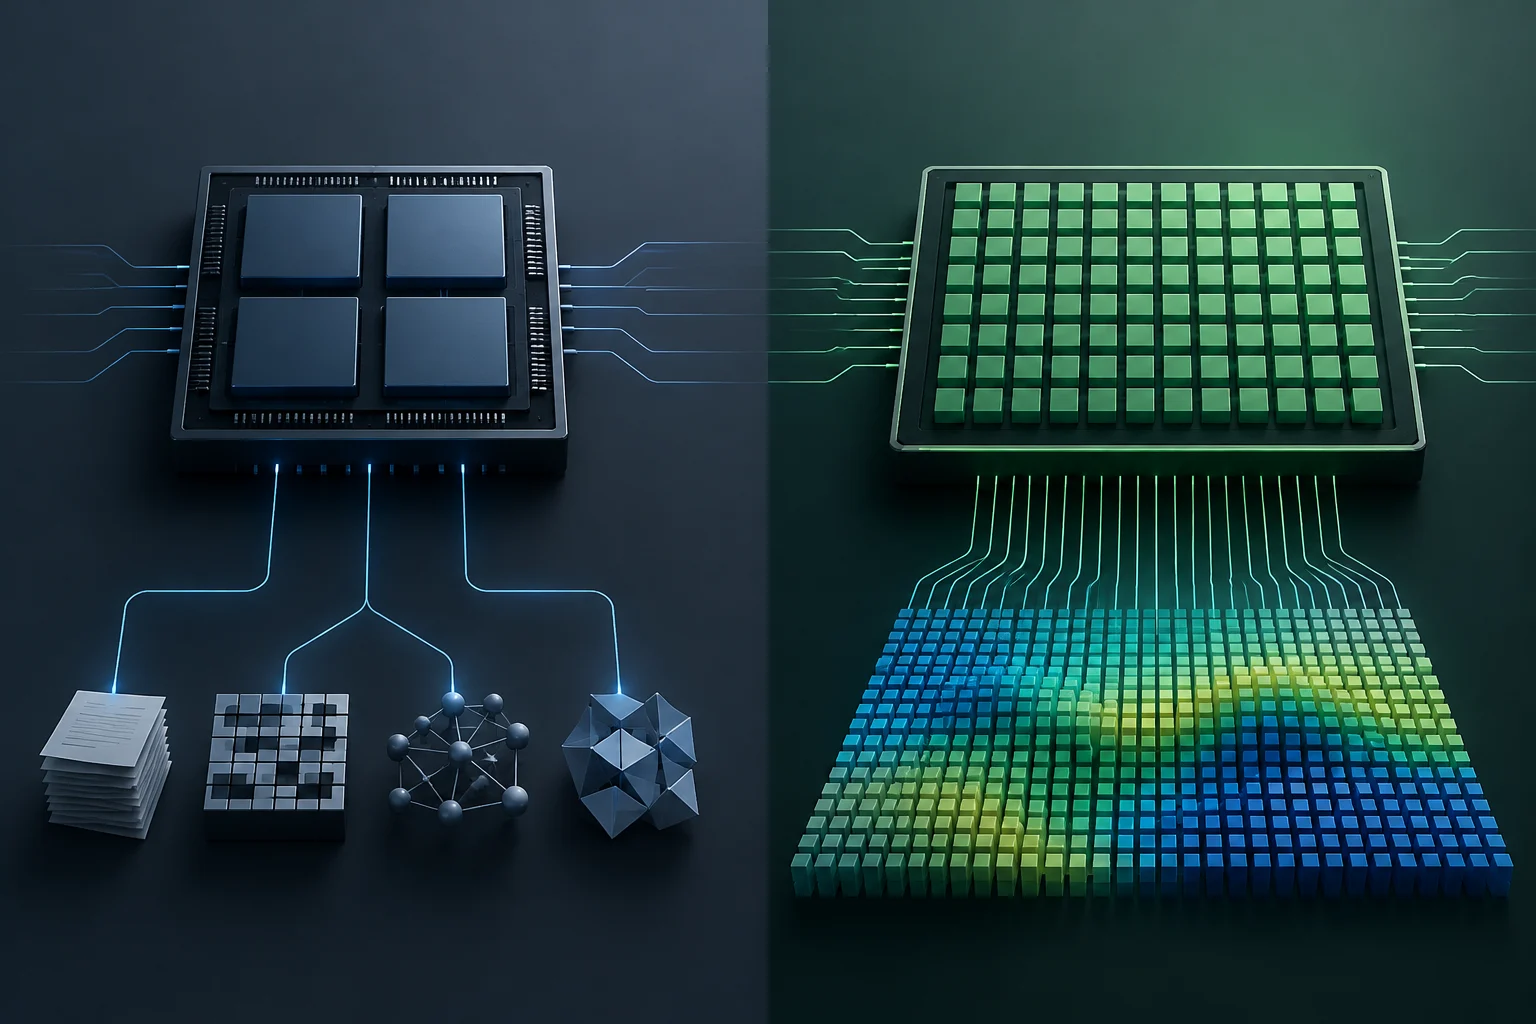
Eine GPU glänzt, wenn sie viele ähnliche Operationen auf unterschiedlichen Datenelementen wiederholen kann. Dieses Muster, genannt Datenparallelismus, tritt beispielsweise auf, wenn eine Operation auf vielen Pixeln oder Matrixelementen angewendet wird. AMDs Dokumentation beschreibt HIP als Modell, das es ermöglicht, datenparallele Algorithmen auf GPU-Architekturen abzubilden; sie weist auch darauf hin, dass diese Einheiten hohe Gesamtleistung anstreben, nicht unbedingt die Ausführung einer einzelnen Anweisung mit der geringsten Latenz.
Der CPU hingegen ist darauf ausgerichtet, einzelne Anweisungen schnell zu beantworten und Kontrollsequenzen auszuführen. Der Unterschied bedeutet nicht, dass ein CPU keine Daten parallel verarbeiten kann oder dass eine GPU keine gesamte bedingte Logik ausführen kann: es bedeutet, dass jedes Design unterschiedliche Prioritäten hat. Der Vorteil erscheint, wenn genügend unabhängige Arbeit vorhanden ist, um viele Recheneinheiten der GPU beschäftigt zu halten.
Wenn jeder Schritt vom vorherigen Ergebnis abhängt oder das Programm viel unregelmäßiges Kontrollflussverhalten aufweist, stehen weniger Operationen für gleichzeitige Ausführung zur Verfügung. Das Ergebnis kann eine moderate Beschleunigung oder keine sein, selbst bei einer leistungsstarken GPU. AMDs Dokumentation warnt zudem, dass das Verschieben von Code, der für CPU gedacht ist, ohne Anpassung die Ressourcen der GPU nicht effizient nutzt. Eine Anwendung zu portieren erfordert Neugestaltung oder Zuordnung der Arbeit, nicht nur den Ort des Kompilierens zu ändern.
Speicher und Transfers verbrauchen ebenfalls Zeit
Eine GPU verwaltet typischerweise Gerätespeicher, getrennt vom Systemspeicher, den der CPU nutzt. Die Daten, die die GPU benötigt, müssen in ihrem Speicherbereich verfügbar sein, und je nach Programmdesign und Plattform kann es erforderlich sein, sie zwischen beiden zu übertragen. AMD identifiziert Zuweisung und Bewegung von Daten zwischen Host- und Gerätespeicher als Aufgaben, die für die Leistung kritisch sein können.
Daher ist die Gesamtzeit nicht nur die Berechnungszeit auf der GPU. Vorbereitung, Kopien und Ergebnis‑Synchronisation zählen ebenfalls. Für eine kurze Aufgabe oder mit kleinen Daten können diese Schritte einen erheblichen Teil der Gesamtzeit ausmachen und den erwarteten Gewinn durch Parallelrechnung verringern. Es kann nicht behauptet werden, dass der Transfer immer die Beschleunigung aufhebt: seine Wirkung hängt von Datenmenge, Austauschhäufigkeit und konkreter Implementierung ab.
Plattformen bieten Mechanismen zur besseren Organisation dieser Bewegung. Die HIP‑Anleitung erwähnt asynchrone Aufrufe, Streams und die Möglichkeit, Transfers mit Berechnung zu überlagern, wenn Ressourcen es zulassen. Die CUDA‑Anleitung dokumentiert ebenfalls asynchrone Kopien innerhalb der GPU‑Speicherhierarchie. Überlappung kann Wartezeiten reduzieren, eliminiert jedoch nicht die Notwendigkeit, Daten zu übertragen, zu koordinieren und sicherzustellen, dass sie rechtzeitig verfügbar sind.
Ohne explizite Unterstützung delegiert das Programm keine Arbeit
Eine GPU erkennt von selbst nicht, welche Teile einer Anwendung schneller wären, und führt sie im Hintergrund aus. Die Software muss einen Ausführungsweg für diesen Prozessor enthalten: dies kann über eine API, Bibliothek oder ein Framework erfolgen, das Zugriff auf die GPU bietet. CUDA ist die Plattform und das Parallelprogrammiermodell von NVIDIA; HIP bietet AMDs Programmiermodell zur Zuweisung datenparalleler Algorithmen an GPUs.
Konkrete Kompatibilität ist wichtig. Dass ein Programm GPU‑Beschleunigung ankündigt, beweist nicht, dass es mit jeder Karte, jedem Betriebssystem oder jeder Treiberversion funktioniert: man muss prüfen, welche Geräte und Ausführungsanbieter diese Anwendung unterstützt. Kompatibilität wird pro Anwendung und Konfiguration geprüft, nicht abgeleitet daraus, dass das System die Karte für Anzeige erkennt.
Windows ML veranschaulicht, wie eine Softwareebene verschiedene Ausführungsmöglichkeiten anbieten kann: Microsoft beschreibt es als lokales KI‑Inference‑Framework, das CPU, GPU oder NPU über optionale Execution Providers nutzt, die von Windows verwaltet werden. Die Dokumentation selbst warnt, dass Leistungsergebnisse je nach Hardware und Modell variieren. Es ist ein Beispiel begrenzt auf KI‑Inference unter Windows, keine Funktion, die automatisch jede Desktop‑Anwendung beschleunigt.
Ein veröffentlichter Befund ist keine allgemeine Garantie
Eine Studie zur seismischen Verarbeitung bietet ein konkretes Beispiel dafür, was eine GPU erreichen kann, wenn Algorithmus und Last passen. Die Autoren verglichen Algorithmen der seismischen Datendekomposition mit Wellpaketen und berichteten Beschleunigungen zwischen zwei und sechs Mal gegenüber einer 20‑Kern‑CPU in Tests mit synthetischen Datensätzen. Diese Zahl beschreibt ein spezifisches Experiment, nicht eine für jede Aufgabe oder GPU anwendbare Zahl.
Die Herstellerdokumentation hilft zu verstehen, warum Ergebnisse variieren: Ausführungsmodell, verfügbares Parallelismus und Speicherverwaltung sind Teil der Leistung. Aber ein Programmierleitfaden ersetzt keinen Test der konkreten Anwendung, und die seismische Studie vergleicht nicht alle Arbeitsarten oder Konfigurationen. Es gibt keinen Grund, den Multiplikator auf Bearbeitung, Spiele, Kompression oder Büroanwendungen zu extrapolieren.
Beim Lesen einer Beschleunigungszahl ist es sinnvoll, zu prüfen, was verglichen wurde, mit welchem Programm und Daten, welcher Prozessor als Referenz verwendet wurde und ob die Zeit Transfers und Vorbereitung einschließt. Es ist auch wichtig, ob eine einzelne Operation gemessen oder der gesamte Fluss, den ein Benutzer nutzt, erfasst wurde. Ohne diese Details kann eine Zahl technisch korrekt für ihren ursprünglichen Fall sein, aber wenig nützlich bei Entscheidungen für einen anderen Computer.
Wie man prüft, ob eine Anwendung die GPU nutzt
Um festzustellen, ob eine konkrete Anwendung profitieren kann, beginnen Sie mit ihrer Dokumentation und den Einstellungen. Suchen Sie nach dem Namen der beschleunigten Funktion und kompatiblen Geräten oder Frameworks. Wenn der Hersteller nur Beschleunigung in einer bestimmten Funktion erwähnt, gehen Sie nicht davon aus, dass die gesamte Anwendung auf der GPU läuft. Die deklarierte Kompatibilität ist das erste Filter, keine Messgröße für Verbesserung.
Definieren Sie anschließend einen Test, der Ihre reale Nutzung repräsentiert. Vergleichen Sie dieselbe Arbeit mit aktivierter und deaktivierter Beschleunigung, wobei Daten, Ausgabeeigenschaften und andere relevante Bedingungen gleich bleiben. Protokollieren Sie die Gesamtzeit und wiederholen Sie den Test: GPU‑Aktivität zeigt nur, dass Arbeit auf dem Accelerator stattgefunden hat, nicht, wie viel Zeit reduziert wurde oder ob die Antwort flüssiger ist.
Ein praktischer Check kann diese Schritte folgen:
- Identifizieren Sie die beschleunigte Funktion und bestätigen Sie, welches GPU-Modell, System und Treiber benötigt wird.
- Überprüfen Sie den Lasttyp: suchen Sie nach wiederholenden Operationen über viele Daten und berücksichtigen Sie, ob das Werk wichtige sequentielle Abhängigkeiten hat.
- Berücksichtigen Sie Transfers: prüfen Sie, ob die Anwendung Daten in GPU‑Speicher hält oder häufig zwischen CPU und GPU verschiebt.
- Messen Sie den gesamten Fluss: vergleichen Sie Zeit von Anfang bis Ende, nicht nur GPU‑Nutzung oder Zeit einer einzelnen Berechnung.
- Entscheiden Sie anhand der beobachteten Verbesserung: eine reproduzierbare Zeitreduktion oder flüssigere Antwort ist wertvoller als die Prozentzahl der Accelerator‑Aktivität.
Die praktische Schlussfolgerung lautet: Kaufen oder konfigurieren Sie keine GPU für eine Anwendung, ohne deren Unterstützung und Ergebnisse bei Ihrer Arbeitslast zu prüfen. Parallelität eröffnet Beschleunigungspotenzial; Software, Speicher und Aufgabenstruktur bestimmen, ob es sich in einer spürbaren Verbesserung niederschlägt.