Unterschiedliche Architekturen für unterschiedliche Zwecke
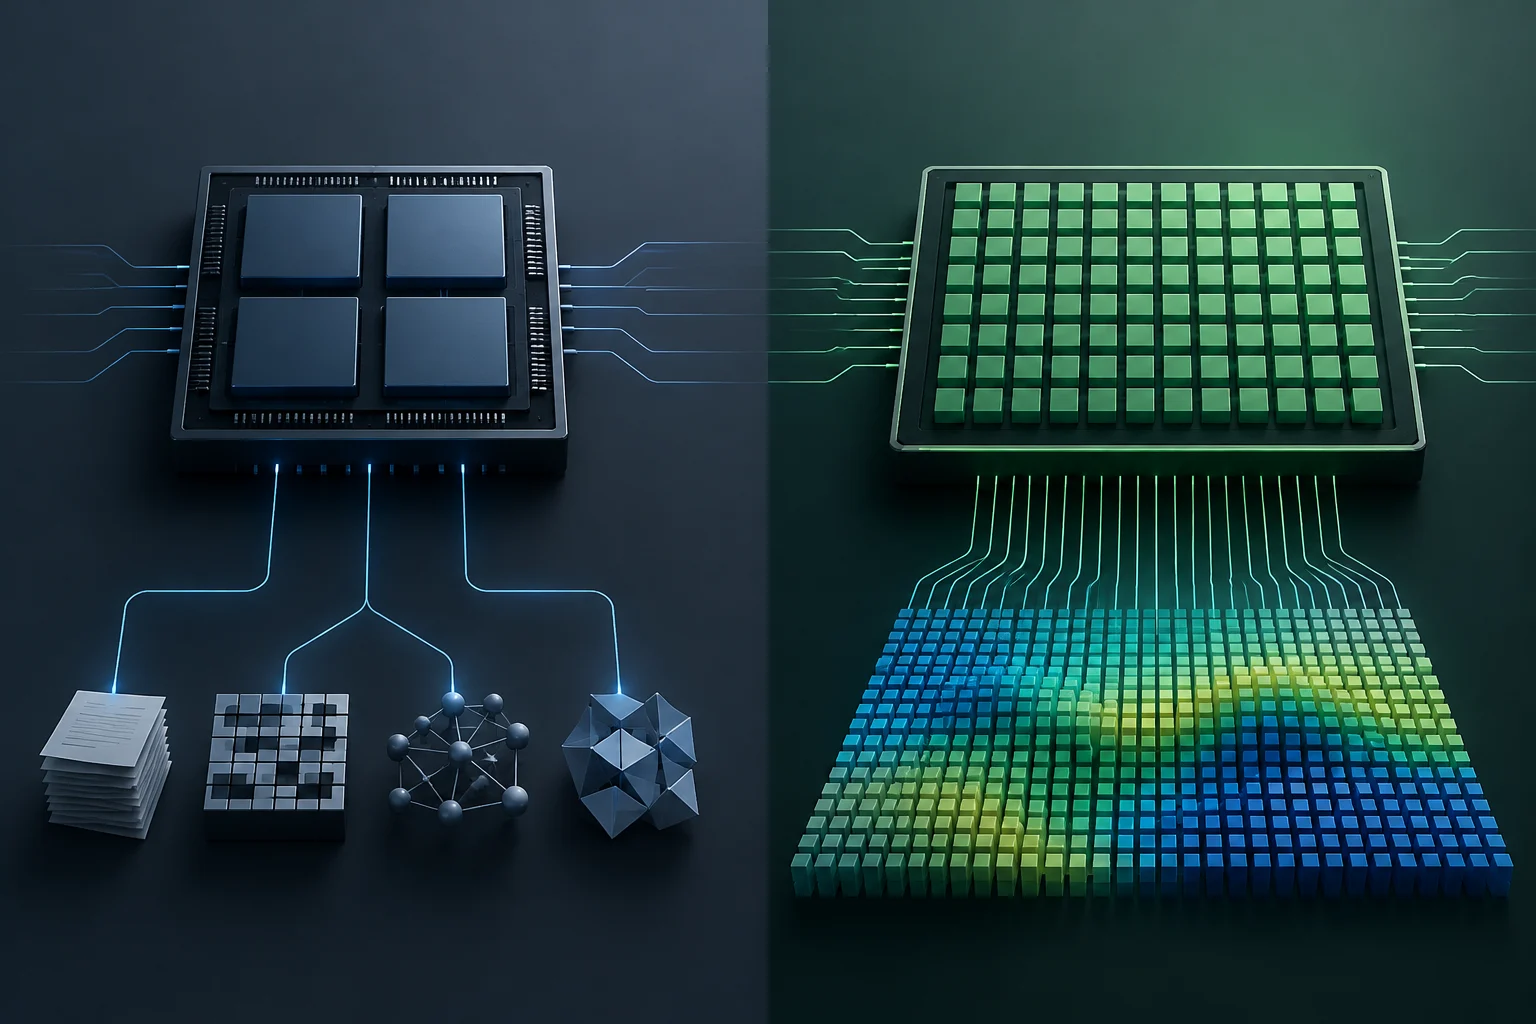
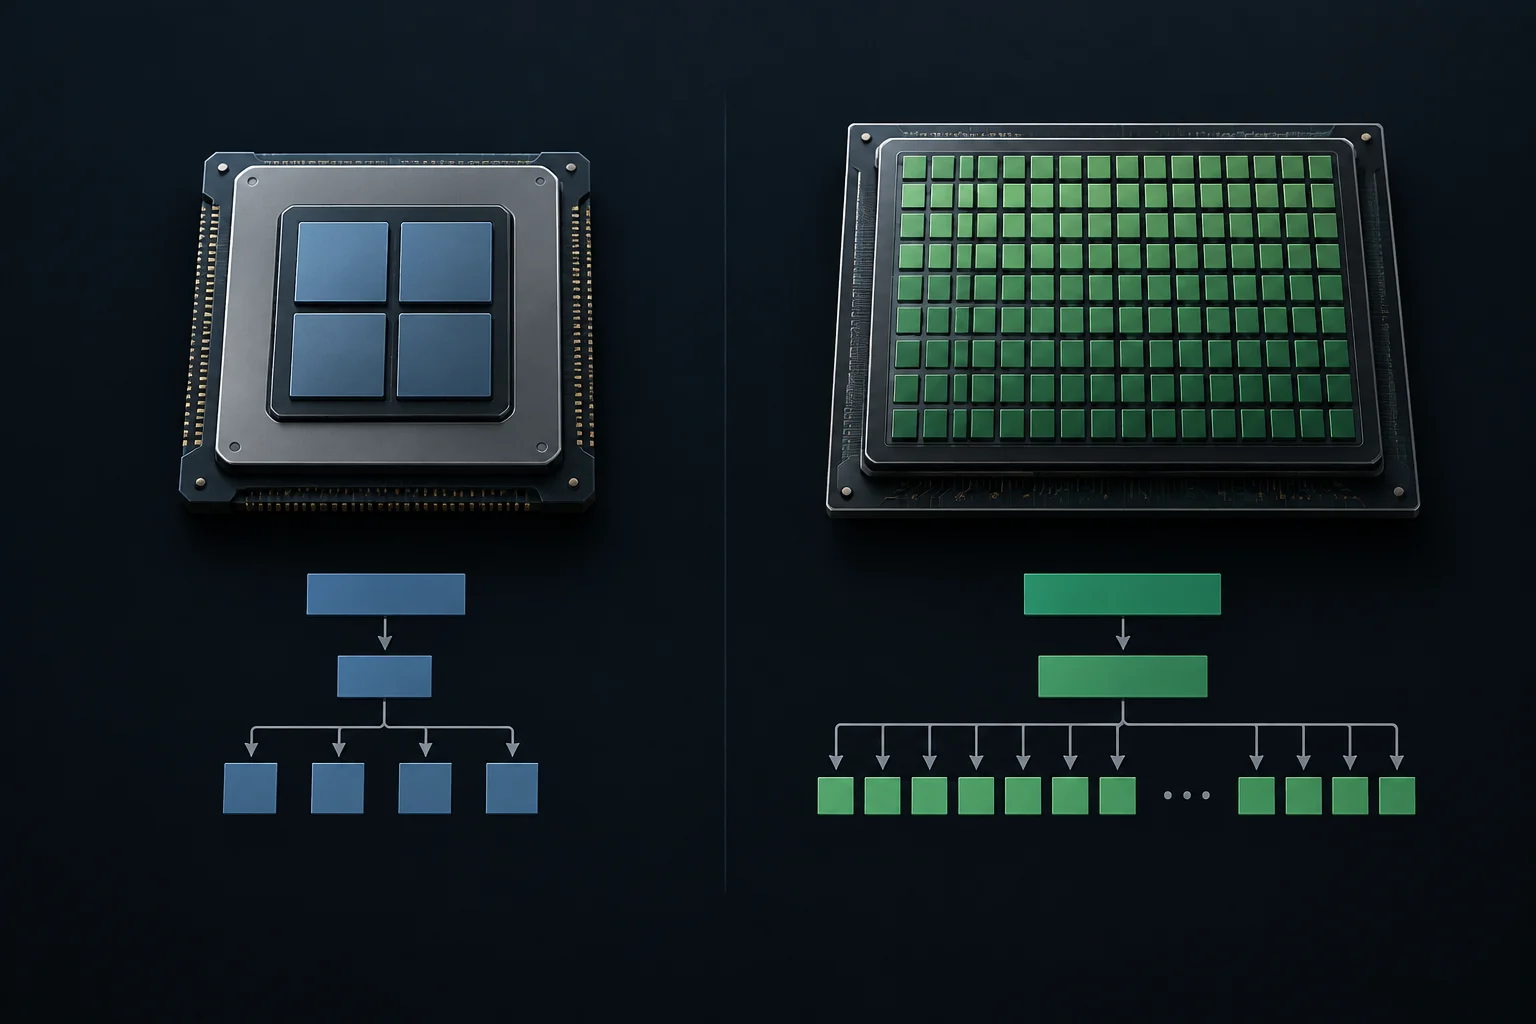
Der grundlegende Unterschied zwischen einer CPU und einer GPU liegt in ihrer Designphilosophie. Während die CPU darauf optimiert ist, komplexe sequentielle Anweisungen mit niedriger Latenz auszuführen, ist die GPU dafür konstruiert, eine große Anzahl einfacher Operationen gleichzeitig durchzuführen. Diese Aufteilung der Rollen ist die Grundlage des heterogenen Rechnens: Jeder Prozessor Typ dient besser einer anderen Klasse von Arbeit, und das System kann sie nach Bedarf kombinieren.
Laut der Dokumentation von Intel sind CPUs das 'Gehirn' des Systems, verantwortlich für Logik und Steuerung, während GPUs viele kleine, spezialisierte Kerne besitzen, die Aufgaben untereinander aufteilen. Diese Struktur ermöglicht es der GPU, Tausende von Ausführungsthreads gleichzeitig zu verwalten, etwas, das eine leistungsstarke CPU mit wenigen Kernen nicht effizient replizieren kann. Die Unterscheidung bedeutet nicht, dass eine Einheit in allen Fällen überlegen ist: Sie zeigt, dass sie für verschiedene Arten der Anweisungsverarbeitung optimiert sind.
Die Rolle der NPU
Neben der CPU und der GPU integrieren moderne Systeme neuronale Verarbeitungseinheiten (NPU). Diese Einheiten sind speziell dafür konzipiert, Arbeitslasten der künstlichen Intelligenz zu beschleunigen und ergänzen die GPU bei Inferenz- und Trainingstasks von Machine-Learning-Modellen. Ihr Vorhandensein fügt eine weitere spezialisierte Verarbeitungsoption hinzu, obwohl die Wahl zwischen den Einheiten immer noch von der konkreten Aufgabe abhängt.
Die sine qua non Bedingung: Parallelität
Damit eine GPU ein Programm beschleunigt, muss die Arbeitslast inhärent parallelisierbar sein. Wenn eine Aufgabe erfordert, dass jeder Schritt vom Ergebnis des vorherigen abhängt (Datenabhängigkeit), kann die GPU sie nicht effizient ausführen, da ihre Kerne darauf warten müssen, dass die Sequenz aufgelöst wird. In diesem Fall beseitigt das Vorhandensein vieler Kerne nicht die Abhängigkeit, die die Einhaltung der Reihenfolge der Operationen erzwingt.
Ideale Aufgaben für eine GPU sind solche, bei denen dieselbe Operation auf Tausende unabhängiger Datenelemente angewendet werden kann, wie die Pixelverarbeitung in einem Bild oder die Matrixmultiplikation im Deep Learning. In diesen Fällen kann die GPU die Arbeit auf viele Threads verteilen und ihre Speicherbandbreite und Rechenkapazität nutzen. Der Vorteil erscheint, wenn genügend unabhängige Arbeit vorhanden ist, um diese Einheiten beschäftigt zu halten.
Allerdings haben viele reale Anwendungen eine Mischung aus sequentiell und parallelem Code. Der sequentielle Teil muss auf der CPU ausgeführt werden, was den Gesamtnutzen der Beschleunigung begrenzt. Dieses Phänomen ist als Amdahls Gesetz bekannt, das besagt, dass die Gesamtverbesserung durch den Anteil der Zeit begrenzt ist, den das Programm im nicht parallelisierbaren Teil verbringt. Daher impliziert die Beschleunigung eines Abschnitts des Programms nicht, dass sich die Gesamtzeit im gleichen Verhältnis reduziert: Der Rest der Arbeit setzt weiterhin eine Grenze.
Die Engstelle des Datentransfers
Eines der größten Hindernisse für die GPU-Beschleunigung ist der Datentransfer zwischen dem Systemspeicher (RAM) und dem GPU-Speicher (VRAM). Diese Kommunikation erfolgt über den PCIe-Bus, der im Vergleich zum internen Speicher der GPU eine begrenzte Bandbreite hat. So kann es vor der Nutzung der parallelen Berechnung notwendig sein, Daten zum Gerät zu bewegen und anschließend Ergebnisse an das System zurückzugeben.
Eine Studie der University of Michigan hebt hervor, dass die begrenzte Speicherkapazität und die CPU-GPU-Kommunikation über PCIe-Links bedeutende Engstellen für Arbeitslasten der Datenanalyse im großen Maßstab sind. Wenn die Übertragungszeit der Daten die Berechnungszeit überschreitet, wartet die GPU und hebt ihren Geschwindigkeitsvorteil auf. In der Praxis zählt die Zeit des gesamten Prozesses, nicht nur, wie lange die GPU braucht, um die Operationen auszuführen, sobald sie die Daten hat.
Optimierungstechniken
Um dieses Problem zu mildern, verwenden Entwickler Techniken wie pinned memory (festgelegter Speicher), die schnellere Übertragungen ermöglichen, indem sie die Zwischenkopie des Betriebssystems vermeiden. Darüber hinaus bieten Frameworks wie CUDA und OpenCL optimierte Eingabe-/Ausgabeprimitive an, um den Einfluss des Datentransfers auf die Gesamtleistung zu minimieren. Diese Tools helfen, die Kosten für den Informationsaustausch zu reduzieren, aber sie lassen die Einschränkungen der Verbindung zwischen CPU und GPU nicht verschwinden.
Das Software-Ökosystem und die APIs
Die Verfügbarkeit einer leistungsstarken GPU ist nutzlos, wenn die Software nicht so konzipiert ist, sie zu nutzen. Programmier-APIs wie CUDA von NVIDIA und OpenCL von Khronos Group stellen die notwendigen Werkzeuge bereit, um Code zu schreiben, der auf der GPU ausgeführt wird. Das Programm muss die Arbeit auf eine mit dem Gerät kompatible Weise ausdrücken und Daten und Operationen so organisieren, dass die parallele Ausführung tragfähig ist.
OpenCL 2.0, spezifiziert von Khronos, führte bedeutende Verbesserungen wie den gemeinsamen virtuellen Speicher ein, der es den Kernen des Hosts und des Geräts ermöglicht, komplexe Datenstrukturen direkt zu teilen. Dies eliminiert kostspielige Datentransfers und vereinfacht die Programmierung heterogener Algorithmen. Durch die Erleichterung des Zugriffs auf geteilte Strukturen kann diese Funktion einen Teil der Komplexität reduzieren, die in der Koordination von CPU und GPU steckt.
Software-Support ist ein kritischer Faktor. Nicht alle Anwendungen haben GPU-optimierte Versionen. In vielen Fällen muss der Entwickler den Code manuell auf die GPU-API portieren, ein Prozess, der tiefes Wissen über die Architektur und die Einschränkungen der Hardware erfordert. Daher garantiert das Vorhandensein einer GPU im System nicht, dass eine bestimmte Anwendung sie nutzt oder dass der angepasste Code eine Verbesserung erzielt.
Beweise und Leistungsmessung
Zu behaupten, dass eine GPU ein Programm beschleunigt, ohne spezifische Tests, ist eine gefährliche Verallgemeinerung. Die Leistung hängt von der konkreten Arbeitslast, der Datengröße, der GPU-Architektur und der Code-Effizienz ab. Es ist auch notwendig, zwischen der Geschwindigkeit einer isolierten Operation und der Zeit, die das gesamte Programm benötigt, zu unterscheiden, da Letztere Aufgaben einschließt, die vielleicht nicht auf der GPU ausgeführt werden.
Eine in Cluster Computing veröffentlichte Studie bewertete die Leistung und den Energieverbrauch in hybriden CPU+GPU-Architekturen und kam zu dem Schluss, dass die Energieeffizienz weitgehend von der spezifischen Arbeitslast abhängt. Was für eine wissenschaftliche Anwendung gut funktioniert, ist für eine andere nicht unbedingt optimal. Der Vergleich muss sowohl die Leistung als auch den Verbrauch berücksichtigen, da eine schnellere Lösung nicht notwendigerweise die energieeffizienteste ist.
Wie man korrekt misst
Um den Nutzen einer GPU zu bewerten, ist es notwendig, die gesamte Ausführungszeit zu messen, einschließlich Initialisierung, Datentransfer und Synchronisation. Profiling-Tools wie NVIDIA Nsight oder der OpenCL Profiler ermöglichen es, Engstellen zu identifizieren und den Code zu optimieren. Die umfassende Messung vermeidet es, der GPU eine Verbesserung zuzuschreiben, die durch die Zeit, die für die Vorbereitung oder den Transport der Daten aufgewendet wird, zunichte gemacht werden könnte.
Es ist entscheidend, die Leistung unter kontrollierten Bedingungen zu vergleichen, wobei dieselben Daten und dieselbe Hardware-Konfiguration verwendet werden. Unterschiede im Betriebssystem, in den Treibern oder in der API-Version können die Ergebnisse erheblich beeinflussen. Das Beibehalten dieser Bedingungen als konstant ermöglicht eine bessere Interpretation der Messungen und eine Bewertung, ob der beobachtete Unterschied auf die untersuchte Implementierung zurückzuführen ist.
Praktische Schlussfolgerungen für den Benutzer
Die Entscheidung, eine GPU zur Beschleunigung einer Aufgabe zu verwenden, ist nicht binär. Sie hängt von einer sorgfältigen Bewertung der Parallelisierbarkeit der Last, der Kosten des Datentransfers und der Verfügbarkeit optimierter Software ab. Es ist auch ratsam zu beobachten, welcher Teil des Programms tatsächlich profitiert, da ein beschleunigter Abschnitt mit anderen koexistieren kann, die weiterhin sequentiell ausgeführt werden.
Für den Endbenutzer lautet die Empfehlung, nicht vorauszusetzen, dass eine leistungsstarke GPU die Leistung aller Anwendungen verbessern wird. Stattdessen ist es besser, nach Anwendungen zu suchen, die explizit für GPU optimiert sind, wie Videobearbeitungsprogramme, Spiele oder künstliche Intelligenz-Tools. Die Leistung hängt ebenfalls von der konkreten Last und davon ab, wie das Programm die Hardware nutzt, daher ersetzt das Kompatibilitätslabel nicht die Bewertung der tatsächlichen Nutzung.
Zusammenfassend ist die GPU ein leistungsfähiges Werkzeug, aber kein Zauberstab. Ihre Wirksamkeit hängt von der Ausrichtung zwischen der Hardware-Architektur, der Natur der Arbeitslast und der Qualität der Programmiersoftware ab. Das Verständnis dieser Grenzen ermöglicht es, fundierte Entscheidungen über die Nutzung des heterogenen Rechnens zu treffen und theoretische Leistung nicht mit einer garantierten Verbesserung in jedem Programm zu verwechseln.