Des architectures distinctes pour des finalités distinctes
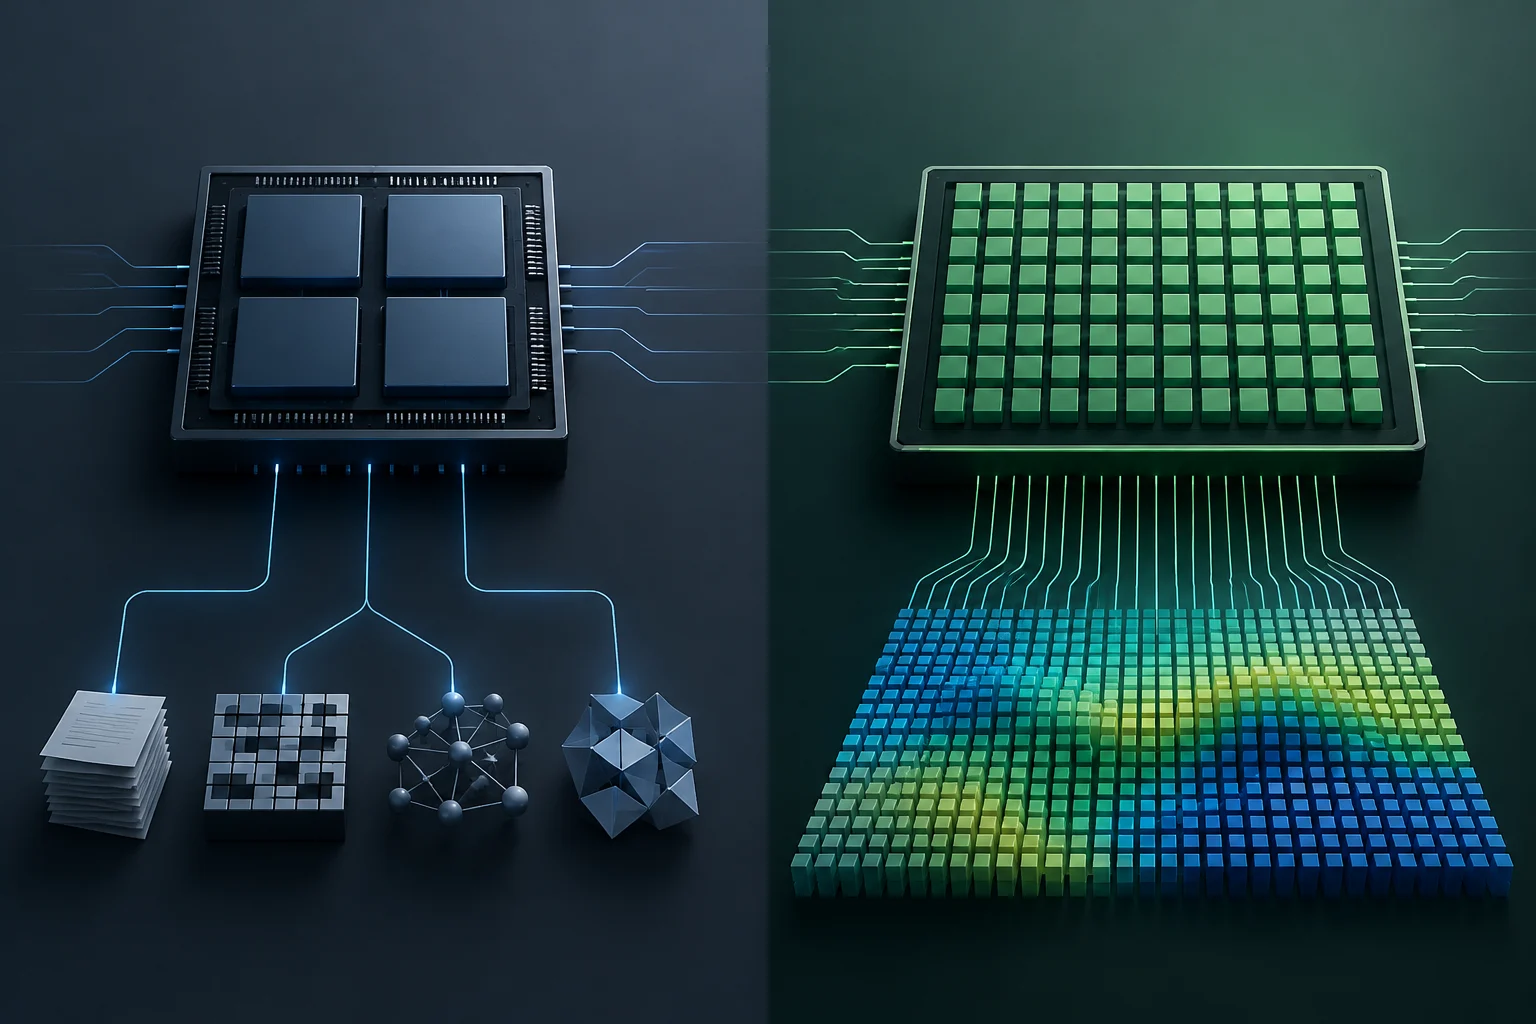
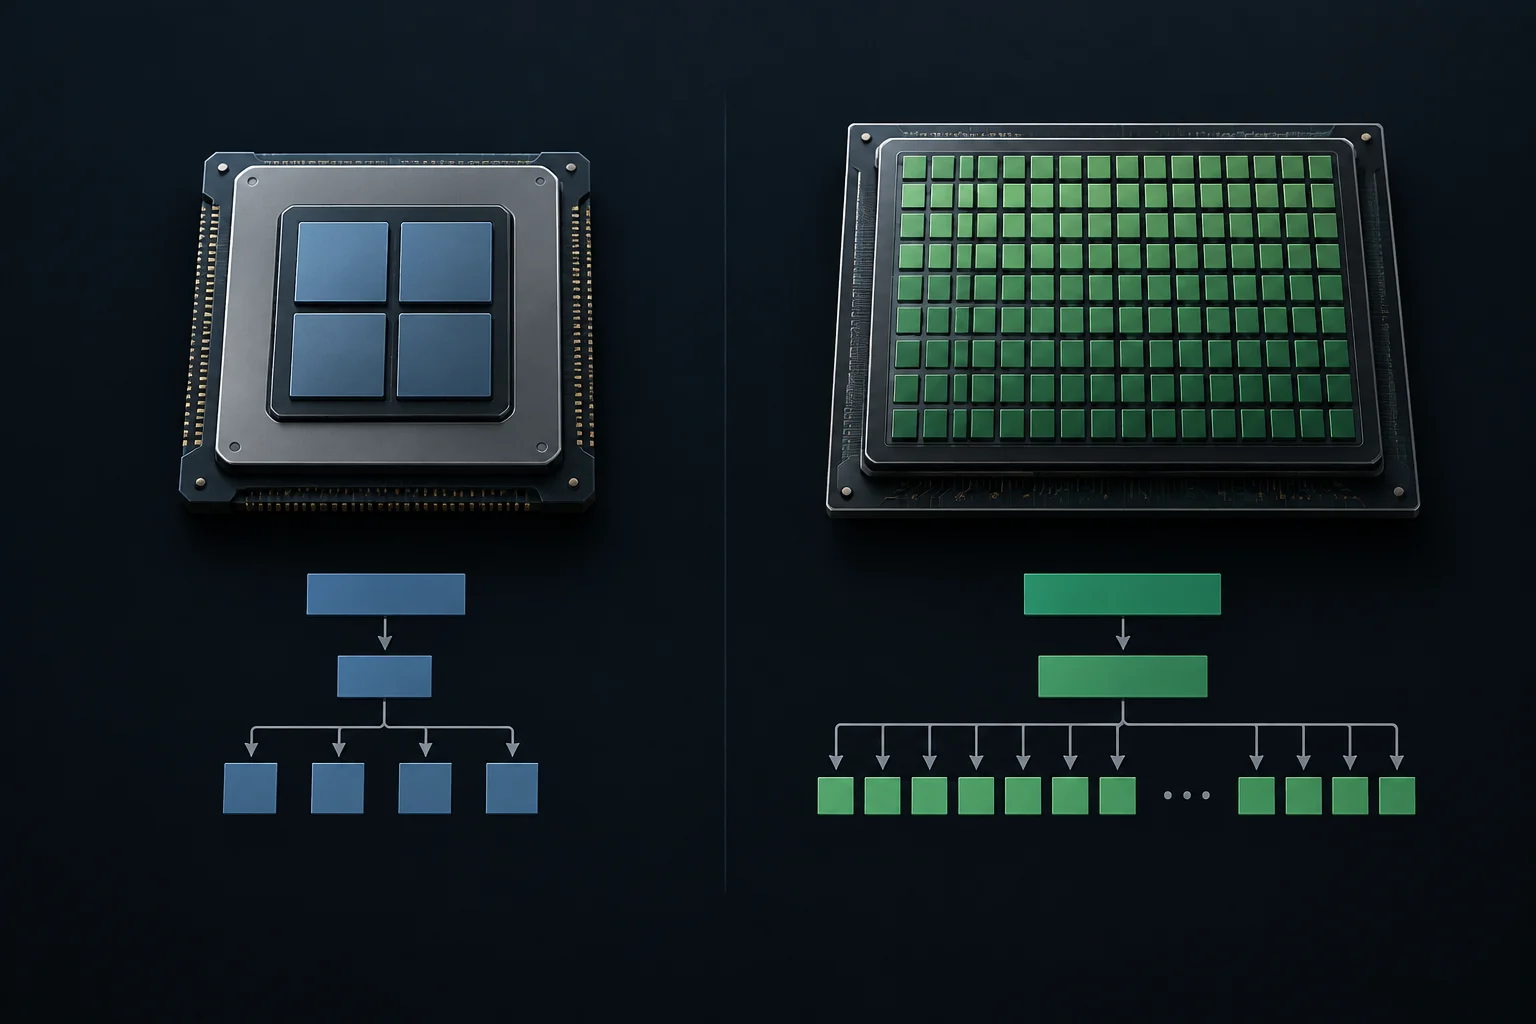
La différence fondamentale entre un CPU et un GPU réside dans leur philosophie de conception. Alors que le CPU est optimisé pour exécuter des instructions séquentielles complexes avec une faible latence, le GPU est conçu pour effectuer un grand nombre d'opérations simples simultanément. Cette division des rôles est la base de l'informatique hétérogène : chaque type de processeur sert mieux une classe différente de travail, et le système peut les combiner selon les besoins.
Selon la documentation d'Intel, les CPU sont le « cerveau » du système, chargés de la logique et du contrôle, tandis que les GPU possèdent de nombreux petits cœurs spécialisés qui divisent les tâches entre eux. Cette structure permet au GPU de gérer des milliers de fils d'exécution à la fois, ce qu'un CPU puissant à peu de cœurs ne peut pas répliquer efficacement. La distinction ne signifie pas qu'une unité est supérieure dans tous les cas : elle indique qu'ils sont optimisés pour des manières différentes de traiter les instructions.
Le rôle de la NPU
En plus du CPU et du GPU, les systèmes modernes intègrent des unités de traitement neuronal (NPU). Ces unités sont spécifiquement conçues pour accélérer les charges de travail d'intelligence artificielle, complétant le GPU dans les tâches d'inférence et d'entraînement des modèles d'apprentissage automatique. Leur présence ajoute une autre option de traitement spécialisé, bien que le choix entre les unités dépende toujours de la tâche concrète.
La condition sine qua non : le parallélisme
Pour qu'un GPU accélère un programme, la charge de travail doit être intrinsèquement parallélisable. Si une tâche exige que chaque étape dépende du résultat de la précédente (dépendance de données), le GPU ne peut pas l'exécuter efficacement car ses cœurs doivent attendre que la séquence se résolve. Dans ce cas, disposer de nombreux cœurs n'élimine pas la dépendance qui oblige à respecter l'ordre des opérations.
Les tâches idéales pour un GPU sont celles où l'on peut appliquer la même opération à des milliers d'éléments de données indépendants, comme le traitement de pixels dans une image ou la multiplication de matrices dans l'apprentissage profond. Dans ces cas, le GPU peut répartir le travail entre de nombreux fils et exploiter sa bande passante mémoire et sa capacité de calcul. L'avantage apparaît lorsqu'il y a suffisamment de travail indépendant pour occuper ces unités.
Cependant, de nombreuses applications du monde réel ont un mélange de code séquentiel et parallèle. La partie séquentielle doit s'exécuter sur le CPU, ce qui limite le bénéfice total de l'accélération. Ce phénomène est connu sous le nom de loi d'Amdahl, qui établit que l'amélioration totale est limitée par la fraction de temps que le programme passe dans la partie non parallélisable. Ainsi, accélérer une section du programme n'implique pas que le temps total se réduise dans la même proportion : le reste du travail continue d'imposer une limite.
Le goulot d'étranglement du transfert de données
L'un des plus grands obstacles à l'accélération par GPU est le transfert de données entre la mémoire du système (RAM) et la mémoire du GPU (VRAM). Cette communication se fait via le bus PCIe, qui a une bande passante limitée par rapport à la mémoire interne du GPU. Ainsi, avant d'exploiter le calcul parallèle, il peut être nécessaire de déplacer les données vers le périphérique et, ensuite, de renvoyer les résultats au système.
Une étude de l'Université du Michigan souligne que la capacité mémoire limitée et la communication CPU-GPU via les liens PCIe sont des goulots d'étranglement significatifs pour les charges de travail d'analyse de données à grande échelle. Si le temps de transfert de données dépasse le temps de calcul, le GPU attend, annulant son avantage de vitesse. En pratique, le temps du processus complet compte, pas seulement le temps que le GPU met à exécuter les opérations une fois qu'il a les données.
Techniques d'optimisation
Pour atténuer ce problème, les développeurs utilisent des techniques comme la mémoire épinglée (pinned memory), qui permet des transferts plus rapides en évitant la copie intermédiaire du système d'exploitation. De plus, des frameworks comme CUDA et OpenCL offrent des primitives d'entrée/sortie optimisées pour minimiser l'impact du transfert de données sur les performances globales. Ces outils aident à réduire le coût du déplacement d'informations, mais ne font pas disparaître les limitations du lien entre le CPU et le GPU.
L'écosystème logiciel et les API
La disponibilité d'un GPU puissant est inutile si le logiciel n'est pas conçu pour l'exploiter. Les API de programmation comme CUDA de NVIDIA et OpenCL du Khronos Group fournissent les outils nécessaires pour écrire du code qui s'exécute sur le GPU. Le programme doit exprimer le travail d'une manière compatible avec le périphérique et organiser les données et les opérations pour que l'exécution parallèle soit viable.
OpenCL 2.0, spécifié par Khronos, a introduit des améliorations significatives comme la mémoire virtuelle partagée, qui permet aux cœurs de l'hôte et du périphérique de partager directement des structures de données complexes. Cela élimine les transferts de données coûteux et simplifie la programmation d'algorithmes hétérogènes. En facilitant l'accès aux structures partagées, cette caractéristique peut réduire une partie de la complexité impliquée dans la coordination CPU et GPU.
Le support logiciel est un facteur critique. Toutes les applications n'ont pas de versions optimisées pour GPU. Dans de nombreux cas, le développeur doit porter manuellement le code vers l'API du GPU, un processus qui exige une connaissance approfondie de l'architecture et des limitations du matériel. Par conséquent, la présence d'un GPU dans le système ne garantit pas qu'une application spécifique l'utilise ni que le code adapté obtienne une amélioration.
Preuves et mesure des performances
Affirmer qu'un GPU accélère un programme sans tests spécifiques est une généralisation dangereuse. Les performances dépendent de la charge de travail concrète, de la taille des données, de l'architecture du GPU et de l'efficacité du code. Il est également nécessaire de distinguer la vitesse d'une opération isolée et le temps que met le programme complet, car ce dernier inclut des tâches qui ne s'exécutent peut-être pas sur le GPU.
Une étude publiée dans Cluster Computing a évalué les performances et la consommation d'énergie dans les architectures hybrides CPU+GPU, concluant que l'efficacité énergétique dépend en grande partie de la charge de travail spécifique. Ce qui fonctionne bien pour une application scientifique peut ne pas être optimal pour une autre. La comparaison doit tenir compte à la fois des performances et de la consommation, car une solution plus rapide n'est pas nécessairement la plus efficace en énergie.
Comment mesurer correctement
Pour évaluer le bénéfice d'un GPU, il est nécessaire de mesurer le temps d'exécution total, y compris l'initialisation, le transfert de données et la synchronisation. Les outils de profilage comme NVIDIA Nsight ou le OpenCL Profiler permettent d'identifier les goulots d'étranglement et d'optimiser le code. La mesure intégrale évite d'attribuer au GPU une amélioration qui pourrait être compensée par le temps consacré à préparer ou déplacer les données.
Il est crucial de comparer les performances dans des conditions contrôlées, en utilisant les mêmes données et la même configuration matérielle. Les différences dans le système d'exploitation, les pilotes ou la version de l'API peuvent influencer significativement les résultats. Maintenir ces conditions constantes permet une meilleure interprétation des mesures et une évaluation de savoir si la différence observée est due à l'implémentation examinée.
Conclusions pratiques pour l'utilisateur
La décision d'utiliser un GPU pour accélérer une tâche n'est pas binaire. Elle dépend d'une évaluation soigneuse de la parallélisabilité de la charge, du coût du transfert de données et de la disponibilité d'un logiciel optimisé. Il convient également d'observer quelle partie du programme bénéficie réellement, car une section accélérée peut coexister avec d'autres qui continuent de s'exécuter de manière séquentielle.
Pour l'utilisateur final, la recommandation est de ne pas supposer qu'un GPU puissant améliorera les performances de toutes les applications. Au contraire, il est préférable de rechercher des applications explicitement optimisées pour GPU, comme les éditeurs vidéo, les jeux ou les outils d'intelligence artificielle. Les performances dépendront également de la charge concrète et de la manière dont le programme exploite le matériel, donc l'étiquette de compatibilité ne remplace pas l'évaluation de l'usage réel.
En résumé, le GPU est un outil puissant, mais pas une baguette magique. Son efficacité dépend de l'alignement entre l'architecture du matériel, la nature de la charge de travail et la qualité du logiciel de programmation. Comprendre ces limites permet de prendre des décisions éclairées sur l'utilisation de l'informatique hétérogène et d'éviter de confondre la puissance théorique avec une amélioration garantie dans n'importe quel programme.