Arquitecturas distintas para propósitos distintos
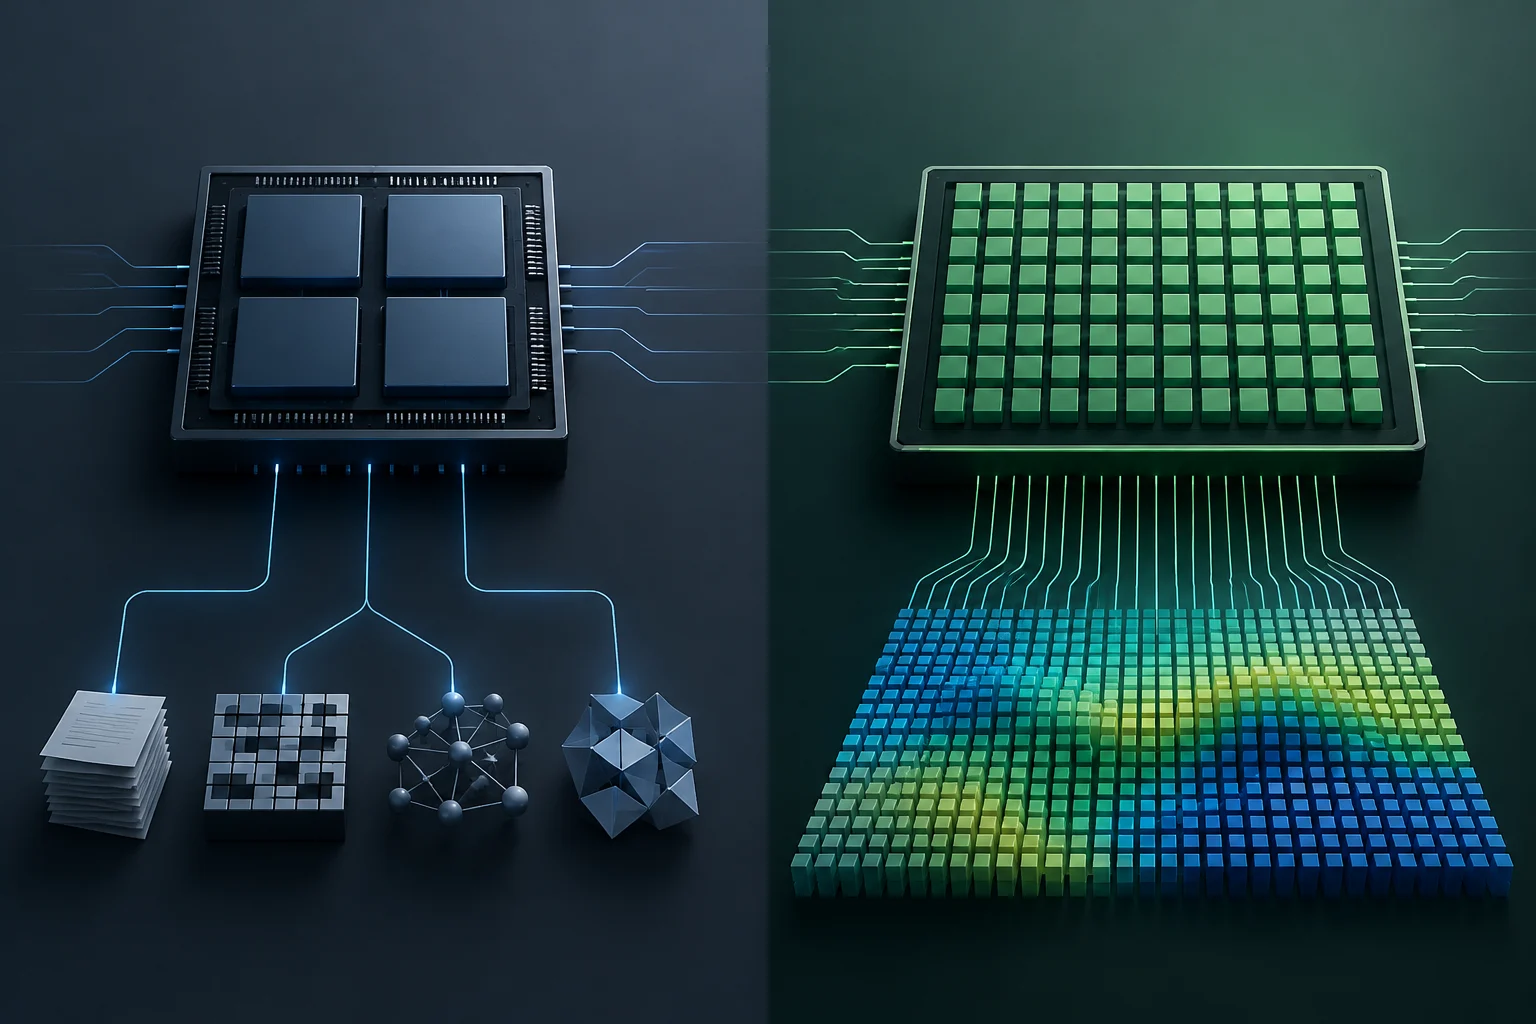
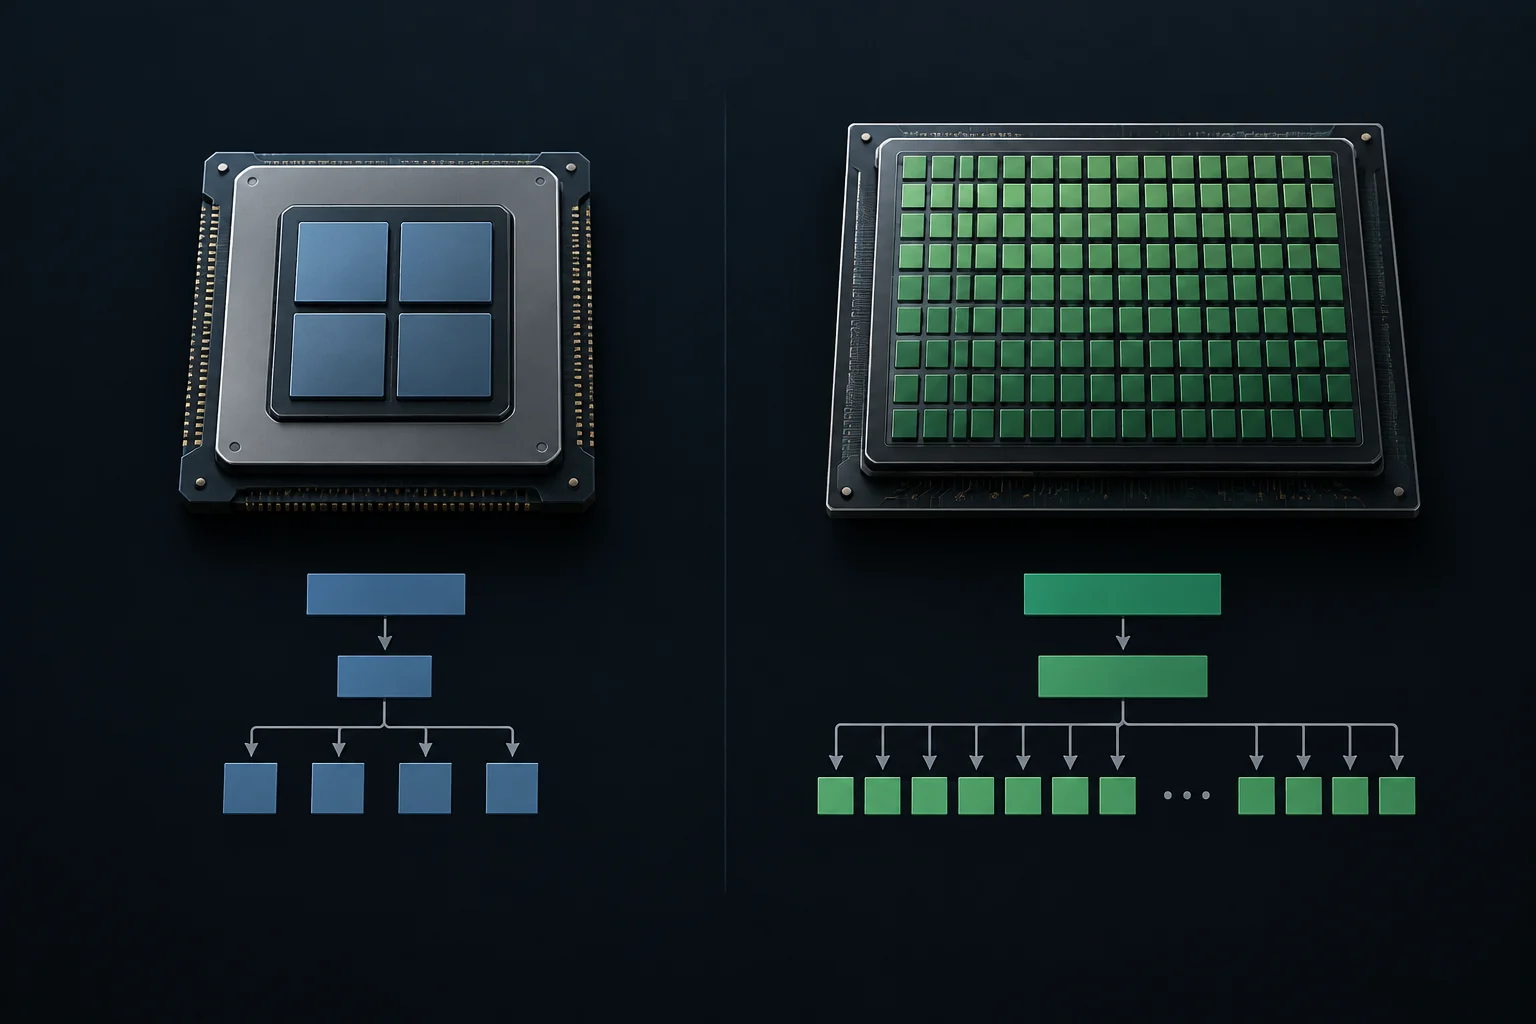
La diferencia fundamental entre una CPU y una GPU radica en su filosofía de diseño. Mientras que la CPU está optimizada para ejecutar instrucciones secuenciales complejas con baja latencia, la GPU está construida para realizar un gran número de operaciones simples de forma simultánea. Esta división de roles es la base de la computación heterogénea: cada tipo de procesador atiende mejor una clase distinta de trabajo, y el sistema puede combinarlos según las necesidades.
Según la documentación de Intel, las CPUs son el 'cerebro' del sistema, encargadas de la lógica y el control, mientras que las GPUs poseen muchos núcleos pequeños y especializados que dividen las tareas entre sí. Esta estructura permite a la GPU manejar miles de hilos de ejecución a la vez, algo que una CPU de pocos núcleos potentes no puede replicar eficientemente. La distinción no significa que una unidad sea superior en todos los casos: indica que están optimizadas para formas diferentes de procesar instrucciones.
El papel de la NPU
Además de la CPU y la GPU, los sistemas modernos incorporan unidades de procesamiento neuronal (NPU). Estas unidades están diseñadas específicamente para acelerar cargas de trabajo de inteligencia artificial, complementando a la GPU en tareas de inferencia y entrenamiento de modelos de aprendizaje automático. Su presencia añade otra opción de procesamiento especializado, aunque la elección entre unidades sigue dependiendo de la tarea concreta.
La condición sine qua non: paralelismo
Para que una GPU acelere un programa, la carga de trabajo debe ser intrínsecamente paralelizable. Si una tarea requiere que cada paso dependa del resultado del anterior (dependencia de datos), la GPU no puede ejecutarla de forma eficiente porque sus núcleos deben esperar a que se resuelva la secuencia. En ese caso, disponer de muchos núcleos no elimina la dependencia que obliga a respetar el orden de las operaciones.
Las tareas ideales para GPU son aquellas donde se puede aplicar la misma operación a miles de elementos de datos independientes, como el procesamiento de píxeles en una imagen o la multiplicación de matrices en el aprendizaje profundo. En estos casos, la GPU puede repartir el trabajo entre muchos hilos y aprovechar su ancho de banda de memoria y su capacidad de cálculo. La ventaja aparece cuando hay suficiente trabajo independiente para mantener ocupadas esas unidades.
Sin embargo, muchas aplicaciones del mundo real tienen una mezcla de código secuencial y paralelo. La parte secuencial debe ejecutarse en la CPU, lo que limita el beneficio total de la aceleración. Este fenómeno se conoce como la ley de Amdahl, que establece que la mejora total está limitada por la fracción de tiempo que el programa pasa en la parte no paralelizable. Por eso, acelerar una sección del programa no implica que el tiempo total se reduzca en la misma proporción: el resto del trabajo continúa imponiendo un límite.
El cuello de botella de la transferencia de datos
Uno de los mayores obstáculos para la aceleración por GPU es la transferencia de datos entre la memoria del sistema (RAM) y la memoria de la GPU (VRAM). Esta comunicación se realiza a través del bus PCIe, que tiene un ancho de banda limitado en comparación con la memoria interna de la GPU. Así, antes de aprovechar el cálculo paralelo, puede ser necesario mover datos hacia el dispositivo y, después, devolver resultados al sistema.
Un estudio de la Universidad de Michigan destaca que la capacidad de memoria limitada y la comunicación CPU-GPU a través de enlaces PCIe son cuellos de botella significativos para cargas de trabajo de análisis de datos a gran escala. Si el tiempo de transferencia de datos supera al tiempo de cálculo, la GPU se queda esperando, anulando su ventaja de velocidad. En la práctica, importa el tiempo del proceso completo, no solo cuánto tarda la GPU en ejecutar las operaciones una vez que tiene los datos.
Técnicas de optimización
Para mitigar este problema, los desarrolladores utilizan técnicas como la pinned memory (memoria fijada), que permite transferencias más rápidas al evitar la copia intermedia del sistema operativo. Además, frameworks como CUDA y OpenCL ofrecen primitivas de entrada/salida optimizadas para minimizar el impacto de la transferencia de datos en el rendimiento total. Estas herramientas ayudan a reducir el costo de mover información, pero no hacen desaparecer las limitaciones del enlace entre la CPU y la GPU.
El ecosistema de software y las API
La disponibilidad de una GPU potente es inútil si el software no está diseñado para aprovecharla. Las API de programación como CUDA de NVIDIA y OpenCL de Khronos Group proporcionan las herramientas necesarias para escribir código que se ejecute en la GPU. El programa debe expresar el trabajo de una manera compatible con el dispositivo y organizar los datos y las operaciones para que la ejecución paralela resulte viable.
OpenCL 2.0, especificado por Khronos, introdujo mejoras significativas como la memoria virtual compartida, que permite a los núcleos del host y del dispositivo compartir estructuras de datos complejas directamente. Esto elimina transferencias de datos costosas y simplifica la programación de algoritmos heterogéneos. Al facilitar el acceso a estructuras compartidas, esta característica puede reducir parte de la complejidad que supone coordinar CPU y GPU.
El soporte de software es un factor crítico. No todas las aplicaciones tienen versiones optimizadas para GPU. En muchos casos, el desarrollador debe portar manualmente el código a la API de la GPU, un proceso que requiere un profundo conocimiento de la arquitectura y las limitaciones del hardware. Por tanto, la presencia de una GPU en el equipo no garantiza que una aplicación concreta la utilice ni que el código adaptado obtenga una mejora.
Evidencia y medición del rendimiento
Afirmar que una GPU acelera un programa sin pruebas específicas es una generalización peligrosa. El rendimiento depende de la carga de trabajo concreta, el tamaño de los datos, la arquitectura de la GPU y la eficiencia del código. También es necesario distinguir entre la velocidad de una operación aislada y el tiempo que tarda el programa completo, porque este último incluye tareas que quizá no se ejecuten en la GPU.
Un estudio publicado en Cluster Computing evaluó el rendimiento y el consumo de energía en arquitecturas híbridas CPU+GPU, concluyendo que la eficiencia energética depende en gran medida de la carga de trabajo específica. Lo que funciona bien para una aplicación científica puede no ser óptimo para otra. La comparación debe atender tanto al rendimiento como al consumo, pues una solución más rápida no necesariamente es la más eficiente en energía.
Cómo medir correctamente
Para evaluar el beneficio de una GPU, es necesario medir el tiempo de ejecución total, incluyendo la inicialización, la transferencia de datos y la sincronización. Herramientas de perfilado como NVIDIA Nsight o el OpenCL Profiler permiten identificar cuellos de botella y optimizar el código. La medición integral evita atribuir a la GPU una mejora que podría quedar contrarrestada por el tiempo dedicado a preparar o mover los datos.
Es crucial comparar el rendimiento en condiciones controladas, utilizando los mismos datos y la misma configuración de hardware. Las diferencias en el sistema operativo, los controladores o la versión de la API pueden influir significativamente en los resultados. Mantener constantes esas condiciones permite interpretar mejor las mediciones y evaluar si la diferencia observada se debe a la implementación examinada.
Conclusiones prácticas para el usuario
La decisión de utilizar una GPU para acelerar una tarea no es binaria. Depende de una evaluación cuidadosa de la paralelizabilidad de la carga, el costo de la transferencia de datos y la disponibilidad de software optimizado. También conviene observar qué parte del programa se beneficia realmente, porque una sección acelerada puede coexistir con otras que siguen ejecutándose de forma secuencial.
Para el usuario final, la recomendación es no asumir que una GPU potente mejorará el rendimiento de todas las aplicaciones. En lugar de ello, es mejor buscar aplicaciones que estén explícitamente optimizadas para GPU, como los editores de video, los juegos o las herramientas de inteligencia artificial. El rendimiento dependerá igualmente de la carga concreta y de cómo el programa aproveche el hardware, así que la etiqueta de compatibilidad no sustituye la evaluación del uso real.
En resumen, la GPU es una herramienta poderosa, pero no una varita mágica. Su eficacia depende de la alineación entre la arquitectura del hardware, la naturaleza de la carga de trabajo y la calidad del software de programación. Entender estos límites permite tomar decisiones informadas sobre el uso de la computación heterogénea y evitar confundir potencia teórica con una mejora garantizada en cualquier programa.