Architetture distinte per scopi distinti
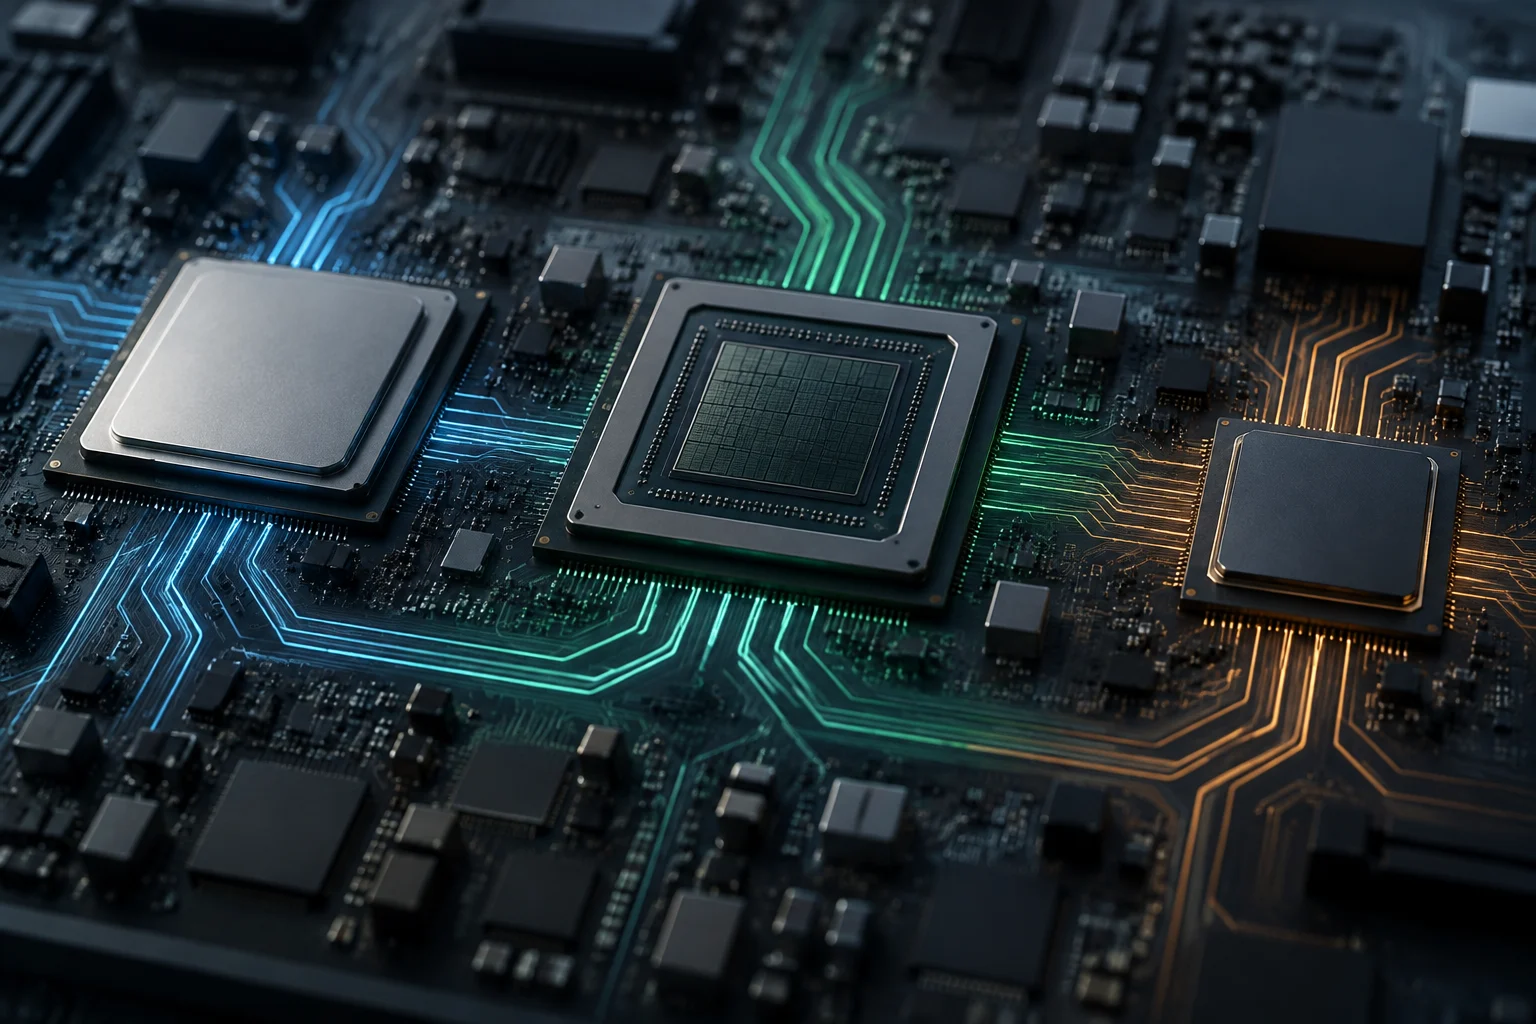
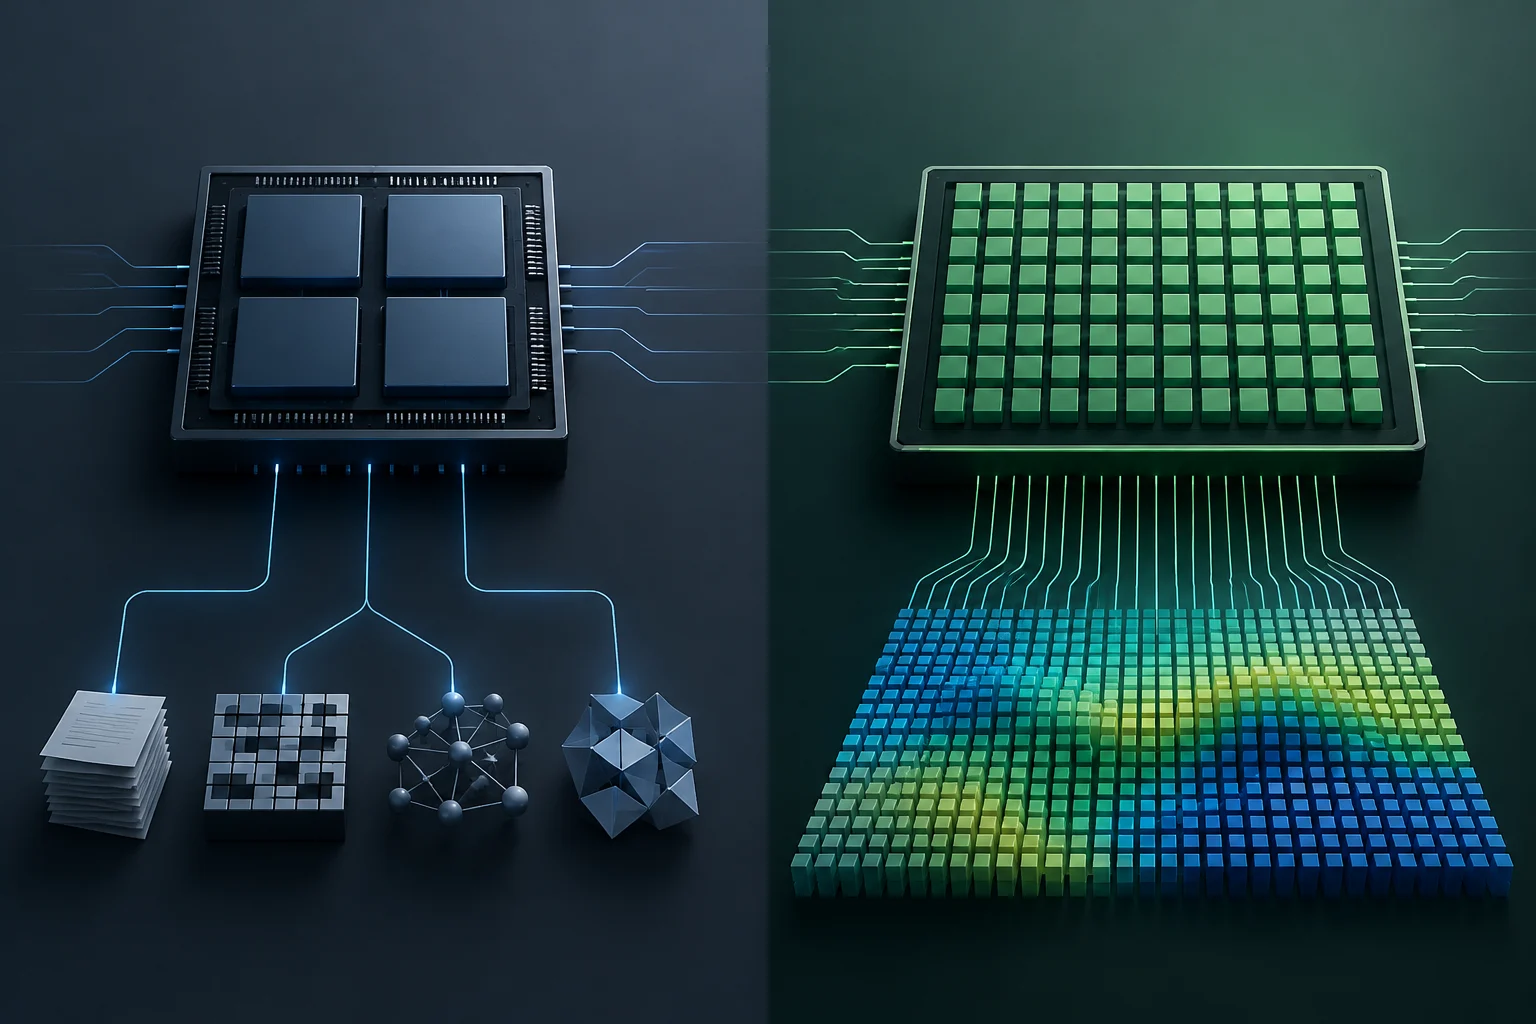
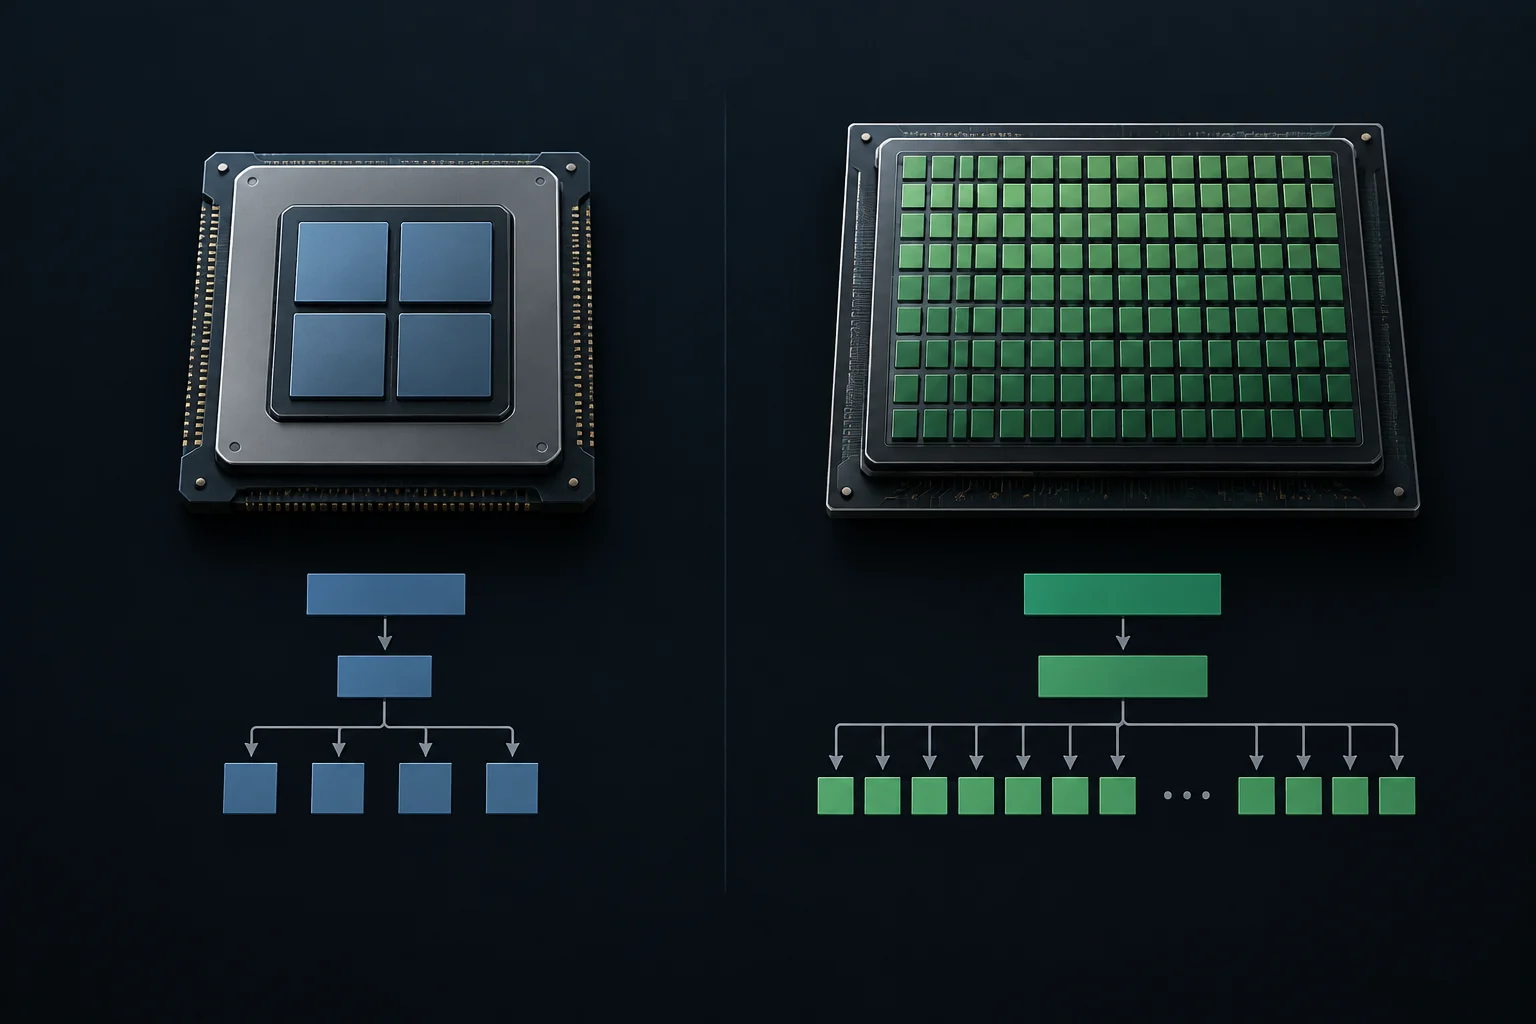
La differenza fondamentale tra una CPU e una GPU risiede nella loro filosofia di progettazione. Mentre la CPU è ottimizzata per eseguire istruzioni sequenziali complesse con bassa latenza, la GPU è costruita per eseguire un gran numero di operazioni semplici simultaneamente. Questa divisione dei ruoli è la base del calcolo eterogeneo: ogni tipo di processore serve meglio una classe diversa di lavoro, e il sistema può combinarli secondo le esigenze.
Secondo la documentazione di Intel, le CPU sono il 'cervello' del sistema, responsabili della logica e del controllo, mentre le GPU possiedono molti piccoli core specializzati che dividono i compiti tra loro. Questa struttura consente alla GPU di gestire migliaia di thread di esecuzione contemporaneamente, qualcosa che una CPU potente con pochi core non può replicare efficientemente. La distinzione non significa che un'unità sia superiore in tutti i casi: indica che sono ottimizzate per modi diversi di elaborare le istruzioni.
Il ruolo della NPU
Oltre alla CPU e alla GPU, i sistemi moderni incorporano unità di elaborazione neurale (NPU). Queste unità sono progettate specificamente per accelerare i carichi di lavoro di intelligenza artificiale, completando la GPU nelle attività di inferenza e addestramento dei modelli di machine learning. La loro presenza aggiunge un'altra opzione di elaborazione specializzata, sebbene la scelta tra le unità dipenda ancora dal compito specifico.
La condizione sine qua non: il parallelismo
Perché una GPU acceleri un programma, il carico di lavoro deve essere intrinsecamente parallelizzabile. Se un compito richiede che ogni passo dipenda dal risultato del precedente (dipendenza dei dati), la GPU non può eseguirlo in modo efficiente perché i suoi core devono aspettare che la sequenza si risolva. In quel caso, disporre di molti core non elimina la dipendenza che obbliga a rispettare l'ordine delle operazioni.
I compiti ideali per una GPU sono quelli in cui si può applicare la stessa operazione a migliaia di elementi di dati indipendenti, come l'elaborazione dei pixel in un'immagine o la moltiplicazione di matrici nel deep learning. In questi casi, la GPU può distribuire il lavoro tra molti thread e sfruttare la sua banda passante di memoria e la sua capacità di calcolo. Il vantaggio appare quando c'è abbastanza lavoro indipendente per mantenere occupate quelle unità.
Tuttavia, molte applicazioni del mondo reale hanno una miscela di codice sequenziale e parallelo. La parte sequenziale deve essere eseguita sulla CPU, il che limita il beneficio totale dell'accelerazione. Questo fenomeno è noto come legge di Amdahl, che stabilisce che il miglioramento totale è limitato dalla frazione di tempo che il programma passa nella parte non parallelizzabile. Pertanto, accelerare una sezione del programma non implica che il tempo totale si riduca nella stessa proporzione: il resto del lavoro continua a imporre un limite.
Il collo di bottiglia del trasferimento dati
Uno dei maggiori ostacoli all'accelerazione GPU è il trasferimento di dati tra la memoria di sistema (RAM) e la memoria della GPU (VRAM). Questa comunicazione avviene tramite il bus PCIe, che ha una banda passante limitata rispetto alla memoria interna della GPU. Così, prima di sfruttare il calcolo parallelo, potrebbe essere necessario spostare i dati verso il dispositivo e, successivamente, restituire i risultati al sistema.
Uno studio dell'Università del Michigan evidenzia che la capacità di memoria limitata e la comunicazione CPU-GPU tramite collegamenti PCIe sono colli di bottiglia significativi per i carichi di lavoro di analisi dati su larga scala. Se il tempo di trasferimento dei dati supera il tempo di calcolo, la GPU resta in attesa, annullando il suo vantaggio di velocità. Nella pratica, conta il tempo del processo completo, non solo quanto tempo impiega la GPU a eseguire le operazioni una volta che ha i dati.
Tecniche di ottimizzazione
Per mitigare questo problema, gli sviluppatori utilizzano tecniche come la memoria fissa (pinned memory), che consente trasferimenti più rapidi evitando la copia intermedia del sistema operativo. Inoltre, framework come CUDA e OpenCL offrono primitive di input/output ottimizzate per minimizzare l'impatto del trasferimento dati sulle prestazioni complessive. Questi strumenti aiutano a ridurre il costo dello spostamento delle informazioni, ma non fanno scomparire i limiti del collegamento tra CPU e GPU.
L'ecosistema software e le API
La disponibilità di una GPU potente è inutile se il software non è progettato per sfruttarla. Le API di programmazione come CUDA di NVIDIA e OpenCL del Khronos Group forniscono gli strumenti necessari per scrivere codice che si esegue sulla GPU. Il programma deve esprimere il lavoro in un modo compatibile con il dispositivo e organizzare i dati e le operazioni in modo che l'esecuzione parallela sia fattibile.
OpenCL 2.0, specificato da Khronos, ha introdotto miglioramenti significativi come la memoria virtuale condivisa, che consente ai core dell'host e del dispositivo di condividere direttamente strutture di dati complesse. Questo elimina i trasferimenti di dati costosi e semplifica la programmazione di algoritmi eterogenei. Facilitando l'accesso alle strutture condivise, questa caratteristica può ridurre parte della complessità coinvolta nel coordinare CPU e GPU.
Il supporto software è un fattore critico. Non tutte le applicazioni hanno versioni ottimizzate per GPU. In molti casi, lo sviluppatore deve portare manualmente il codice all'API della GPU, un processo che richiede una profonda conoscenza dell'architettura e dei limiti dell'hardware. Pertanto, la presenza di una GPU nel sistema non garantisce che un'applicazione specifica la utilizzi né che il codice adattato ottenga un miglioramento.
Evidenze e misurazione delle prestazioni
Affermare che una GPU accelera un programma senza test specifici è una generalizzazione pericolosa. Le prestazioni dipendono dal carico di lavoro specifico, dalla dimensione dei dati, dall'architettura della GPU e dall'efficienza del codice. È anche necessario distinguere tra la velocità di un'operazione isolata e il tempo che impiega il programma completo, perché quest'ultimo include attività che forse non si eseguono sulla GPU.
Uno studio pubblicato su Cluster Computing ha valutato le prestazioni e il consumo energetico in architetture ibride CPU+GPU, concludendo che l'efficienza energetica dipende in gran parte dal carico di lavoro specifico. Ciò che funziona bene per un'applicazione scientifica potrebbe non essere ottimale per un'altra. Il confronto deve considerare sia le prestazioni che il consumo, poiché una soluzione più rapida non è necessariamente la più efficiente in termini energetici.
Come misurare correttamente
Per valutare il beneficio di una GPU, è necessario misurare il tempo di esecuzione totale, inclusa l'inizializzazione, il trasferimento dei dati e la sincronizzazione. Gli strumenti di profiling come NVIDIA Nsight o l'OpenCL Profiler consentono di identificare i colli di bottiglia e ottimizzare il codice. La misurazione integrale evita di attribuire alla GPU un miglioramento che potrebbe essere compensato dal tempo dedicato a preparare o spostare i dati.
È cruciale confrontare le prestazioni in condizioni controllate, utilizzando gli stessi dati e la stessa configurazione hardware. Le differenze nel sistema operativo, nei driver o nella versione dell'API possono influenzare significativamente i risultati. Mantenere costanti queste condizioni consente di interpretare meglio le misurazioni e valutare se la differenza osservata è dovuta all'implementazione esaminata.
Conclusioni pratiche per l'utente
La decisione di utilizzare una GPU per accelerare un compito non è binaria. Dipende da una valutazione accurata della parallelizzabilità del carico, dal costo del trasferimento dei dati e dalla disponibilità di software ottimizzato. È anche opportuno osservare quale parte del programma beneficia realmente, perché una sezione accelerata può coesistere con altre che continuano a eseguirsi in modo sequenziale.
Per l'utente finale, la raccomandazione è di non dare per scontato che una GPU potente migliorerà le prestazioni di tutte le applicazioni. Al contrario, è meglio cercare applicazioni esplicitamente ottimizzate per GPU, come gli editor video, i giochi o gli strumenti di intelligenza artificiale. Le prestazioni dipenderanno anche dal carico specifico e da come il programma sfrutti l'hardware, quindi l'etichetta di compatibilità non sostituisce la valutazione dell'uso reale.
In sintesi, la GPU è uno strumento potente, ma non una bacchetta magica. La sua efficacia dipende dall'allineamento tra l'architettura dell'hardware, la natura del carico di lavoro e la qualità del software di programmazione. Comprendere questi limiti consente di prendere decisioni informate sull'uso del calcolo eterogeneo ed evitare di confondere la potenza teorica con un miglioramento garantito in qualsiasi programma.