Arquiteturas distintas para propósitos distintos
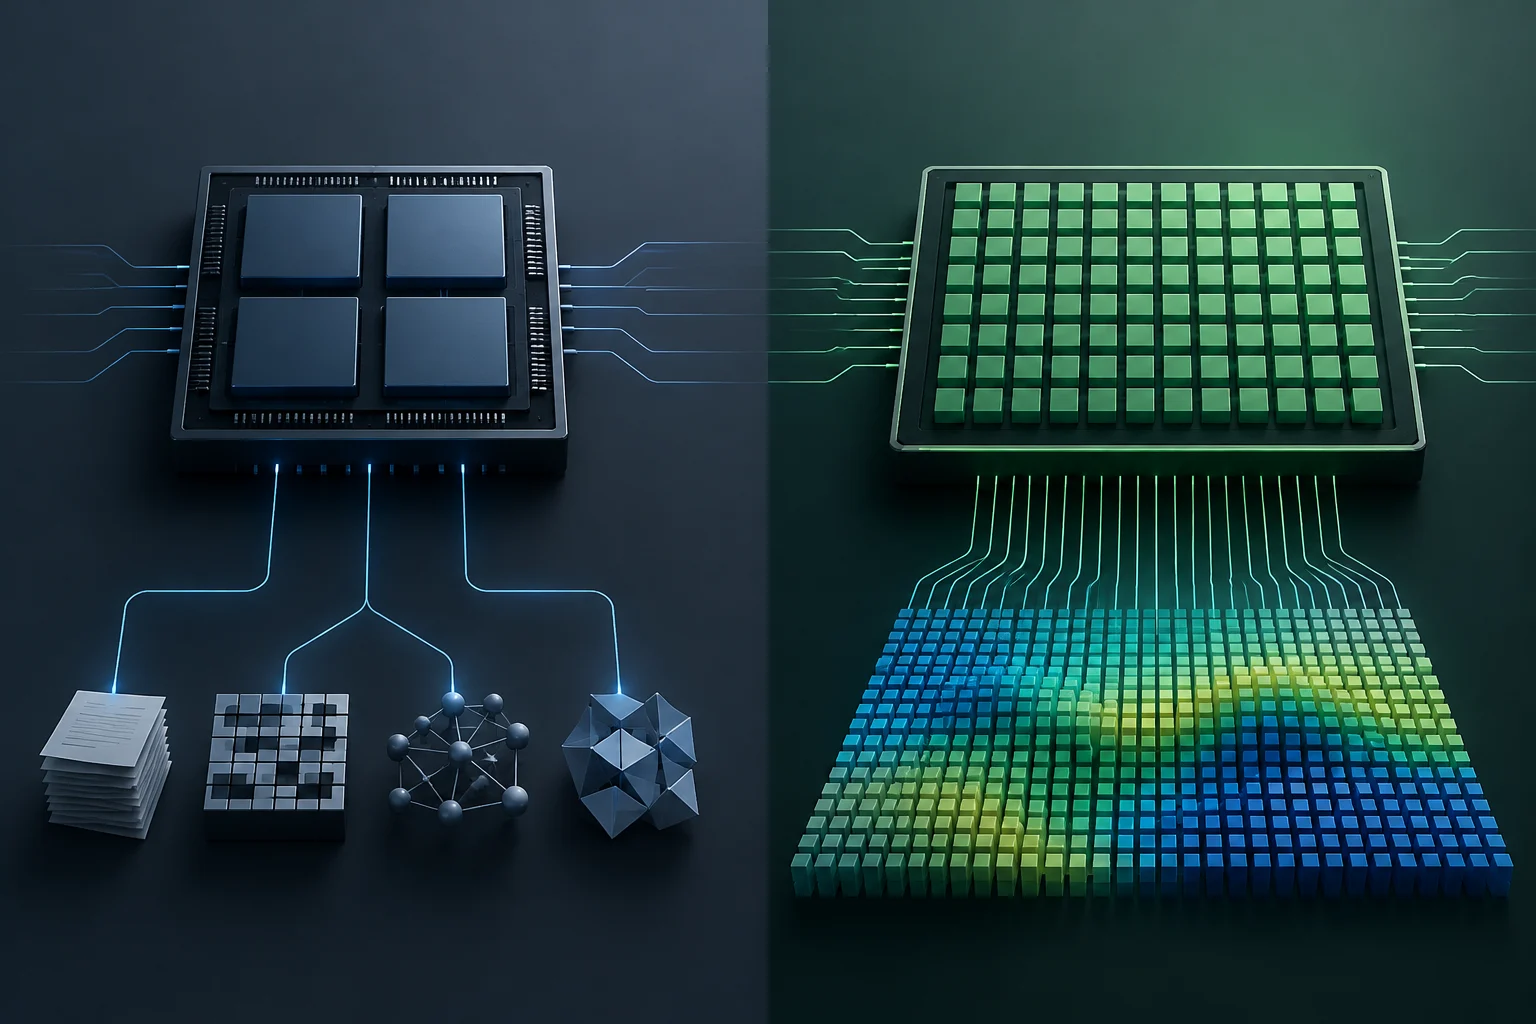
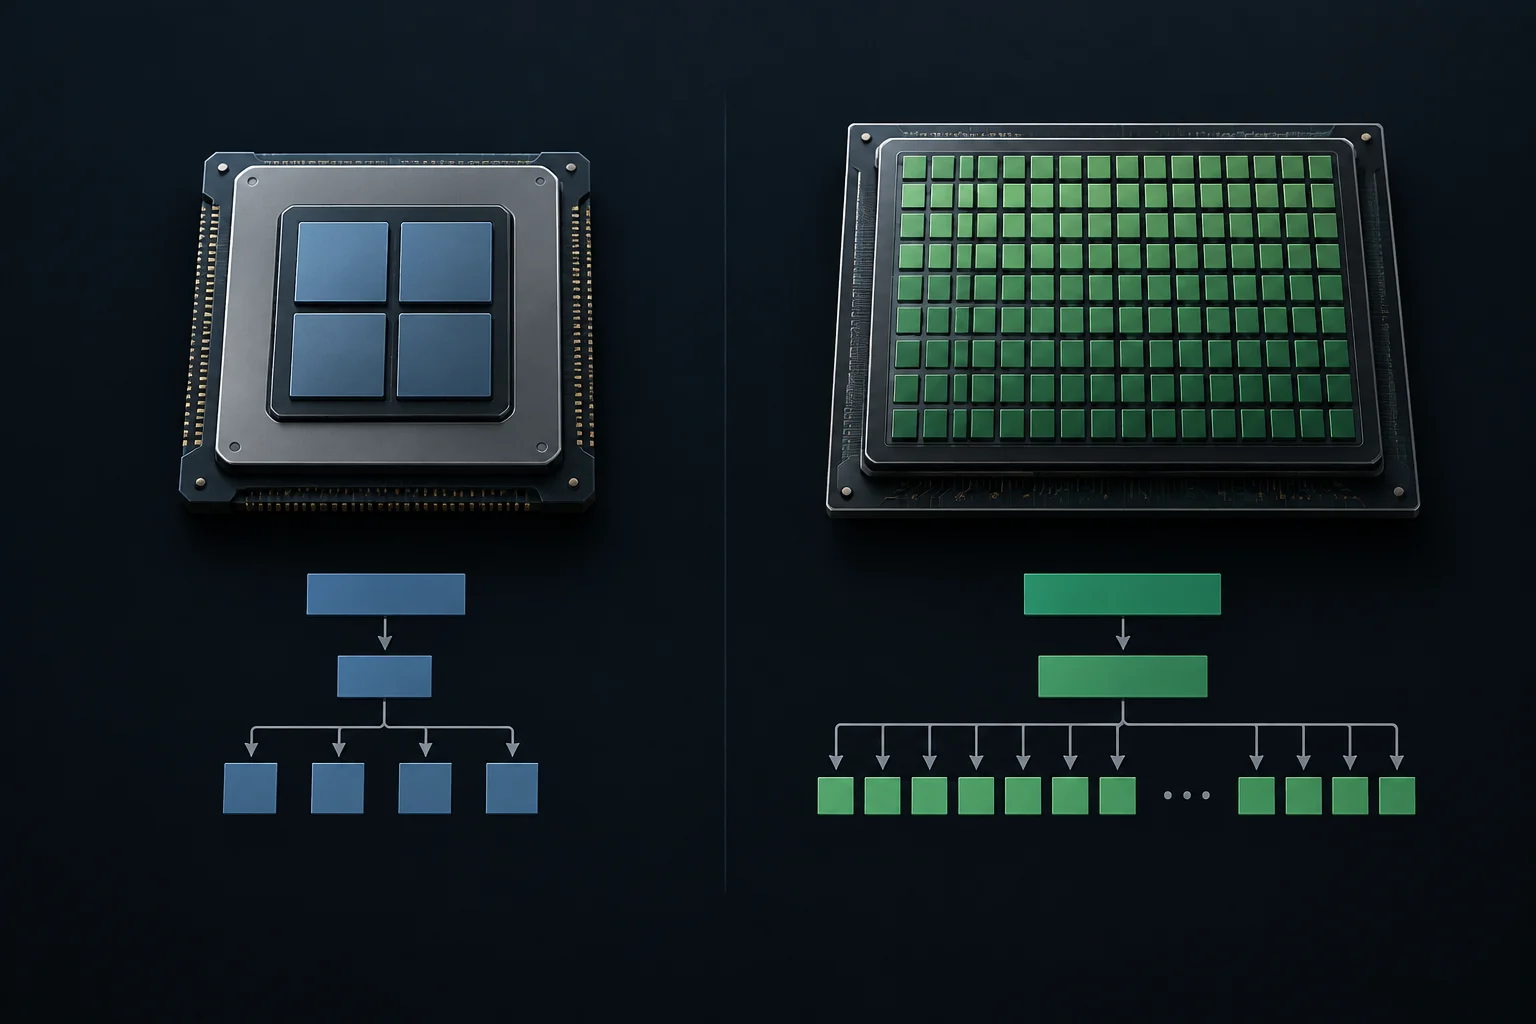
A diferença fundamental entre uma CPU e uma GPU reside na sua filosofia de design. Enquanto a CPU é otimizada para executar instruções sequenciais complexas com baixa latência, a GPU é construída para realizar um grande número de operações simples simultaneamente. Esta divisão de papéis é a base da computação heterogênea: cada tipo de processador atende melhor a uma classe distinta de trabalho, e o sistema pode combiná-los conforme as necessidades.
De acordo com a documentação da Intel, as CPUs são o 'cérebro' do sistema, encarregadas da lógica e do controle, enquanto as GPUs possuem muitos núcleos pequenos e especializados que dividem as tarefas entre si. Esta estrutura permite que a GPU gerencie milhares de threads de execução ao mesmo tempo, algo que uma CPU poderosa de poucos núcleos não pode replicar eficientemente. A distinção não significa que uma unidade seja superior em todos os casos: indica que estão otimizadas para formas diferentes de processar instruções.
O papel da NPU
Além da CPU e da GPU, os sistemas modernos incorporam unidades de processamento neuronal (NPU). Estas unidades são projetadas especificamente para acelerar cargas de trabalho de inteligência artificial, complementando a GPU em tarefas de inferência e treinamento de modelos de aprendizado de máquina. Sua presença adiciona outra opção de processamento especializado, embora a escolha entre unidades ainda dependa da tarefa concreta.
A condição sine qua non: paralelismo
Para que uma GPU acelere um programa, a carga de trabalho deve ser intrinsecamente paralelizável. Se uma tarefa requer que cada passo dependa do resultado do anterior (dependência de dados), a GPU não pode executá-la de forma eficiente porque seus núcleos devem esperar que a sequência seja resolvida. Nesse caso, dispor de muitos núcleos não elimina a dependência que obriga a respeitar a ordem das operações.
As tarefas ideais para uma GPU são aquelas onde se pode aplicar a mesma operação a milhares de elementos de dados independentes, como o processamento de pixels em uma imagem ou a multiplicação de matrizes no aprendizado profundo. Nesses casos, a GPU pode distribuir o trabalho entre muitos threads e aproveitar sua largura de banda de memória e sua capacidade de cálculo. A vantagem aparece quando há trabalho independente suficiente para manter ocupadas essas unidades.
No entanto, muitas aplicações do mundo real têm uma mistura de código sequencial e paralelo. A parte sequencial deve ser executada na CPU, o que limita o benefício total da aceleração. Este fenômeno é conhecido como a lei de Amdahl, que estabelece que a melhoria total está limitada pela fração de tempo que o programa passa na parte não paralelizável. Portanto, acelerar uma seção do programa não implica que o tempo total se reduza na mesma proporção: o restante do trabalho continua impondo um limite.
O gargalo da transferência de dados
Um dos maiores obstáculos para a aceleração por GPU é a transferência de dados entre a memória do sistema (RAM) e a memória da GPU (VRAM). Esta comunicação é realizada através do barramento PCIe, que tem uma largura de banda limitada em comparação com a memória interna da GPU. Assim, antes de aproveitar o cálculo paralelo, pode ser necessário mover dados para o dispositivo e, depois, devolver resultados ao sistema.
Um estudo da Universidade de Michigan destaca que a capacidade de memória limitada e a comunicação CPU-GPU através de links PCIe são gargalos significativos para cargas de trabalho de análise de dados em larga escala. Se o tempo de transferência de dados exceder o tempo de cálculo, a GPU fica esperando, anulando sua vantagem de velocidade. Na prática, importa o tempo do processo completo, não apenas quanto tempo a GPU leva para executar as operações uma vez que tem os dados.
Técnicas de otimização
Para mitigar este problema, os desenvolvedores utilizam técnicas como a memória fixada (pinned memory), que permite transferências mais rápidas ao evitar a cópia intermediária do sistema operacional. Além disso, frameworks como CUDA e OpenCL oferecem primitivas de entrada/saída otimizadas para minimizar o impacto da transferência de dados no desempenho total. Estas ferramentas ajudam a reduzir o custo de mover informações, mas não fazem desaparecer as limitações do link entre a CPU e a GPU.
O ecossistema de software e as APIs
A disponibilidade de uma GPU poderosa é inútil se o software não for projetado para aproveitá-la. As APIs de programação como CUDA da NVIDIA e OpenCL do Khronos Group fornecem as ferramentas necessárias para escrever código que seja executado na GPU. O programa deve expressar o trabalho de uma maneira compatível com o dispositivo e organizar os dados e as operações para que a execução paralela seja viável.
O OpenCL 2.0, especificado pelo Khronos, introduziu melhorias significativas como a memória virtual compartilhada, que permite aos núcleos do host e do dispositivo compartilhar estruturas de dados complexas diretamente. Isso elimina transferências de dados custosas e simplifica a programação de algoritmos heterogêneos. Ao facilitar o acesso a estruturas compartilhadas, esta característica pode reduzir parte da complexidade que envolve coordenar CPU e GPU.
O suporte de software é um fator crítico. Nem todas as aplicações têm versões otimizadas para GPU. Em muitos casos, o desenvolvedor deve portar manualmente o código para a API da GPU, um processo que requer um profundo conhecimento da arquitetura e das limitações do hardware. Portanto, a presença de uma GPU no equipamento não garante que uma aplicação concreta a utilize nem que o código adaptado obtenha uma melhoria.
Evidência e medição do desempenho
Afirmar que uma GPU acelera um programa sem testes específicos é uma generalização perigosa. O desempenho depende da carga de trabalho concreta, do tamanho dos dados, da arquitetura da GPU e da eficiência do código. Também é necessário distinguir entre a velocidade de uma operação isolada e o tempo que o programa completo leva, porque este último inclui tarefas que talvez não sejam executadas na GPU.
Um estudo publicado em Cluster Computing avaliou o desempenho e o consumo de energia em arquiteturas híbridas CPU+GPU, concluindo que a eficiência energética depende em grande medida da carga de trabalho específica. O que funciona bem para uma aplicação científica pode não ser ótimo para outra. A comparação deve atender tanto ao desempenho quanto ao consumo, pois uma solução mais rápida não é necessariamente a mais eficiente em energia.
Como medir corretamente
Para avaliar o benefício de uma GPU, é necessário medir o tempo de execução total, incluindo a inicialização, a transferência de dados e a sincronização. Ferramentas de perfilamento como NVIDIA Nsight ou o OpenCL Profiler permitem identificar gargalos e otimizar o código. A medição integral evita atribuir à GPU uma melhoria que poderia ser contrariada pelo tempo dedicado a preparar ou mover os dados.
É crucial comparar o desempenho em condições controladas, utilizando os mesmos dados e a mesma configuração de hardware. Diferenças no sistema operacional, nos drivers ou na versão da API podem influenciar significativamente os resultados. Manter constantes essas condições permite interpretar melhor as medições e avaliar se a diferença observada se deve à implementação examinada.
Conclusões práticas para o usuário
A decisão de utilizar uma GPU para acelerar uma tarefa não é binária. Depende de uma avaliação cuidadosa da paralelizabilidade da carga, do custo da transferência de dados e da disponibilidade de software otimizado. Também convém observar que parte do programa se beneficia realmente, porque uma seção acelerada pode coexistir com outras que continuam sendo executadas de forma sequencial.
Para o usuário final, a recomendação é não assumir que uma GPU poderosa melhorará o desempenho de todas as aplicações. Em vez disso, é melhor procurar aplicações que estejam explicitamente otimizadas para GPU, como editores de vídeo, jogos ou ferramentas de inteligência artificial. O desempenho dependerá igualmente da carga concreta e de como o programa aproveite o hardware, então o rótulo de compatibilidade não substitui a avaliação do uso real.
Em resumo, a GPU é uma ferramenta poderosa, mas não uma varinha mágica. Sua eficácia depende do alinhamento entre a arquitetura do hardware, a natureza da carga de trabalho e a qualidade do software de programação. Entender estes limites permite tomar decisões informadas sobre o uso da computação heterogênea e evitar confundir potência teórica com uma melhoria garantida em qualquer programa.