GPU et carte graphique ne sont pas identiques
Dans l’usage quotidien, GPU et carte graphique désignent souvent la même chose, mais elles décrivent des choses différentes. La carte graphique est le composant physique ; le GPU est le processeur qui exécute les instructions de calcul dans le système. Dans certains appareils, le GPU est intégré et ne forme pas une carte indépendante, donc avoir un GPU n’équivaut pas forcément à posséder une carte dédiée.
La différence importe parce que le calcul général se fait sur le CPU et dans le logiciel qui l’utilise, non simplement en installant une carte. Un GPU peut participer à des tâches au-delà du rendu, mais le programme doit lui attribuer un travail compatible et gérer l’interaction avec le CPU. Ainsi, une carte plus puissante ne transforme pas automatiquement une application qui continue de s’exécuter sur le CPU.
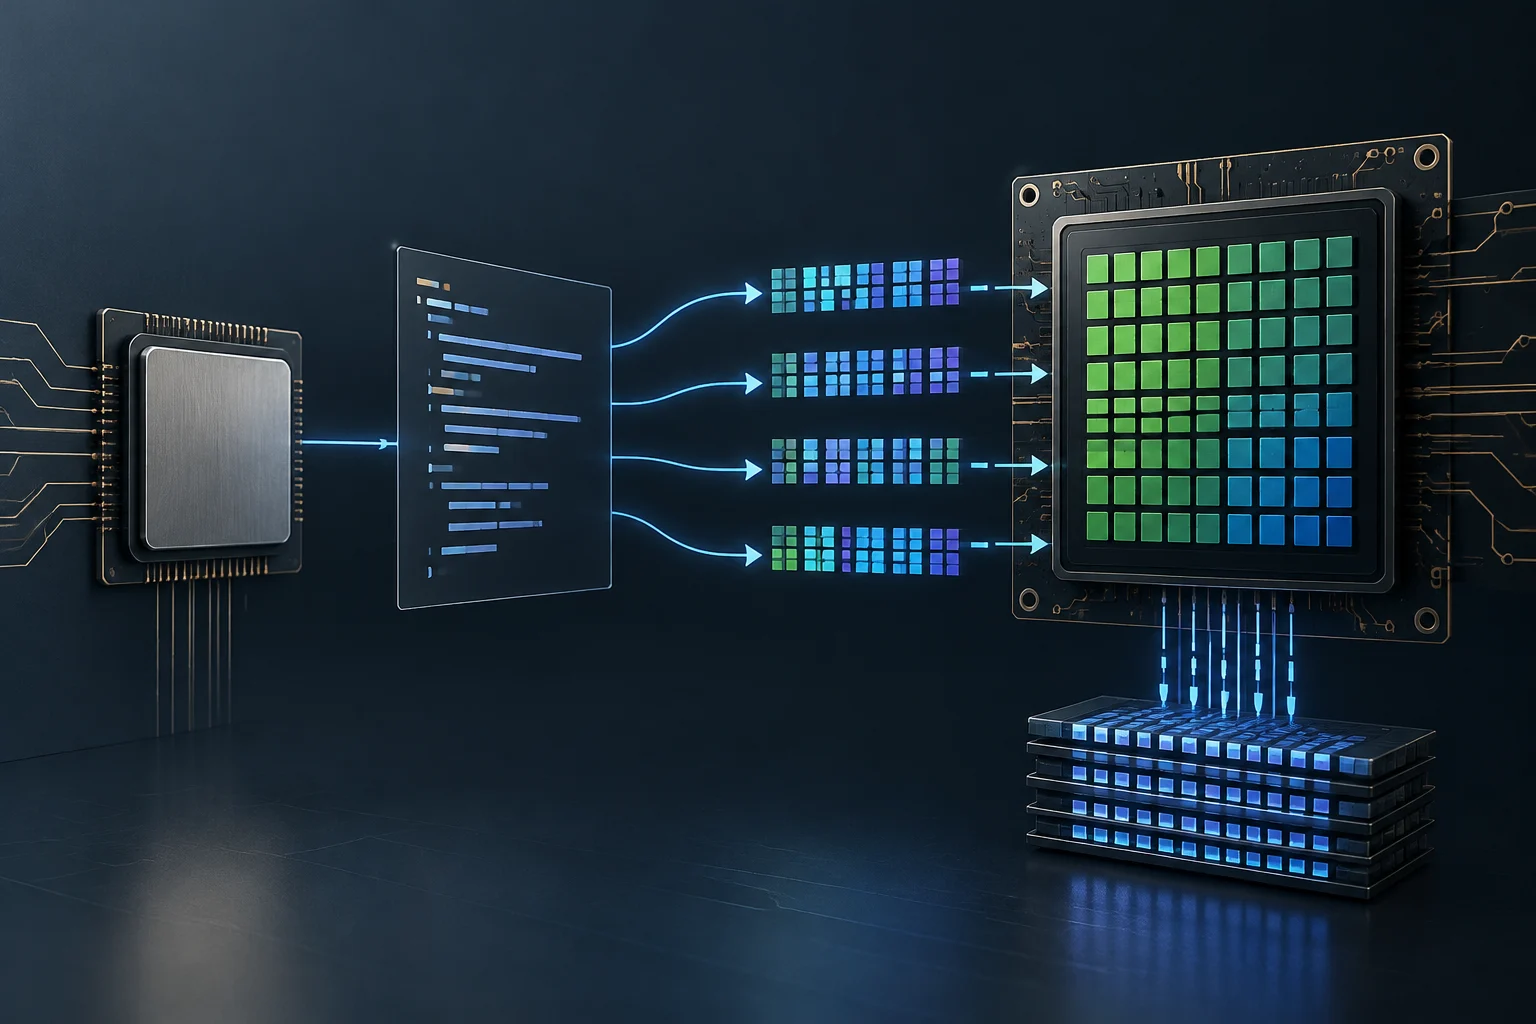
La question utile n’est pas seulement combien de ressources possède le GPU, mais si le programme peut diviser son charge de travail, envoyer cette partie au GPU et récupérer le résultat à un coût raisonnable. Ce parcours inclut les décisions de conception du programme et de l’environnement d’exécution. L’accélération est une propriété de la combinaison entre charge, matériel et logiciel, pas une fonction universelle qui s’active pour tout dans le système.
Le parallélisme favorise certains types de travail
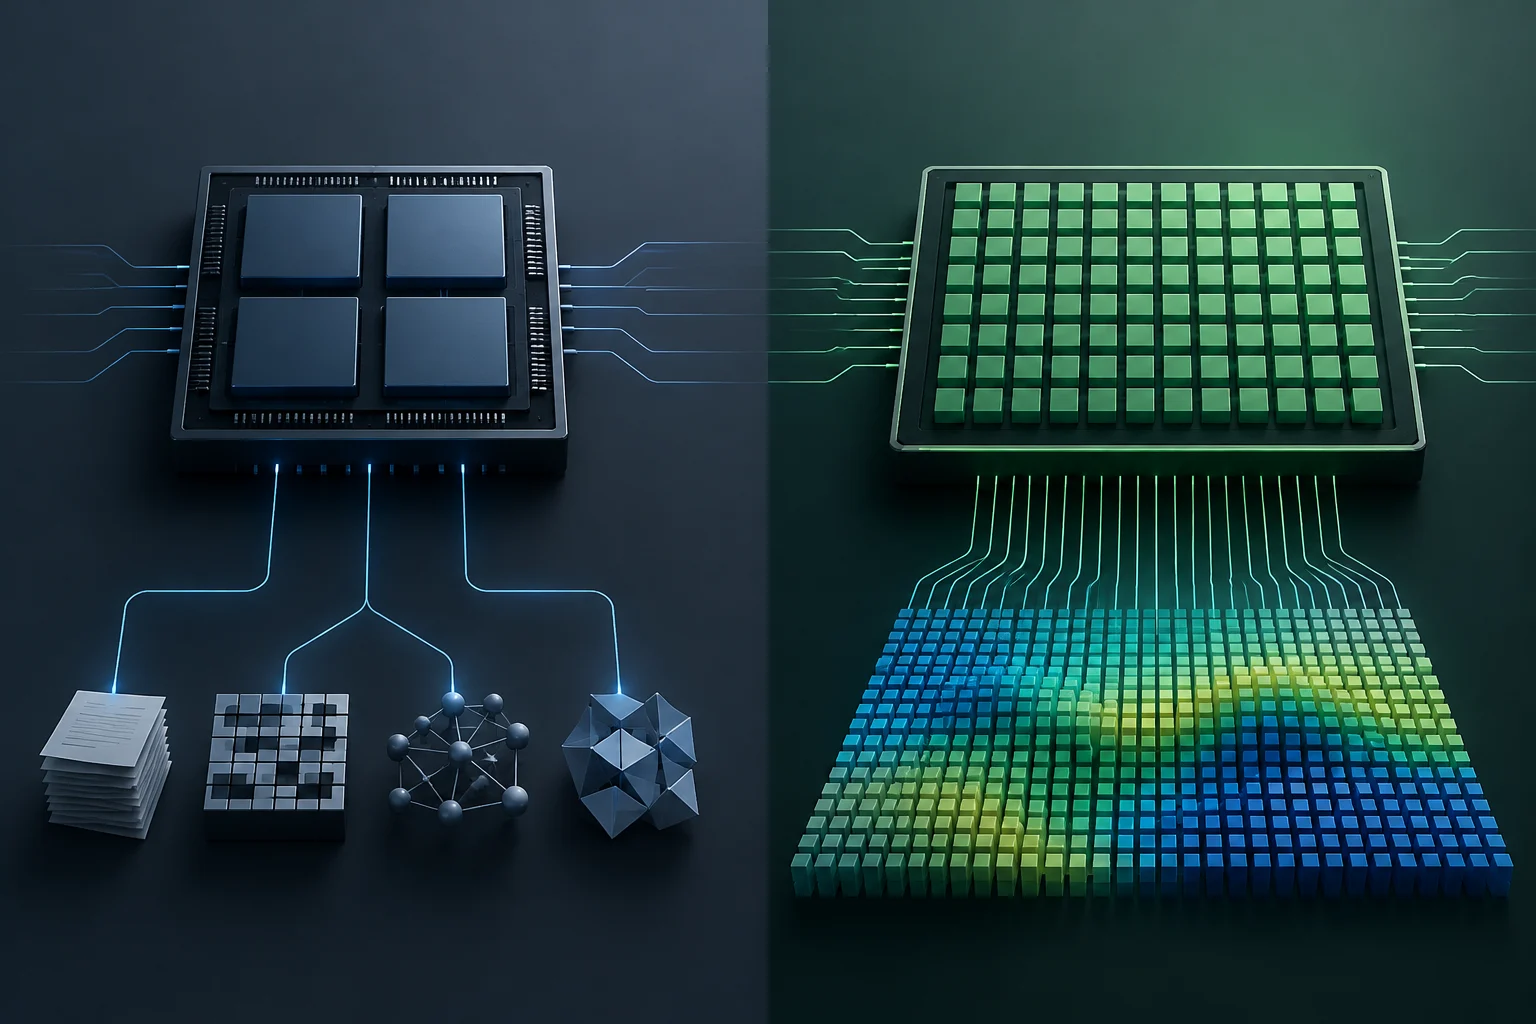
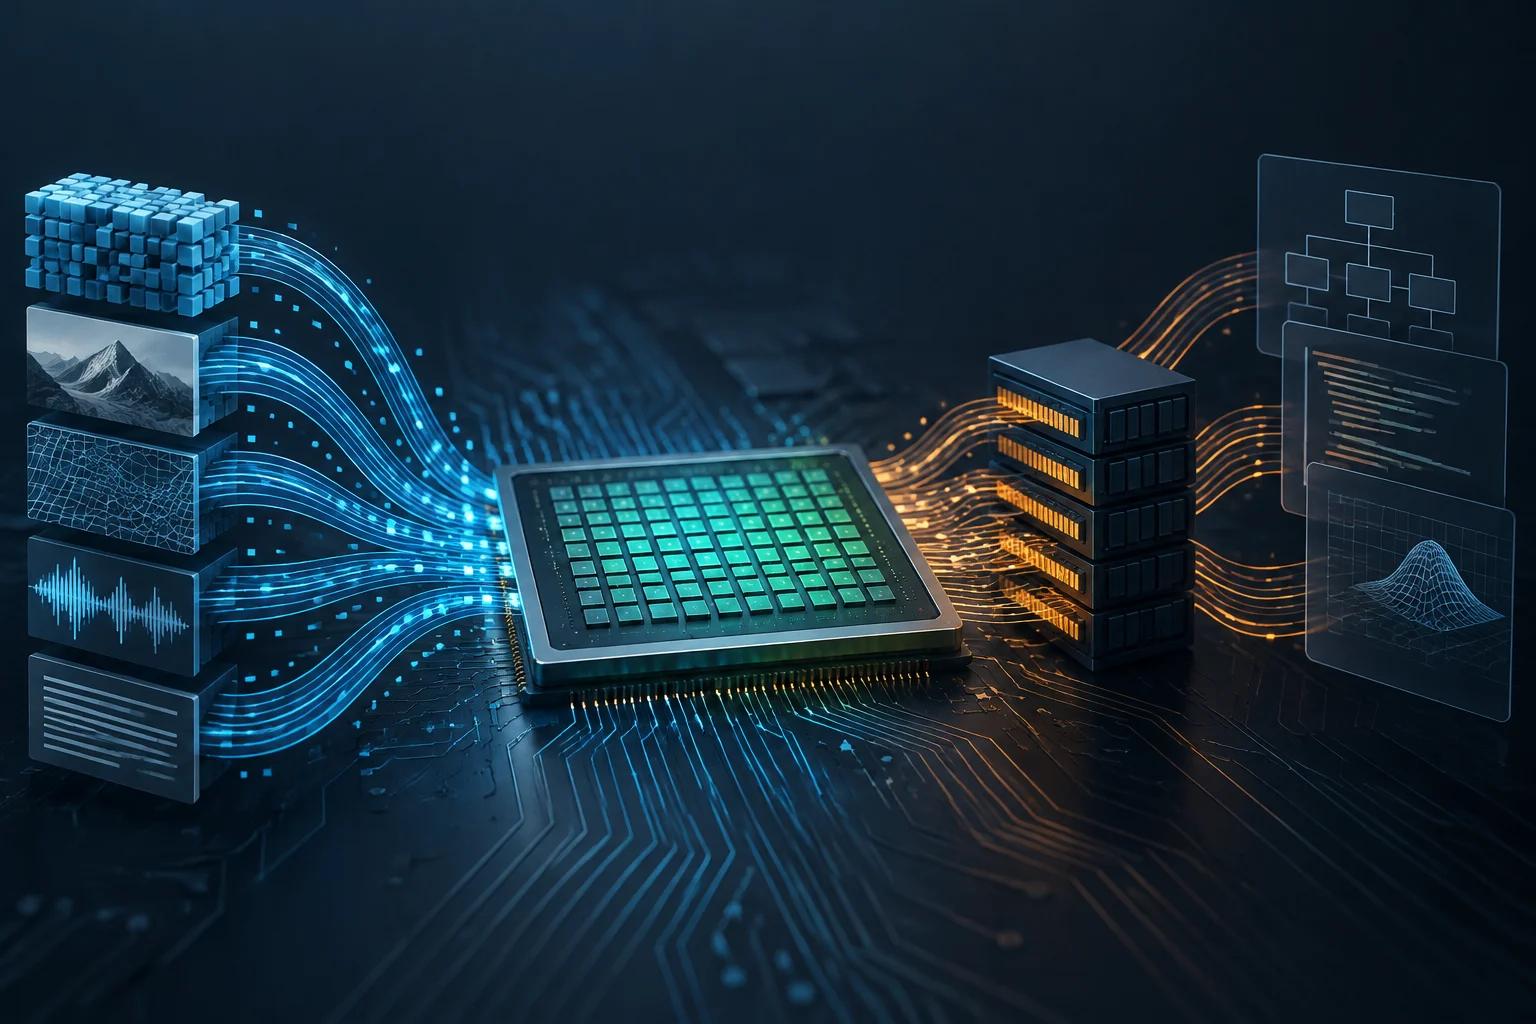
Un GPU excelle lorsqu’il peut répéter de nombreuses opérations similaires sur différents éléments de données. Ce motif, appelé parallélisme des données, apparaît, par exemple, lorsqu’on applique une opération à de nombreux pixels ou à des éléments d’une matrice. La documentation AMD décrit HIP comme un modèle qui permet de mapper les algorithmes parallèles de données sur des architectures GPU ; elle indique également que ces unités recherchent une haute performance globale, pas nécessairement la fin d’une instruction individuelle avec la plus faible latence.
Le CPU, en revanche, est orienté vers la réponse rapide aux instructions individuelles et l’exécution de séquences de contrôle. La différence ne signifie pas qu’un CPU ne peut pas traiter des données en parallèle ni qu’un GPU ne peut pas exécuter toute logique conditionnelle : cela signifie que chaque conception a des priorités différentes. L’avantage apparaît lorsqu’il y a suffisamment de travail indépendant pour maintenir occupées de nombreuses unités de calcul du GPU.
Si chaque étape dépend du résultat précédent, ou si le programme possède beaucoup de flux de contrôle irréguliers, il y aura moins d’opérations disponibles pour l’exécution simultanée. Le résultat peut être une accélération modeste ou aucune, même avec un GPU puissant. La documentation AMD avertit également que déplacer du code conçu pour le CPU vers un GPU sans l’adapter ne profite pas efficacement de ses ressources. Porter une application nécessite la refonte ou la cartographie du travail, pas seulement changer où elle est compilée.
La mémoire et les transferts consomment aussi du temps
Un GPU gère généralement une mémoire de périphérique distincte de la mémoire système utilisée par le CPU. Les données dont le GPU a besoin doivent être disponibles dans son espace mémoire, et selon la conception du programme et la plate-forme, il peut être nécessaire de les transférer entre les deux. AMD identifie l’allocation et le déplacement des données entre la mémoire hôte et la mémoire périphérique comme des tâches pouvant être critiques pour les performances.
Par conséquent, le temps total n’est pas seulement celui du calcul sur le GPU. La préparation, les copies et la synchronisation des résultats comptent également. Pour une tâche courte ou avec de petites données, ces étapes peuvent représenter une part importante du temps total et réduire le gain promis par le calcul parallèle. On ne peut pas affirmer que le transfert annule toujours l’accélération : son effet dépend de la taille des données, de la fréquence des échanges et de l’implémentation concrète.
Les plates-formes offrent des mécanismes pour mieux organiser ce mouvement. Le guide HIP mentionne les appels asynchrones, les streams et la possibilité de superposer les transferts avec le calcul lorsque les ressources le permettent. Le guide CUDA documente également les copies asynchrones dans la hiérarchie mémoire du GPU. Superposer le travail peut réduire les attentes, mais ne supprime pas la nécessité de transférer, coordonner et vérifier que les données sont disponibles à temps.
Sans support explicite, le programme ne délègue pas le travail
Un GPU ne détecte pas automatiquement quelles parties d’une application seraient plus rapides et les exécute en arrière-plan. Le logiciel doit inclure un chemin d’exécution pour ce processeur : il peut le faire via une API, une bibliothèque ou un cadre fournissant l’accès au GPU. CUDA est la plateforme et le modèle de programmation parallèle de NVIDIA ; HIP offre le modèle de programmation AMD pour attribuer des algorithmes parallèles aux GPU.
La compatibilité concrète compte. Que le programme annonce une accélération GPU ne prouve pas qu’il fonctionne avec n’importe quelle carte, système d’exploitation ou version du pilote : il faut vérifier quels appareils et fournisseurs d’exécution l’application prend en charge. La compatibilité est vérifiée par application et configuration, pas déduite du fait que le système reconnaît la carte pour l’affichage.
Windows ML illustre comment une couche logicielle peut offrir différentes options d’exécution : Microsoft décrit cela comme un cadre local d’inférence IA qui peut utiliser CPU, GPU ou NPU via des providers d’exécution optionnels gérés par Windows. La documentation elle‑même avertit que les résultats de performance varient selon le matériel et le modèle. C’est un exemple limité à l’inférence IA sur Windows, pas une fonction qui accélère automatiquement n’importe quel programme de bureau.
Un résultat publié n’est pas une promesse générale
Une étude de traitement sismique offre un exemple concret de ce qu’un GPU peut accomplir lorsque l’algorithme et la charge conviennent. Les auteurs ont comparé des algorithmes de décomposition de données sismiques par paquets d’ondes et ont signalé une accélération entre deux et six fois par rapport à un CPU de 20 cœurs, dans les tests effectués avec des ensembles de données synthétiques. Cette donnée décrit une expérience spécifique, pas un chiffre applicable à toute tâche ou tout GPU.
La documentation du fabricant aide à comprendre pourquoi les résultats varient : le modèle d’exécution, le parallélisme disponible et la gestion de la mémoire font partie des performances. Mais un guide de programmation ne remplace pas tester l’application concrète, et l’étude sismique ne compare pas tous les types de travail ni toutes les configurations possibles. Il n’y a aucune raison d’extrapoler son multiplicateur aux éditions, jeux, compression ou applications bureautiques.
Lorsqu’on lit une valeur d’accélération, il est utile de vérifier ce qui a été comparé, avec quel programme et quelles données, quel processeur était utilisé comme référence et si le temps inclut les transferts et la préparation. Il importe également s’il a mesuré une opération isolée ou l’ensemble du flux que l’utilisateur utilise. Sans ces détails, un chiffre peut être techniquement vrai pour son cas original mais peu utile pour décider ce qui se passera sur une autre machine.
Comment vérifier si une application exploite le GPU
Pour savoir si une application particulière peut bénéficier, commencez par sa documentation et ses paramètres. Recherchez le nom de la fonction accélérée et les appareils ou cadres compatibles. Si le fabricant ne mentionne l’accélération que dans une fonction spécifique, n’assumez pas que tout le programme s’exécute sur le GPU. La compatibilité déclarée est le premier filtre, pas une mesure d’amélioration.
Ensuite, définissez un test qui représente votre utilisation réelle. Comparez le même travail avec l’option d’accélération activée et désactivée, en gardant les mêmes données, la qualité de sortie et les autres conditions pertinentes. Enregistrez le temps total et répétez le test : voir une activité GPU indique simplement qu’il y a eu du travail sur l’accélérateur, pas combien de temps a été réduit ou si la réponse est plus fluide.
Une vérification pratique peut suivre ces étapes :
- Identifiez la fonction accélérée et confirmez quel modèle de GPU, système et pilote il nécessite.
- Examinez le type de charge : cherchez des opérations répétitives sur beaucoup de données et considérez si le travail a des dépendances séquentielles importantes.
- Considérez les transferts : découvrez si l’application conserve les données en mémoire GPU ou les déplace souvent entre CPU et GPU.
- Mesurez le flux complet : comparez le temps du début à la fin, pas seulement l’utilisation du GPU ni le temps d’un calcul isolé.
- Décidez selon l’amélioration observée : une réduction reproductible du temps ou une réponse plus fluide vaut mieux qu’un pourcentage d’activité de l’accélérateur.
La conclusion pratique est simple : ne pas acheter ou configurer un GPU pour une application sans vérifier son support et ses résultats sur votre charge de travail. Le parallélisme ouvre une possibilité d’accélération ; le logiciel, la mémoire et la structure de la tâche déterminent si elle devient une amélioration perceptible.