GPU y tarjeta gráfica no son lo mismo
En el uso cotidiano, GPU y tarjeta gráfica suelen nombrar lo mismo, pero describen cosas distintas. La tarjeta gráfica es el componente físico; la GPU es el procesador que ejecuta instrucciones de cómputo dentro del sistema. En algunos equipos la GPU está integrada y no forma una tarjeta independiente, de modo que la presencia de una GPU no equivale necesariamente a tener una tarjeta dedicada.
La diferencia importa porque el cómputo general ocurre en el procesador y en el software que lo utiliza, no por el mero hecho de instalar una placa. Una GPU puede participar en tareas distintas del renderizado, pero el programa debe asignarle trabajo compatible y gestionar la interacción con la CPU. Por eso, una tarjeta más potente no transforma automáticamente una aplicación que sigue ejecutándose en la CPU.
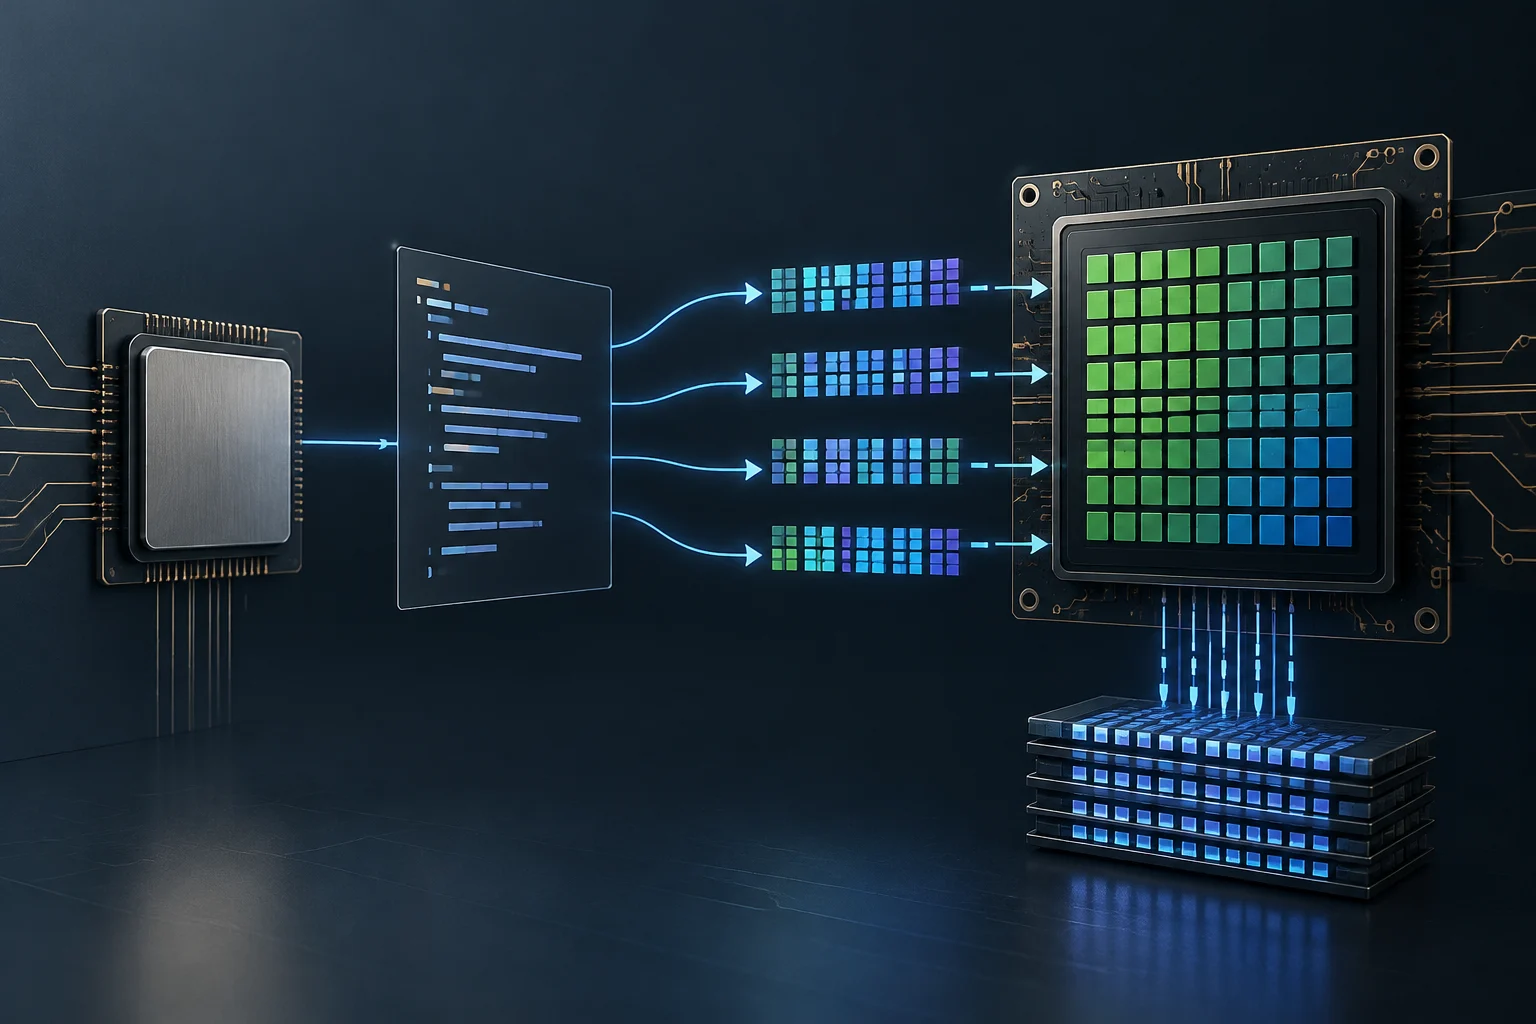
La pregunta útil no es solo cuántos recursos tiene la GPU, sino si el programa puede dividir su trabajo, enviar esa parte a la GPU y recuperar el resultado con un coste razonable. Ese recorrido incluye decisiones de diseño del programa y del entorno de ejecución. La aceleración es una propiedad de la combinación entre carga, hardware y software, no una función universal que se active para todo el sistema.
El paralelismo favorece ciertos tipos de trabajo
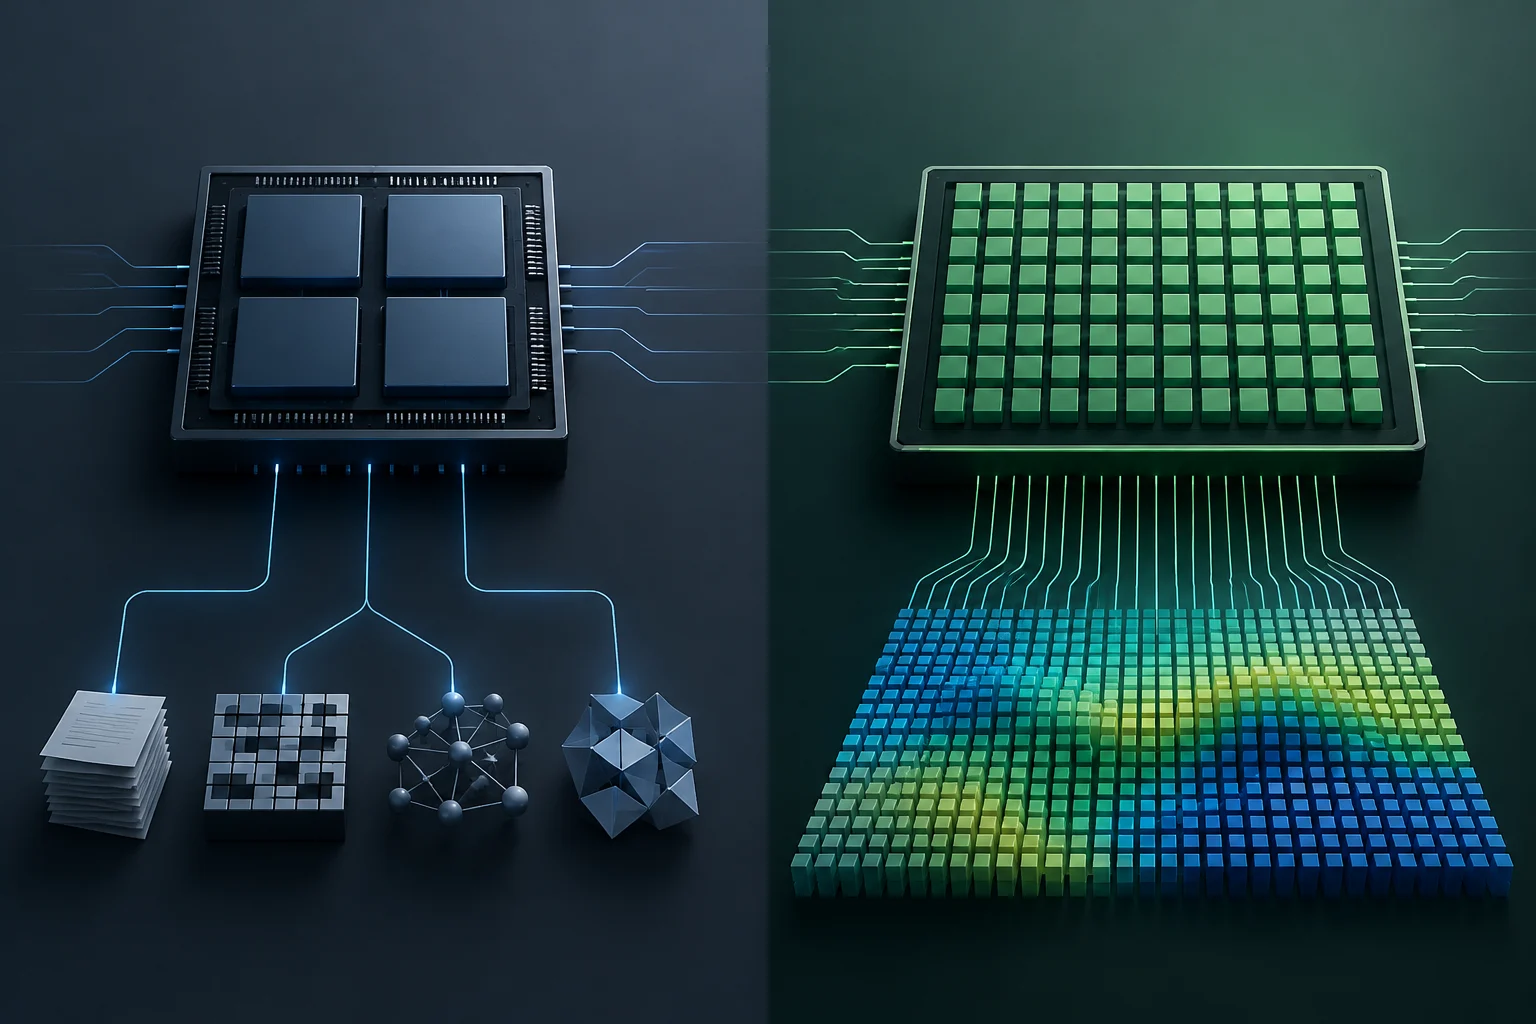
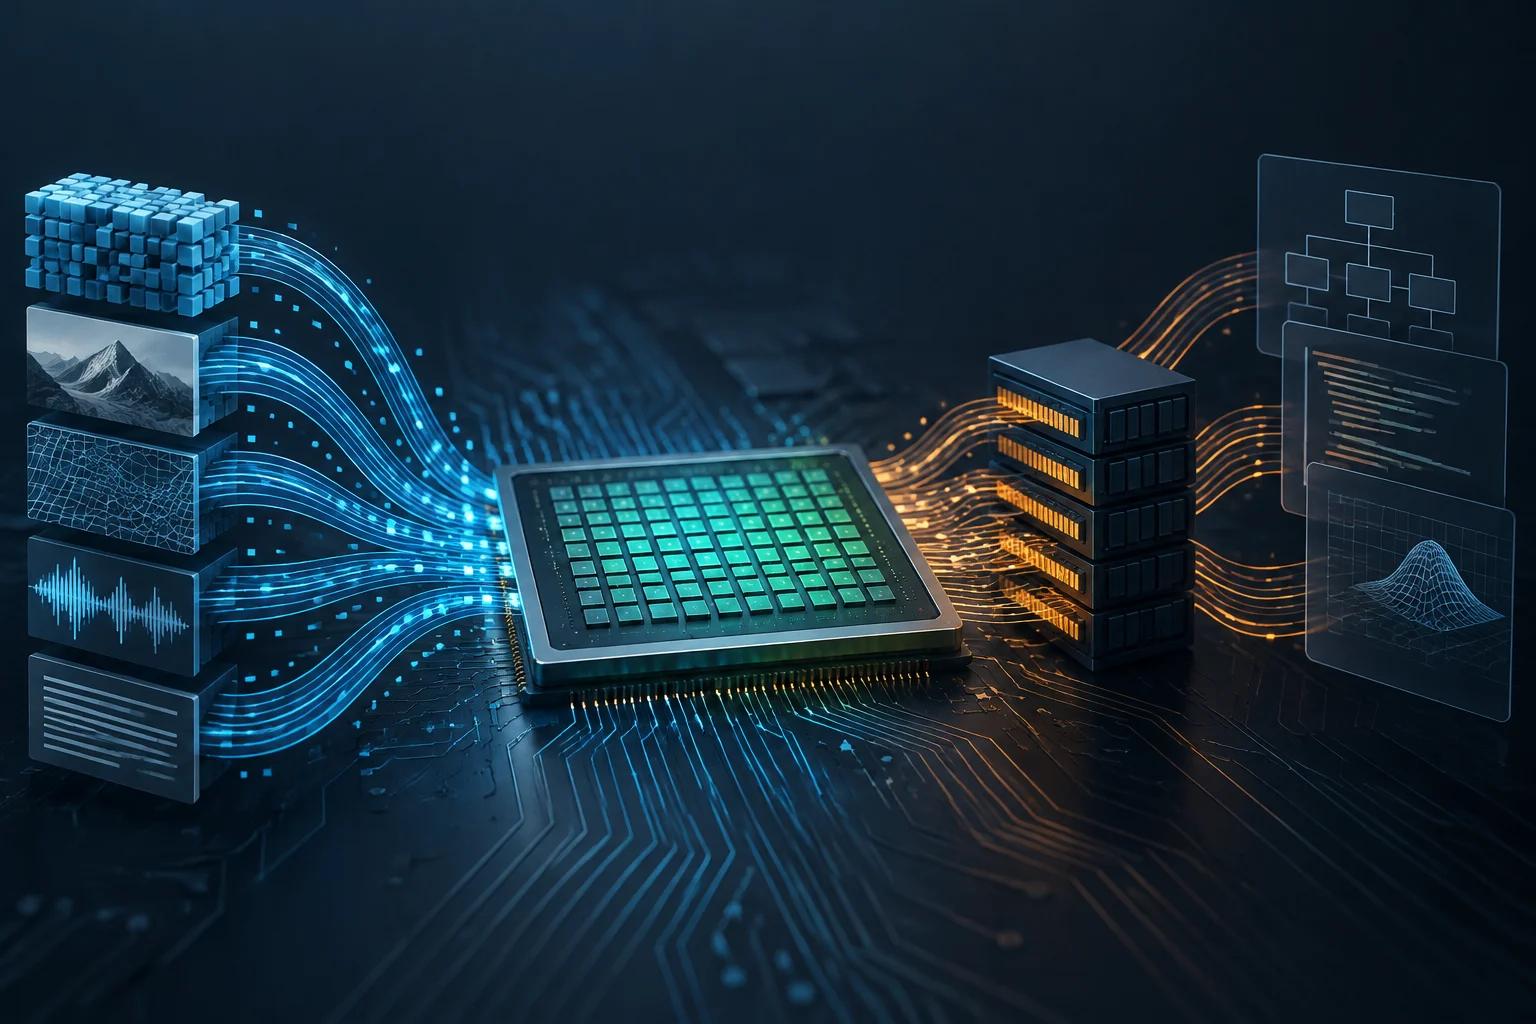
La GPU destaca cuando puede repetir muchas operaciones parecidas sobre distintos elementos de datos. Este patrón, llamado paralelismo de datos, aparece, por ejemplo, al aplicar una operación a muchos píxeles o a elementos de una matriz. La documentación de AMD describe HIP como un modelo que permite mapear algoritmos paralelos de datos a arquitecturas de GPU; también señala que estas unidades buscan un alto rendimiento agregado, no necesariamente terminar una instrucción individual con la menor latencia.
La CPU, en cambio, está orientada a responder con rapidez a instrucciones individuales y a ejecutar secuencias de control. La diferencia no significa que una CPU no pueda procesar datos en paralelo ni que una GPU sea incapaz de ejecutar toda lógica condicional: significa que cada diseño tiene prioridades distintas. La ventaja aparece cuando hay suficiente trabajo independiente para mantener ocupadas muchas unidades de cómputo de la GPU.
Si cada paso depende del resultado anterior, o si el programa tiene mucho control de flujo irregular, habrá menos operaciones disponibles para ejecutar simultáneamente. El resultado puede ser una aceleración modesta o ninguna, incluso si el equipo cuenta con una GPU potente. La documentación de AMD advierte además que trasladar código pensado para CPU a una GPU sin adaptarlo no aprovecha eficientemente sus recursos. Portar una aplicación exige rediseñar o mapear el trabajo, no solo cambiar dónde se compila.
La memoria y las transferencias también consumen tiempo
Una GPU suele gestionar memoria de dispositivo separada de la memoria del sistema que utiliza la CPU. Los datos que necesita la GPU deben estar disponibles en su espacio de memoria y, según el diseño del programa y la plataforma, puede ser necesario transferirlos entre ambos. AMD identifica la asignación y el movimiento de datos entre memoria del host y memoria del dispositivo como tareas que pueden ser críticas para el rendimiento.
Por eso, el tiempo total no es únicamente el que tarda el cálculo en la GPU. También cuentan la preparación, las copias y la sincronización de resultados. Para una tarea breve o con datos pequeños, esos pasos pueden representar una parte importante del tiempo total y reducir la ganancia que prometía el cálculo paralelo. No se puede afirmar que la transferencia siempre anule la aceleración: su efecto depende del tamaño de los datos, de la frecuencia de los intercambios y de la implementación concreta.
Las plataformas ofrecen mecanismos para organizar mejor ese movimiento. La guía de HIP menciona llamadas asíncronas, streams y la posibilidad de solapar transferencias con cómputo cuando los recursos lo permiten. La guía de CUDA también documenta copias asíncronas dentro de la jerarquía de memoria de la GPU. Solapar trabajo puede reducir esperas, pero no elimina la necesidad de transferir, coordinar y comprobar que los datos estén disponibles a tiempo.
Sin soporte explícito, el programa no delega el trabajo
Una GPU no detecta por sí sola qué partes de una aplicación serían más rápidas y las ejecuta en segundo plano. El software tiene que incluir una ruta de ejecución para ese procesador: puede hacerlo mediante una API, una biblioteca o un marco de trabajo que proporcione acceso a la GPU. CUDA es la plataforma y el modelo de programación paralela de NVIDIA; HIP ofrece un modelo de programación de AMD para asignar algoritmos paralelos a GPU.
La compatibilidad concreta es importante. Que un programa anuncie aceleración por GPU no demuestra que funcione con cualquier tarjeta, sistema operativo o versión de controlador: hay que revisar qué dispositivos y proveedores de ejecución admite esa aplicación. La compatibilidad se comprueba por aplicación y por configuración, no se deduce de que el sistema reconozca la tarjeta para mostrar imagen.
Windows ML ilustra cómo una capa de software puede ofrecer distintas opciones de ejecución: Microsoft lo describe como un marco local de inferencia de IA que puede usar CPU, GPU o NPU a través de execution providers opcionales gestionados por Windows. La propia documentación advierte que los resultados de rendimiento varían según el hardware y el modelo. Es un ejemplo acotado a inferencia de IA en Windows, no una función que acelere automáticamente cualquier programa de escritorio.
Un resultado publicado no es una promesa general
Un estudio de procesamiento sísmico ofrece un ejemplo concreto de lo que puede lograr una GPU cuando el algoritmo y la carga encajan. Los autores compararon algoritmos de descomposición de datos sísmicos mediante paquetes de onda y comunicaron una aceleración de entre dos y seis veces frente a CPU de 20 núcleos, en las pruebas realizadas con conjuntos de datos sintéticos. Ese dato describe un experimento específico, no una cifra aplicable a cualquier tarea ni a cualquier GPU.
La documentación de fabricantes ayuda a entender por qué los resultados varían: el modelo de ejecución, el paralelismo disponible y la gestión de memoria forman parte del rendimiento. Pero una guía de programación no sustituye una prueba de la aplicación concreta, y el estudio sísmico no compara todos los tipos de trabajo ni todas las configuraciones posibles. No hay una razón para extrapolar su multiplicador a edición, juegos, compresión o aplicaciones de oficina.
Al leer una cifra de aceleración conviene comprobar qué se comparó, con qué programa y datos, qué procesador se usó como referencia y si el tiempo incluye transferencias y preparación. También importa si se midió una operación aislada o el flujo completo que utiliza una persona. Sin esos detalles, una cifra puede ser técnicamente cierta para su caso original y, aun así, poco útil para decidir qué ocurrirá en otro equipo.
Cómo comprobar si una aplicación aprovecha la GPU
Para saber si una aplicación concreta puede beneficiarse, empieza por la documentación y los ajustes del propio programa. Busca el nombre de la función acelerada y los dispositivos o marcos compatibles. Si el fabricante solo menciona aceleración en una función particular, no des por hecho que todo el programa se ejecuta en la GPU. La compatibilidad declarada es el primer filtro, no una medida de mejora.
Después, define una prueba que represente tu uso real. Compara el mismo trabajo con la opción de aceleración activada y desactivada, manteniendo iguales los datos, la calidad de salida y el resto de condiciones relevantes. Registra el tiempo total y repite la prueba: observar actividad de GPU solo indica que hubo trabajo en el acelerador, no cuánto se redujo el tiempo ni si la respuesta resulta más fluida.
Una comprobación práctica puede seguir estos pasos:
- Identifica la función acelerada y confirma qué modelo de GPU, sistema y controlador requiere.
- Revisa el tipo de carga: busca operaciones repetitivas sobre muchos datos y considera si el trabajo tiene dependencias secuenciales importantes.
- Considera las transferencias: averigua si la aplicación mantiene los datos en memoria de GPU o los mueve a menudo entre CPU y GPU.
- Mide el flujo completo: compara el tiempo de principio a fin, no solo el uso de GPU ni el tiempo de un cálculo aislado.
- Decide según la mejora observada: una reducción reproducible del tiempo o una respuesta más útil vale más que el porcentaje de actividad del acelerador.
La conclusión práctica es sencilla: no compres ni configures una GPU para una aplicación sin comprobar su soporte y el resultado en tu carga de trabajo. El paralelismo abre una posibilidad de aceleración; el software, la memoria y la estructura de la tarea determinan si se convierte en una mejora perceptible.