GPU e scheda grafica non sono la stessa cosa
Nell'uso quotidiano, GPU e scheda grafica vengono spesso usati come sinonimi, ma descrivono cose diverse. La scheda grafica è il componente fisico; la GPU è il processore che esegue le istruzioni di calcolo all'interno del sistema. In alcuni dispositivi la GPU è integrata e non forma una scheda indipendente, quindi avere una GPU non equivale necessariamente a possedere una scheda dedicata.
La differenza importa perché il calcolo generale avviene sul CPU e nel software che lo utilizza, non semplicemente installando una scheda. Una GPU può partecipare a compiti oltre il rendering, ma il programma deve assegnarle lavoro compatibile e gestire l'interazione con la CPU. Pertanto, una scheda più potente non trasforma automaticamente un'applicazione che continua ad eseguire sul CPU.
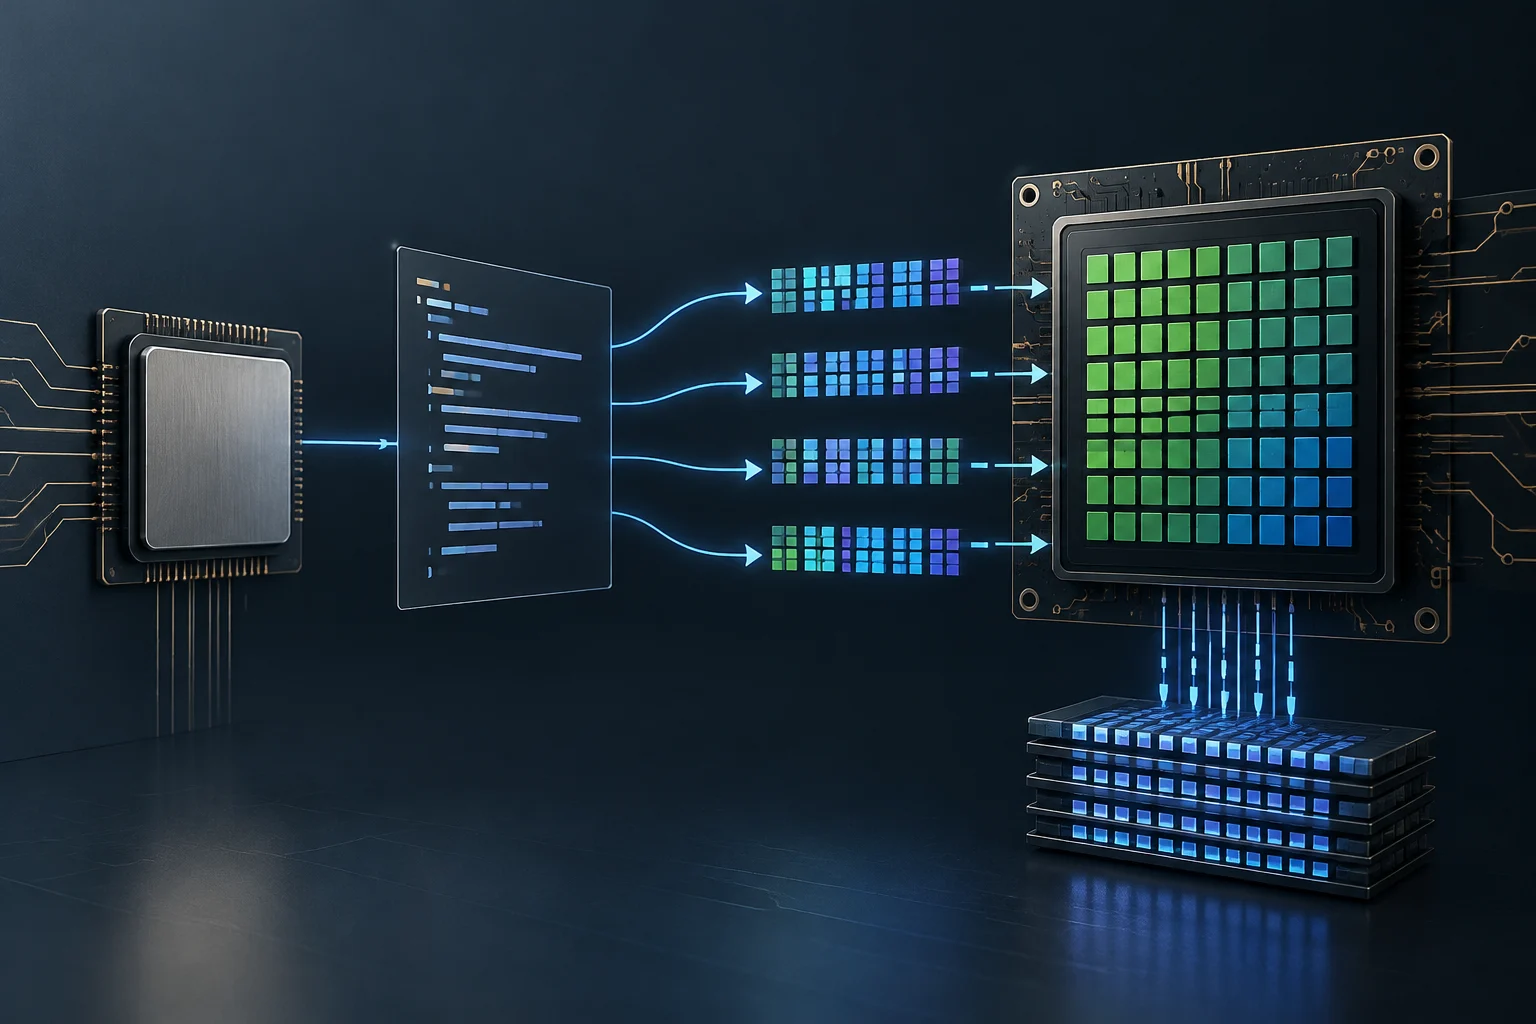
La domanda utile non è solo quante risorse ha la GPU, ma se il programma può dividere il suo carico di lavoro, inviare quella parte alla GPU e recuperare il risultato a un costo ragionevole. Questo percorso include decisioni di progettazione del programma e dell'ambiente di esecuzione. L'accelerazione è una proprietà della combinazione tra carico, hardware e software, non una funzione universale che si attiva per tutto il sistema.
Il parallelismo favorisce certi tipi di lavoro
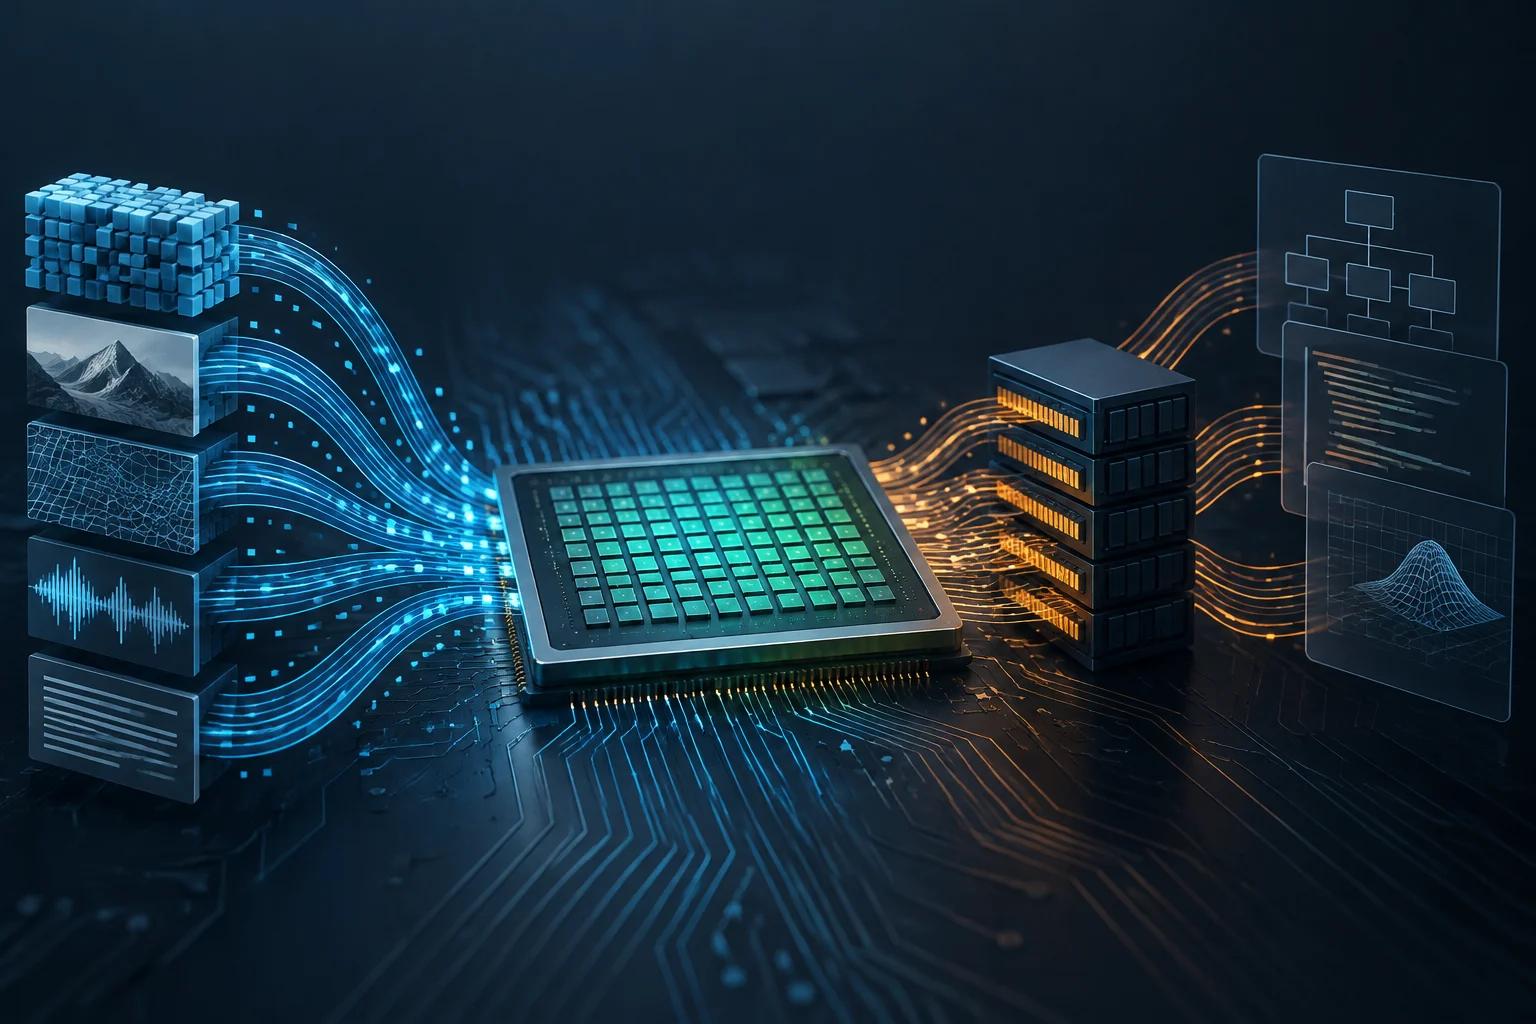
La GPU eccelle quando può ripetere molte operazioni simili su diversi elementi di dati. Questo schema, chiamato parallelismo dei dati, appare, ad esempio, quando si applica un'operazione a molti pixel o a elementi di una matrice. La documentazione AMD descrive HIP come modello che consente di mappare algoritmi paralleli sui GPU; indica anche che queste unità cercano alte prestazioni aggregate, non necessariamente terminare un singolo istruzione con la latenza più bassa.
Il CPU, al contrario, è orientato a rispondere rapidamente alle istruzioni individuali e ad eseguire sequenze di controllo. La differenza non significa che un CPU non possa elaborare dati in parallelo né che una GPU non possa eseguire tutta la logica condizionale: significa che ogni design ha priorità diverse. Il vantaggio appare quando c'è abbastanza lavoro indipendente per mantenere occupate molte unità di calcolo della GPU.
Se ogni passo dipende dal risultato precedente, o se il programma ha molto controllo di flusso irregolare, ci saranno meno operazioni disponibili per l'esecuzione simultanea. Il risultato può essere un'accelerazione modesta o nessuna, anche con una GPU potente. La documentazione AMD avverte inoltre che spostare codice pensato per CPU su GPU senza adattarlo non sfrutta efficacemente le sue risorse. Portare un'applicazione richiede ridisegnare o mappare il lavoro, non solo cambiare dove viene compilata.
La memoria e i trasferimenti consumano anche tempo
Una GPU gestisce tipicamente la memoria del dispositivo separata dalla memoria di sistema usata dal CPU. I dati necessari alla GPU devono essere disponibili nello spazio di memoria, e a seconda della progettazione del programma e della piattaforma, può essere necessario trasferirli tra i due. AMD identifica l'allocazione e il movimento dei dati tra memoria host e device come attività che possono essere critiche per le prestazioni.
Pertanto, il tempo totale non è solo quello impiegato dal calcolo sulla GPU. Preparazione, copie e sincronizzazione dei risultati contano anche. Per un compito breve o con piccoli dati, questi passaggi possono rappresentare una parte significativa del tempo totale e ridurre il guadagno promesso dal calcolo parallelo. Non si può affermare che la trasferimento annulli sempre l'accelerazione: il suo effetto dipende dalla dimensione dei dati, dalla frequenza degli scambi e dall'implementazione concreta.
Le piattaforme offrono meccanismi per organizzare meglio questo movimento. La guida HIP menziona chiamate asincrone, streams e la possibilità di sovrapporre trasferimenti con calcolo quando le risorse lo permettono. La guida CUDA documenta anche copie asincrone nella gerarchia della memoria GPU. Sovrapponendo il lavoro si possono ridurre le attese, ma non elimina la necessità di trasferire, coordinare e verificare che i dati siano disponibili in tempo.
Senza supporto esplicito, il programma non delega il lavoro
Una GPU non rileva da sola quali parti di un'applicazione sarebbero più veloci e le esegue in background. Il software deve includere un percorso di esecuzione per quel processore: può farlo tramite API, libreria o framework che fornisce accesso alla GPU. CUDA è la piattaforma e il modello di programmazione parallela di NVIDIA; HIP offre un modello di programmazione AMD per assegnare algoritmi paralleli ai GPU.
La compatibilità concreta è importante. Che un programma annunci accelerazione GPU non dimostra che funzioni con qualsiasi scheda, sistema operativo o versione del driver: bisogna verificare quali dispositivi e provider di esecuzione supporta quell'applicazione. La compatibilità si verifica per applicazione e configurazione, non si deduce dal fatto che il sistema riconosca la scheda per mostrare l'immagine.
Windows ML illustra come un livello software può offrire diverse opzioni di esecuzione: Microsoft lo descrive come un framework locale di inferenza IA che può usare CPU, GPU o NPU tramite execution providers opzionali gestiti da Windows. La documentazione stessa avverte che i risultati delle prestazioni variano con l'hardware e il modello. È un esempio limitato all'inferenza IA su Windows, non una funzione che accelera automaticamente qualsiasi programma desktop.
Un risultato pubblicato non è una promessa generale
Uno studio di elaborazione sismica offre un esempio concreto di ciò che una GPU può realizzare quando algoritmo e carico si adattano. Gli autori hanno confrontato algoritmi di decomposizione dei dati sismici con pacchetti d'onda e riportato accelerazioni tra due e sei volte rispetto a CPU da 20 core, nei test eseguiti con set di dati sintetici. Questa cifra descrive un esperimento specifico, non un numero applicabile a qualsiasi compito o GPU.
La documentazione del produttore aiuta a capire perché i risultati variano: modello di esecuzione, parallelismo disponibile e gestione della memoria fanno parte delle prestazioni. Ma una guida di programmazione non sostituisce il test dell'applicazione concreta, e lo studio sismico non confronta tutti i tipi di lavoro o tutte le configurazioni possibili. Non c'è motivo di extrapolare il suo moltiplicatore a editing, giochi, compressione o applicazioni d'ufficio.
Quando si legge una cifra di accelerazione conviene verificare cosa è stato confrontato, con quale programma e dati, che processore è stato usato come riferimento e se il tempo include trasferimenti e preparazione. È anche importante se è stata misurata un'operazione isolata o l'intero flusso che utilizza una persona. Senza quei dettagli, una cifra può essere tecnicamente corretta per il suo caso originale ma poco utile per decidere cosa succederà su un altro computer.
Come verificare se un'applicazione sfrutta la GPU
Per sapere se un'applicazione concreta può beneficiare, inizia con la sua documentazione e impostazioni. Cerca il nome della funzione accelerata e i dispositivi o framework compatibili. Se il produttore menziona solo l'accelerazione in una funzione particolare, non supponere che tutto il programma venga eseguito sulla GPU. La compatibilità dichiarata è il primo filtro, non una misura di miglioramento.
Successivamente definisci un test che rappresenti il tuo uso reale. Confronta lo stesso lavoro con l'opzione di accelerazione abilitata e disabilitata, mantenendo dati, qualità di output e altre condizioni rilevanti uguali. Registra il tempo totale e ripeti il test: vedere attività GPU indica solo che c'è stato lavoro sull'acceleratore, non quanto tempo è stato ridotto o se la risposta risulta più fluida.
Un controllo pratico può seguire questi passaggi:
- Identifica la funzione accelerata e conferma quale modello di GPU, sistema e driver richiede.
- Rivedi il tipo di carico: cerca operazioni ripetitive su molti dati e considera se il lavoro ha dipendenze sequenziali importanti.
- Considera i trasferimenti: scopri se l'applicazione mantiene i dati in memoria GPU o li sposta spesso tra CPU e GPU.
- Misura l'intero flusso: confronta tempo dall'inizio alla fine, non solo uso della GPU né tempo di un calcolo isolato.
- Decidi in base al miglioramento osservato: una riduzione riproducibile del tempo o una risposta più utile vale più che la percentuale di attività dell'acceleratore.
La conclusione pratica è semplice: non acquistare o configurare una GPU per un'applicazione senza verificare il suo supporto e i risultati sul tuo carico di lavoro. Il parallelismo apre una possibilità di accelerazione; software, memoria e struttura del compito determinano se diventa un miglioramento percepibile.