GPU e placa gráfica não são a mesma coisa
No uso cotidiano, GPU e placa gráfica costumam ser usados como sinônimos, mas descrevem coisas diferentes. A placa gráfica é o componente físico; a GPU é o processador que executa instruções de computação dentro do sistema. Em alguns dispositivos a GPU está integrada e não forma uma placa independente, então ter uma GPU não equivale necessariamente a possuir uma placa dedicada.
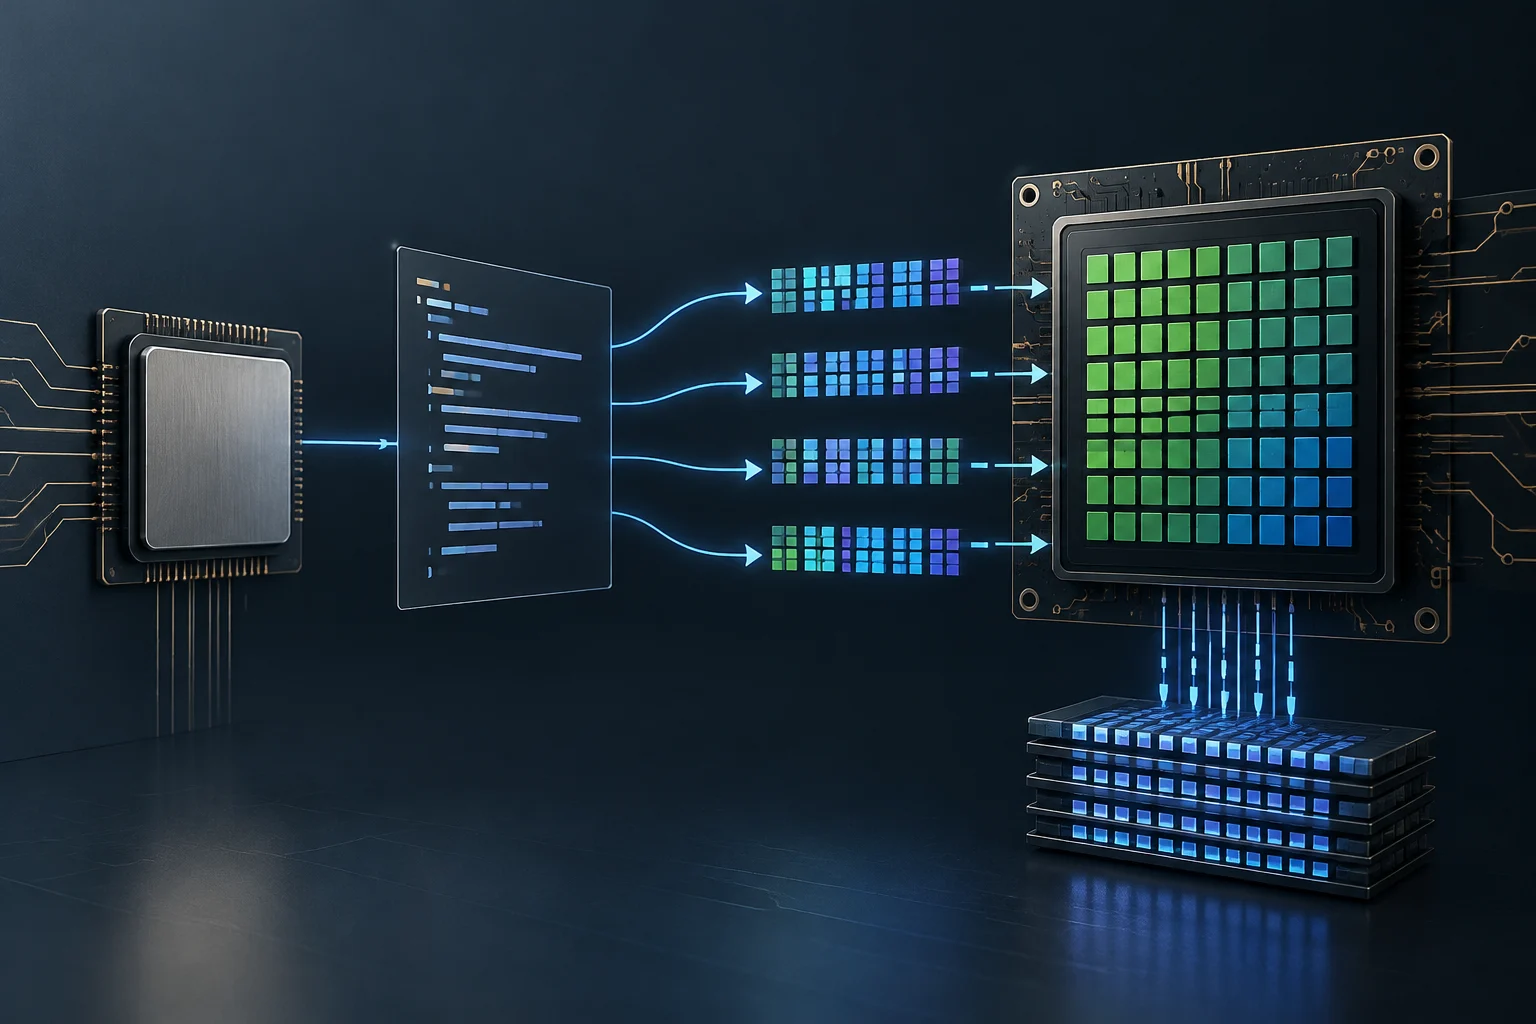
A diferença importa porque o cálculo geral acontece no CPU e no software que o usa, não simplesmente instalando uma placa. Uma GPU pode participar em tarefas além do renderização, mas o programa deve atribuir trabalho compatível a ela e gerenciar a interação com o CPU. Assim, uma placa mais potente não transforma automaticamente um aplicativo que ainda roda no CPU.
A pergunta útil não é apenas quantos recursos a GPU tem, mas se o programa pode dividir seu trabalho, enviar essa parte para a GPU e recuperar o resultado a um custo razoável. Essa jornada inclui decisões de design do programa e do ambiente de execução. A aceleração é uma propriedade da combinação entre carga, hardware e software, não uma função universal que se ativa para tudo no sistema.
O paralelismo favorece certos tipos de trabalho
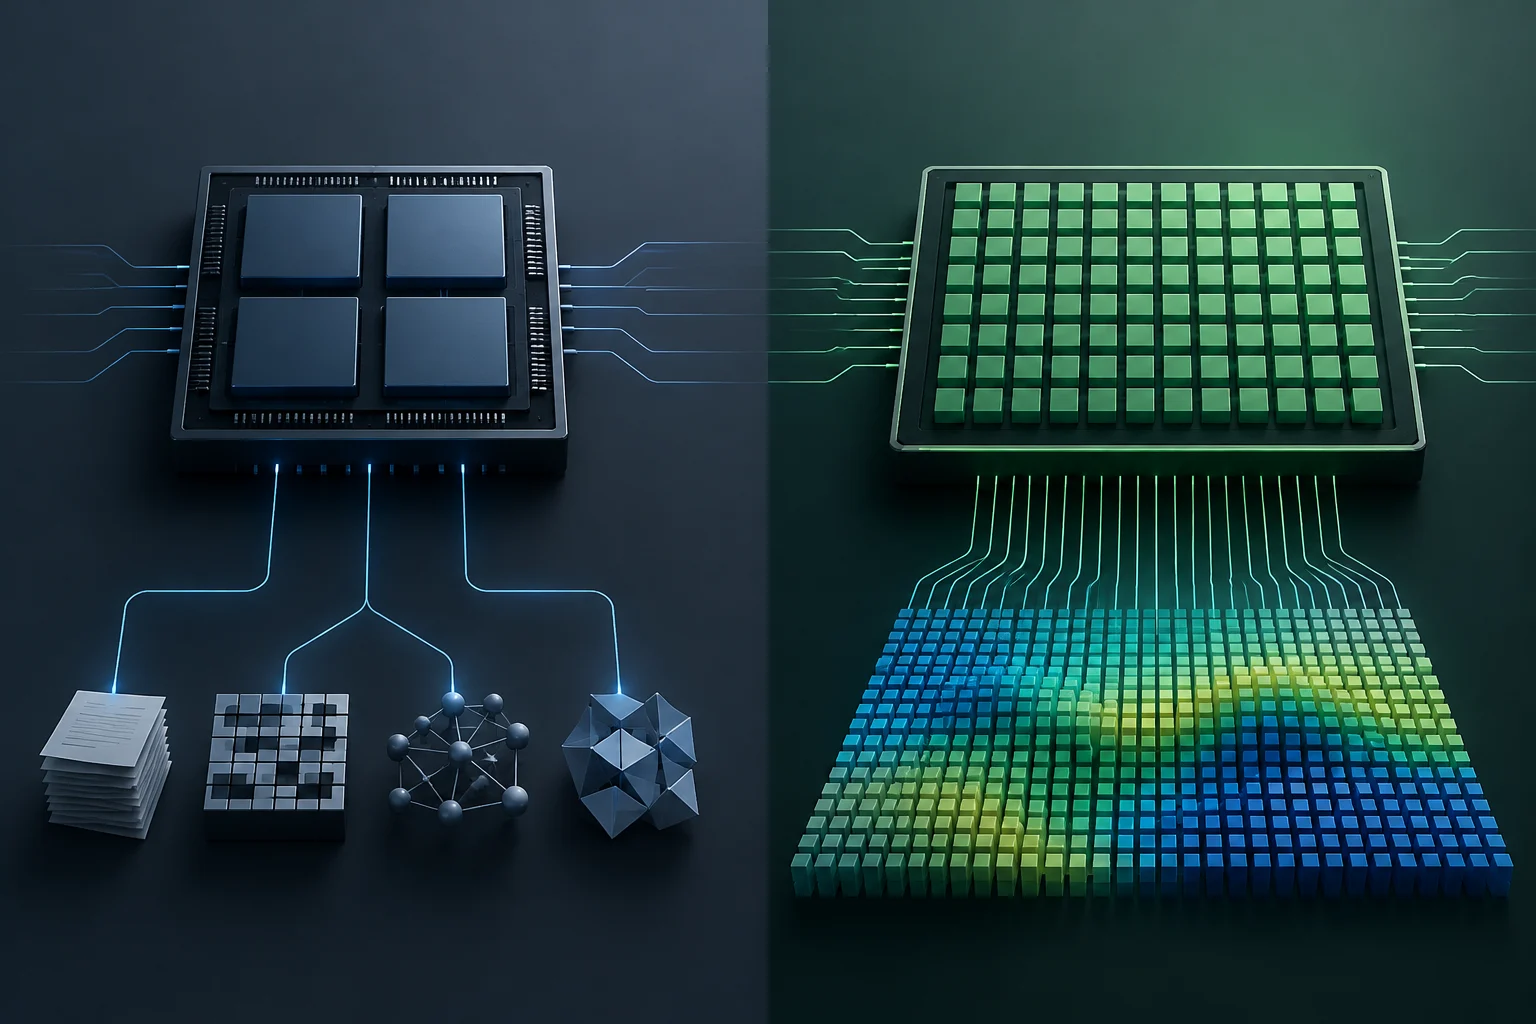
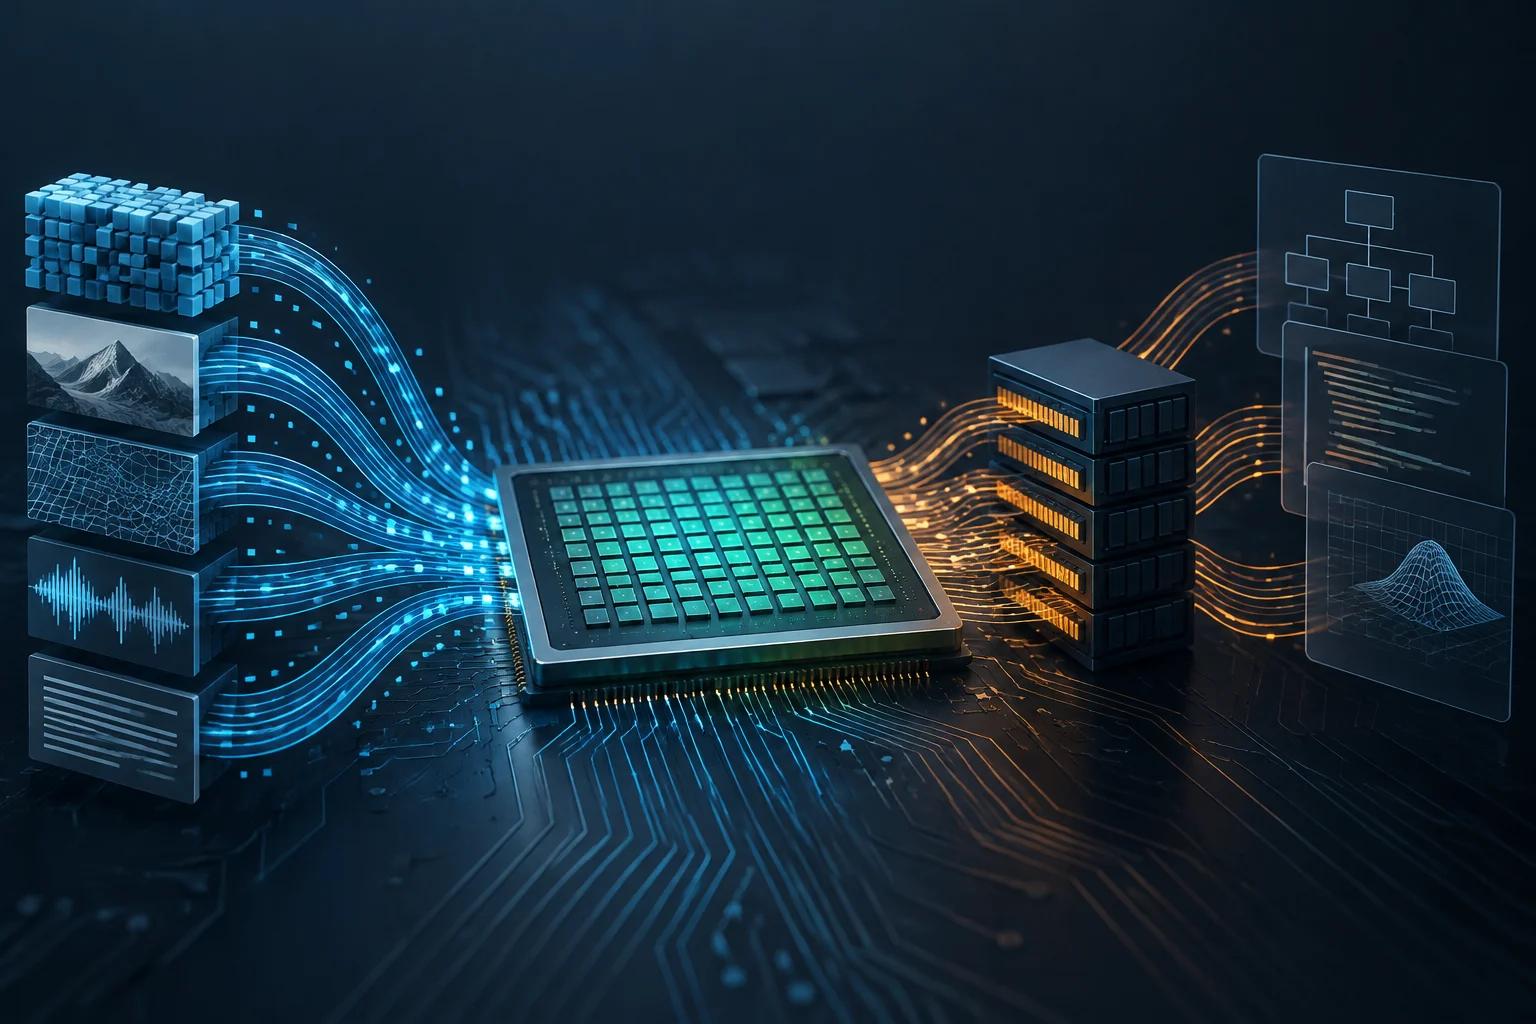
Uma GPU destaca quando pode repetir muitas operações semelhantes sobre diferentes elementos de dados. Esse padrão, chamado paralelismo de dados, aparece, por exemplo, ao aplicar uma operação a muitos pixels ou a elementos de uma matriz. A documentação da AMD descreve HIP como um modelo que permite mapear algoritmos paralelos de dados em arquiteturas GPU; também indica que essas unidades buscam alto desempenho agregado, não necessariamente terminar uma instrução individual com menor latência.
O CPU, por outro lado, está orientado a responder rapidamente a instruções individuais e executar sequências de controle. A diferença não significa que um CPU não possa processar dados em paralelo nem que uma GPU não possa executar toda lógica condicional: significa que cada design tem prioridades diferentes. A vantagem aparece quando há trabalho independente suficiente para manter ocupadas muitas unidades de computação da GPU.
Se cada passo depende do resultado anterior, ou se o programa tem muito controle de fluxo irregular, haverá menos operações disponíveis para execução simultânea. O resultado pode ser aceleração modesta ou nenhuma, mesmo com uma GPU potente. A documentação da AMD também alerta que mover código pensado para CPU para uma GPU sem adaptá‑lo não aproveita eficientemente seus recursos. Portar uma aplicação requer redesenho ou mapeamento do trabalho, não apenas mudar onde ela é compilada.
A memória e os transferências também consomem tempo
Uma GPU normalmente gerencia memória de dispositivo separada da memória do sistema usada pelo CPU. Os dados que a GPU precisa devem estar disponíveis em seu espaço de memória, e dependendo do design do programa e da plataforma, pode ser necessário transferi‑los entre ambos. A AMD identifica alocação e movimento de dados entre memória host e dispositivo como tarefas que podem ser críticas para o desempenho.
Portanto, o tempo total não é apenas o cálculo na GPU. Preparação, cópias e sincronização dos resultados também contam. Para uma tarefa curta ou com pequenos dados, esses passos podem representar parte significativa do tempo total e reduzir a vantagem prometida pelo cálculo paralelo. Não se pode afirmar que a transferência sempre anula a aceleração: seu efeito depende do tamanho dos dados, da frequência de trocas e da implementação concreta.
Plataformas oferecem mecanismos para organizar melhor esse movimento. O guia HIP menciona chamadas assíncronas, streams e a possibilidade de sobrepor transferências com cálculo quando recursos permitem. O guia CUDA também documenta cópias assíncronas na hierarquia de memória da GPU. Sobrepor trabalho pode reduzir esperas, mas não elimina a necessidade de transferir, coordenar e verificar que os dados estejam disponíveis no tempo certo.
Sem suporte explícito, o programa não delega o trabalho
Uma GPU não detecta por si só quais partes de uma aplicação seriam mais rápidas e as executa em segundo plano. O software deve incluir um caminho de execução para esse processador: pode fazer isso via API, biblioteca ou framework que forneça acesso à GPU. CUDA é a plataforma e modelo de programação paralela da NVIDIA; HIP oferece modelo de programação AMD para atribuir algoritmos paralelos a GPUs.
A compatibilidade concreta importa. Que um programa anuncie aceleração GPU não demonstra que funcione com qualquer placa, sistema operacional ou versão do driver: é preciso verificar quais dispositivos e provedores de execução essa aplicação suporta. Compatibilidade se verifica por aplicação e configuração, não se deduz da simples detecção da placa para exibir imagem.
Windows ML ilustra como uma camada de software pode oferecer diferentes opções de execução: Microsoft descreve isso como um framework local de inferência IA que pode usar CPU, GPU ou NPU via execution providers opcionais gerenciados pelo Windows. A própria documentação alerta que resultados de desempenho variam com hardware e modelo. É um exemplo limitado à inferência IA no Windows, não uma função que acelera automaticamente qualquer programa desktop.
Um resultado publicado não é promessa geral
Um estudo de processamento sísmico oferece um exemplo concreto do que uma GPU pode alcançar quando algoritmo e carga se encaixam. Os autores compararam algoritmos de decomposição de dados sísmicos com pacotes de onda e relataram aceleração entre dois e seis vezes versus CPU de 20 núcleos, nos testes realizados com conjuntos de dados sintéticos. Esse dado descreve um experimento específico, não uma cifra aplicável a qualquer tarefa ou GPU.
A documentação do fabricante ajuda a entender por que os resultados variam: modelo de execução, paralelismo disponível e gerenciamento de memória fazem parte da performance. Mas um guia de programação não substitui testar a aplicação concreta, e o estudo sísmico não compara todos os tipos de trabalho nem todas as configurações possíveis. Não há razão para extrapolar seu multiplicador para edição, jogos, compressão ou aplicações de escritório.
Ao ler uma cifra de aceleração convém verificar o que foi comparado, com qual programa e dados, qual processador foi usado como referência e se o tempo inclui transferências e preparação. Também importa se foi medida uma operação isolada ou todo fluxo que um usuário usa. Sem esses detalhes, uma cifra pode ser tecnicamente correta para seu caso original mas pouco útil para decidir o que acontecerá em outro computador.
Como verificar se uma aplicação aproveita a GPU
Para saber se uma aplicação concreta pode beneficiar, comece com sua documentação e configurações. Procure o nome da função acelerada e dispositivos ou frameworks compatíveis. Se o fabricante mencionar apenas aceleração em uma função específica, não supõe que todo o programa rode na GPU. A compatibilidade declarada é o primeiro filtro, não medida de melhoria.
Em seguida defina um teste que represente seu uso real. Compare a mesma tarefa com opção de aceleração ativada e desativada, mantendo dados, qualidade de saída e outras condições relevantes iguais. Registre tempo total e repita o teste: ver atividade da GPU indica apenas que houve trabalho no acelerador, não quanto tempo foi reduzido ou se resposta ficou mais fluida.
Um check prático pode seguir esses passos:
- Identifique a função acelerada e confirme qual modelo de GPU, sistema e driver requer.
- Revise o tipo de carga: procure operações repetitivas sobre muitos dados e considere se trabalho tem dependências sequenciais importantes.
- Considere transferências: descubra se aplicação mantém dados em memória GPU ou os move frequentemente entre CPU e GPU.
- Meça fluxo completo: compare tempo do início ao fim, não apenas uso da GPU nem tempo de cálculo isolado.
- Decida pela melhoria observada: redução reproduzível de tempo ou resposta mais útil vale mais que porcentagem de atividade do acelerador.
Conclusão prática: não compre ou configure GPU para aplicação sem verificar seu suporte e resultados em sua carga de trabalho. Paralelismo abre possibilidade de aceleração; software, memória e estrutura da tarefa determinam se vira melhoria perceptível.