Que signifie l’IA embarquée ?
L’IA embarquée désigne le traitement d’une fonction d’intelligence artificielle sur l’appareil qui l’utilise : par exemple, un téléphone, un ordinateur ou un navigateur. Sur le plan technique, le modèle y effectue l’inférence : il reçoit une entrée, calcule un résultat et le transmet à l’application. Selon les capacités du modèle, cette entrée peut être du texte, une image, de l’audio ou un autre type de données.
Le terme décrit l’endroit où le calcul est effectué, et non le type d’intelligence du système ni l’identité de son fabricant. Il peut s’agir d’un modèle traditionnel d’apprentissage automatique ou d’un modèle génératif, d’une fonction simple comme la reconnaissance de texte dans une image ou d’une tâche linguistique plus complexe. L’exécution locale ne signifie pas, à elle seule, que le service entier, l’application ou ses données restent hors d’Internet.
L’IA embarquée désigne l’inférence exécutée sur l’appareil de l’utilisateur. On distingue aussi l’IA côté client, qui s’exécute dans le navigateur ou sur l’appareil, l’IA côté serveur, traitée dans le cloud, et l’IA hybride, qui associe des étapes côté client et côté serveur. Une application peut ainsi combiner des traitements locaux et distants selon la fonction.
Comment l’appareil traite une requête
Le processus de base commence lorsqu’une application prépare une entrée — par exemple, une phrase à résumer ou une image à décrire — et la transmet à un modèle disponible localement. Le modèle convertit cette entrée en opérations mathématiques et produit une réponse ; l’application l’affiche ou l’utilise pour accomplir une tâche. L’inférence a lieu sur l’appareil lorsque ce calcul n’exige pas l’envoi de la requête à un serveur.
Le modèle peut être intégré au système, téléchargé séparément ou incorporé à l’application. Une couche logicielle détermine comment l’appeler et quelles ressources matérielles utiliser. Sur Android, par exemple, Google présente AICore comme un service système placé entre les applications et Gemini Nano ; la plateforme gère l’accès au modèle et sa distribution. Il s’agit d’un exemple d’architecture, et non d’une fonction universelle sur tous les téléphones.
Au niveau matériel, le CPU peut gérer le fonctionnement général de l’application et exécuter des modèles compatibles ; le GPU peut accélérer les calculs parallèles, tandis que le NPU est conçu pour certaines opérations d’apprentissage automatique. Tous les modèles n’utilisent pas le NPU : cela dépend de l’appareil, du système, du format du modèle et du logiciel. Sous Windows, les outils d’inférence peuvent choisir un accélérateur compatible et, dans certains cas, recourir au CPU ou au GPU si une autre voie n’est pas disponible.
La mémoire disponible et la représentation du modèle comptent également. Un modèle plus volumineux ou une entrée plus longue peut demander davantage de mémoire et de temps de calcul. La quantification réduit la précision numérique des poids afin de rendre certains modèles plus compacts ou plus efficaces, avec d’éventuels compromis de qualité. La présence d’un accélérateur ne garantit donc pas que chaque modèle ou fonction s’exécutera efficacement sur celui-ci.
IA locale, IA dans le cloud et inférence hybride
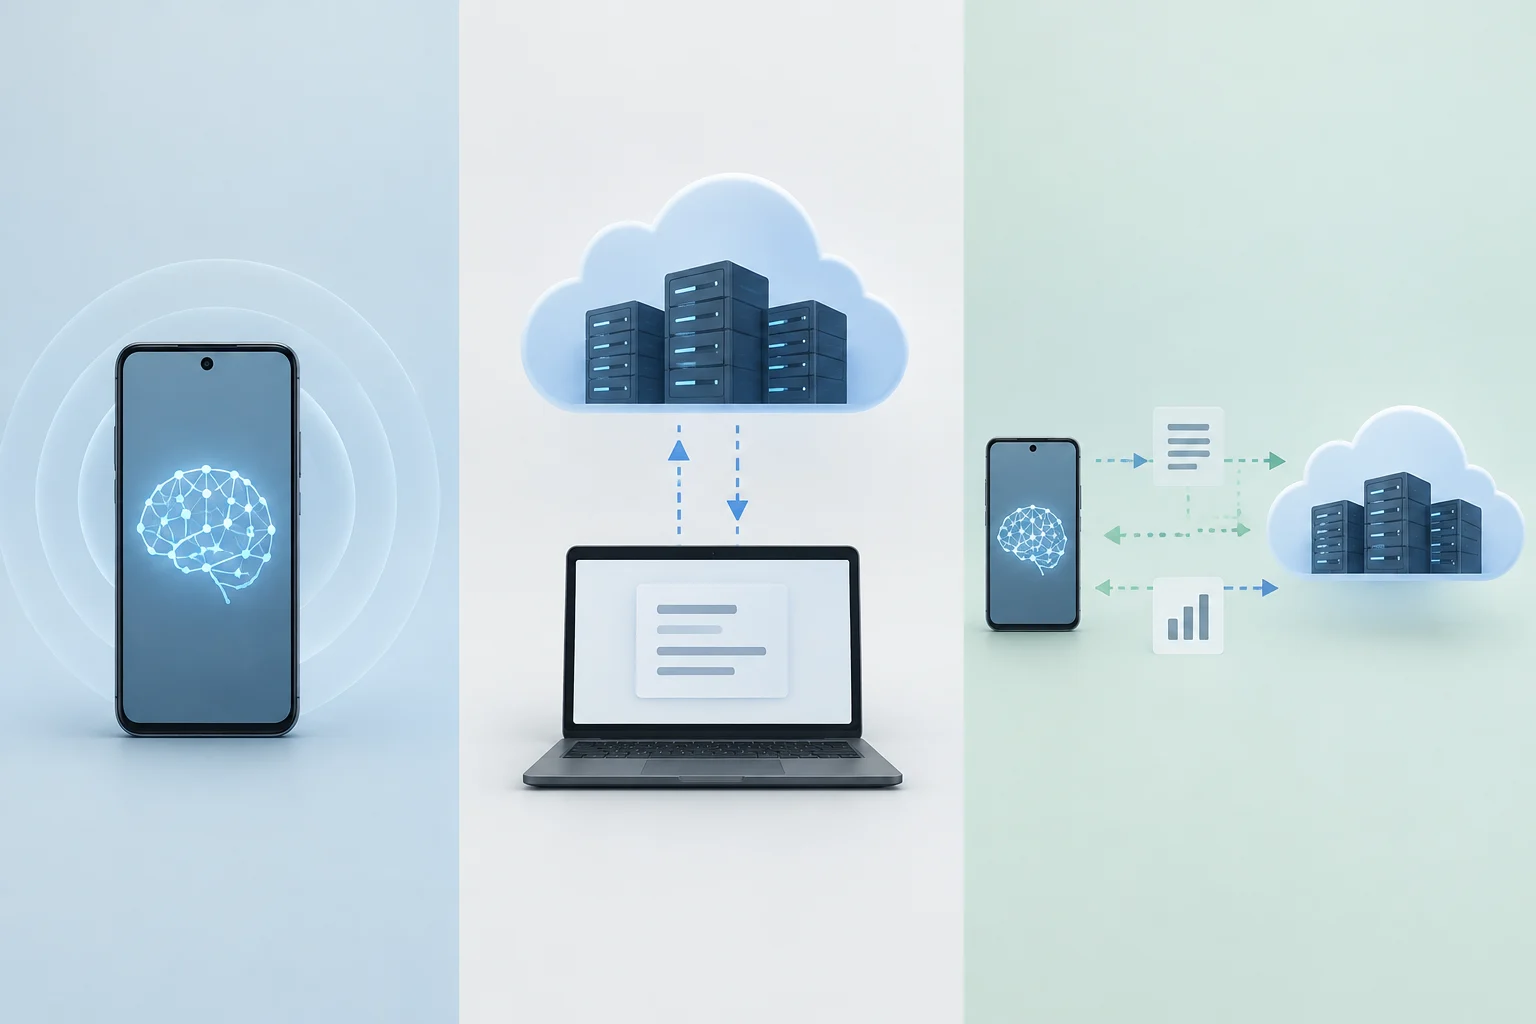
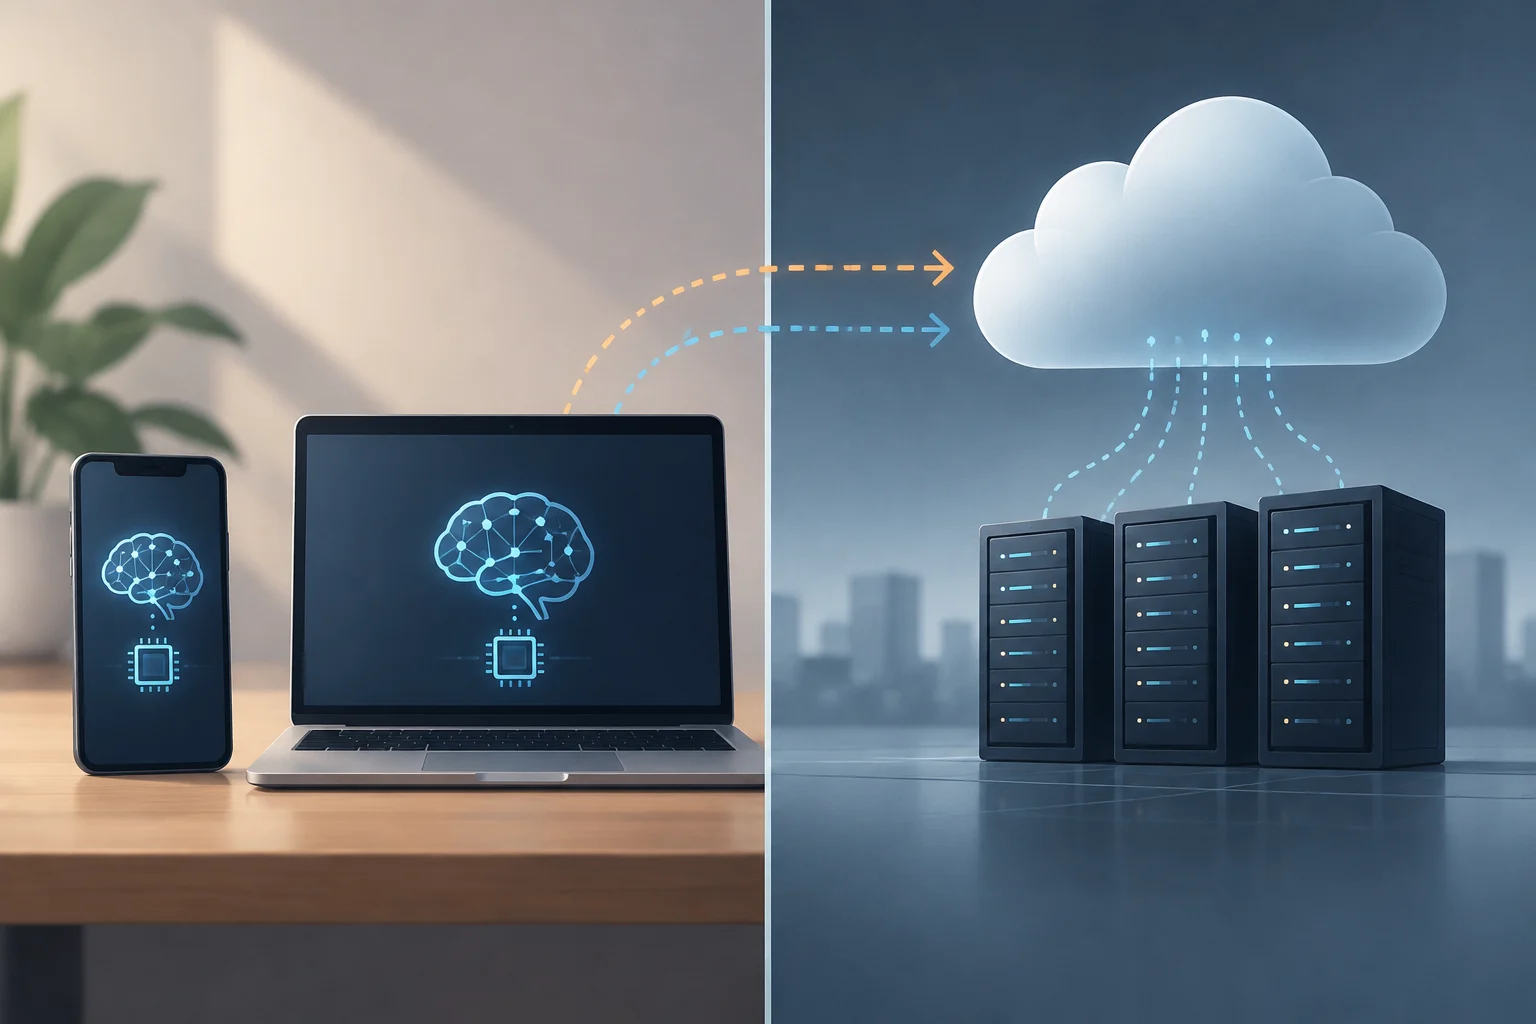
La distinction principale porte sur l’endroit où la réponse est calculée. Dans un parcours local, le modèle traite la requête sur l’appareil. Dans un parcours cloud, l’application transmet des données à un service distant qui exécute le modèle et renvoie le résultat. Une architecture hybride peut répartir les étapes entre les deux environnements ou choisir un parcours en fonction de la tâche et des capacités de l’appareil.
| Aspect | Traitement sur l’appareil | Traitement dans le cloud |
|---|---|---|
| Lieu du calcul | Sur le téléphone, l’ordinateur ou un autre appareil de l’utilisateur | Sur les serveurs distants du fournisseur |
| Connexion pour l’inférence | Peut fonctionner hors ligne si le modèle et la fonction sont déjà disponibles | Nécessite généralement une connexion pour envoyer la requête et recevoir la réponse |
| Latence potentielle | Évite l’aller-retour réseau, mais dépend du matériel et du modèle | Ajoute le temps de communication au traitement distant |
| Données | La requête peut rester sur l’appareil si la fonction est conçue ainsi | Les données transmises sont traitées hors de l’appareil, selon le service et ses politiques |
Le tableau décrit des tendances, pas des garanties : une application peut synchroniser des données, télécharger des modèles ou envoyer de la télémétrie même lorsqu’une inférence particulière est locale.
L’inférence hybride combine les deux parcours. Une application peut d’abord tenter de répondre localement, puis faire appel à un modèle distant si le modèle local n’est pas disponible, si la requête dépasse ses limites ou si l’utilisateur demande une fonction nécessitant des services en ligne. La documentation destinée aux développeurs Android décrit ce type de solution de repli : certaines requêtes peuvent être envoyées à des modèles cloud lorsque Gemini Nano n’est pas disponible ou ne convient pas.
Ainsi, « local » et « cloud » ne sont pas toujours des catégories exclusives pour une application dans son ensemble. Une fonction peut analyser un texte sur l’appareil, puis synchroniser le résultat ; une autre peut utiliser un modèle local pour les tâches simples et un service distant pour les requêtes plus complexes. Le parcours peut varier selon la fonction : mieux vaut donc examiner ce qui se passe pour une opération précise que classer toute une application sous une seule étiquette.
Quelles tâches peuvent être exécutées localement
Les tâches adaptées à l’appareil ont généralement un périmètre défini et tiennent dans les ressources disponibles. Parmi les exemples documentés par les plateformes figurent la transcription ou la traduction de la parole, le résumé de textes courts, la reformulation de messages, la description d’images, la reconnaissance de texte dans une photographie et la génération de résultats structurés. Certaines fonctions système peuvent aussi reconnaître l’écriture manuscrite ou réduire le bruit pendant un appel.
Un exemple pratique est l’extraction de texte d’une image. L’appareil photo capture un signal visuel, puis un modèle de reconnaissance optique de caractères (OCR) identifie les caractères ; l’application peut afficher le texte ou permettre de le copier. Android propose des API de reconnaissance de texte capables de traiter sur l’appareil les images de la caméra. Si la fonction n’a besoin que de l’image et du modèle local, elle peut fonctionner sans envoyer chaque capture à un service distant, mais le comportement dépend de l’application concernée.
Un cas d’utilisation documenté sur Android est le résumé d’enregistrements vocaux : l’application Enregistreur Google Pixel utilise Gemini Nano pour générer des résumés sur l’appareil et hors ligne. Séparément, les API d’IA générative de ML Kit permettent de transcrire la parole en texte, de traduire la voix et de synthétiser la parole à partir d’un texte. La disponibilité de ces fonctions dépend de l’application et de la compatibilité de l’appareil.
D’autres usages sont moins visibles, comme le classement de contenus ou la recherche de fichiers par leur sens plutôt que par correspondance exacte. Un modèle peut créer des représentations numériques de textes ou d’images — des embeddings — afin qu’un index local retrouve des éléments apparentés. Dans d’autres cas, le système interprète le contenu affiché à l’écran pour proposer des actions contextuelles. Le traitement local ne garantit pas l’exactitude du résultat : sa qualité dépend du modèle et du contexte, et les tâches sensibles peuvent nécessiter une vérification humaine.
Avantages possibles et limites de performance
L’avantage le plus direct de l’inférence locale est d’éviter une partie de l’aller-retour réseau : si la requête est résolue sur l’appareil, la réponse n’a pas à attendre qu’un appel atteigne un serveur puis en revienne. Cela peut réduire la latence sans garantir un calcul rapide ; un modèle exigeant sur un appareil modeste peut prendre plus de temps qu’un service distant puissant.
Le fonctionnement hors ligne est une autre possibilité. Pour cela, le modèle et les composants nécessaires doivent déjà être installés et la fonction ne doit pas dépendre d’une requête externe. Le téléchargement initial, la mise à jour du modèle, la synchronisation de fichiers ou un outil connecté à Internet peuvent toujours nécessiter une connexion. « Peut fonctionner hors ligne » ne signifie pas « n’a jamais besoin d’Internet ».
Le matériel impose des limites concrètes : puissance de calcul, mémoire, espace de stockage, température et énergie disponible. Un NPU peut accélérer des opérations compatibles et laisser d’autres ressources disponibles, mais il ne supprime pas le coût d’exécution du modèle. Pour les tâches prolongées, la consommation et l’échauffement restent importants ; les caractéristiques annoncées par le fabricant ne suffisent pas à déduire les performances de chaque application ou charge de travail.
La taille et les capacités du modèle déterminent également ce qu’il peut faire. Un modèle compact peut répondre rapidement à des tâches limitées, tout en étant moins performant face à des instructions longues, à un contexte étendu ou à des questions complexes. Google signale des limites matérielles, de jetons et de capacité du modèle pour Gemini Nano, et propose l’inférence hybride lorsqu’un périmètre plus large est nécessaire. Le choix pratique consiste à utiliser le modèle local s’il traite correctement la tâche avec les ressources disponibles, et à réserver le parcours distant aux fonctions qui en ont réellement besoin.
Confidentialité et sécurité : ce que cela garantit ou non
Le traitement local peut réduire la quantité d’informations qu’une fonction doit transmettre : si une requête est résolue sur l’appareil, il n’est pas nécessaire d’envoyer cette entrée à un serveur pour cette inférence. C’est une caractéristique du parcours des données, et non une certification générale de confidentialité. L’application peut encore transmettre d’autres données, synchroniser du contenu, consigner des activités ou utiliser des services distants pour d’autres fonctions.
La politique de confidentialité, les contrôles de l’application et les réglages système déterminent les données recueillies et leurs finalités. Il importe aussi de savoir où sont stockés les entrées, les résultats et les données temporaires, qui peut y accéder et si l’application les conserve après leur traitement. Pour une décision sensible, il faut examiner les autorisations demandées, les réglages de la fonction et la politique du fournisseur, ainsi que vérifier s’il est possible de désactiver la fonction ou d’effacer ses données.
Le traitement local n’empêche pas non plus les risques liés à une application malveillante, à un appareil compromis, à un accès non autorisé à un compte ou à une réponse erronée du modèle. Le chiffrement du stockage, l’authentification et les contrôles système contribuent à protéger les données, mais sont distincts de l’emplacement de l’inférence. Local ne signifie pas automatiquement sécurisé, tout comme une connexion au cloud ne rend pas à elle seule un service non sécurisé.
Certaines plateformes proposent des contrôles propres à une fonction. La documentation de Microsoft sur Recall décrit, par exemple, un stockage local chiffré, une activation volontaire et des commandes permettant de suspendre ou d’effacer des données ; ces conditions concernent cette fonction et ne doivent pas être généralisées à toute l’IA embarquée. Les bonnes questions sont : quelles données la fonction traite-t-elle, où les stocke-t-elle, quittent-elles l’appareil et quels contrôles l’utilisateur peut-il exercer ?
Comment évaluer une fonction avant de l’utiliser
L’étiquette « IA embarquée » peut orienter, mais la décision doit s’appuyer sur le comportement de la fonction concernée. Sur un téléphone ou un ordinateur, les informations de compatibilité peuvent indiquer les modèles et versions pris en charge ; les paramètres de confidentialité présentent souvent les autorisations, le stockage et les options de synchronisation. Pour un outil professionnel, des politiques de gestion peuvent aussi déterminer quelles fonctions sont activées.
Une vérification pratique peut s’articuler autour de quatre questions : Quelle entrée est traitée ? Quelles étapes sont exécutées localement ? Que se passe-t-il sans connexion ? Quelles données sont conservées ou partagées ? Ne présumez pas que le mode hors ligne est activé simplement parce que le modèle fonctionne localement.
La comparaison ne vise pas à proclamer une architecture gagnante. L’appareil offre un parcours utile lorsque l’accès hors ligne, la réponse immédiate ou la réduction de certaines transmissions compte ; le cloud peut convenir à une fonction qui nécessite un modèle plus performant ou des ressources absentes de l’appareil. Le choix dépend de l’usage et des données, ainsi que des options réelles de l’application, pas seulement du nom commercial de la fonction.
En résumé, l’IA embarquée signifie qu’une partie de l’inférence se déroule sur l’appareil de l’utilisateur. Elle peut améliorer la disponibilité et limiter l’envoi de données pour cette opération, mais les résultats dépendent du matériel, du modèle et de la conception logicielle. La confidentialité exige d’examiner l’ensemble du parcours des données ; les capacités locales doivent, quant à elles, être évaluées au regard de la tâche à accomplir.