Définition pratique et portée du terme
L'IA locale est une manière pratique de décrire les systèmes dans lesquels un modèle ou une fonction d'intelligence artificielle s'exécute sur l'appareil de l'utilisateur ou sur une infrastructure contrôlée par celui-ci, son organisation ou un administrateur. Le terme ne détermine pas à lui seul la taille du modèle, qui l'a développé ni si l'ensemble du service fonctionne hors ligne.
Il n'existe pas de définition technique unique de « IA locale » dans les sources disponibles. Il convient donc de l'utiliser pour parler de l'endroit où se produit le traitement d'une fonction concrète, plutôt que de la traiter comme une catégorie fermée avec des exigences universelles. Un téléphone traitant une tâche et un serveur d'une organisation peuvent correspondre à cette description, bien que leurs ressources et formes d'administration soient différentes.
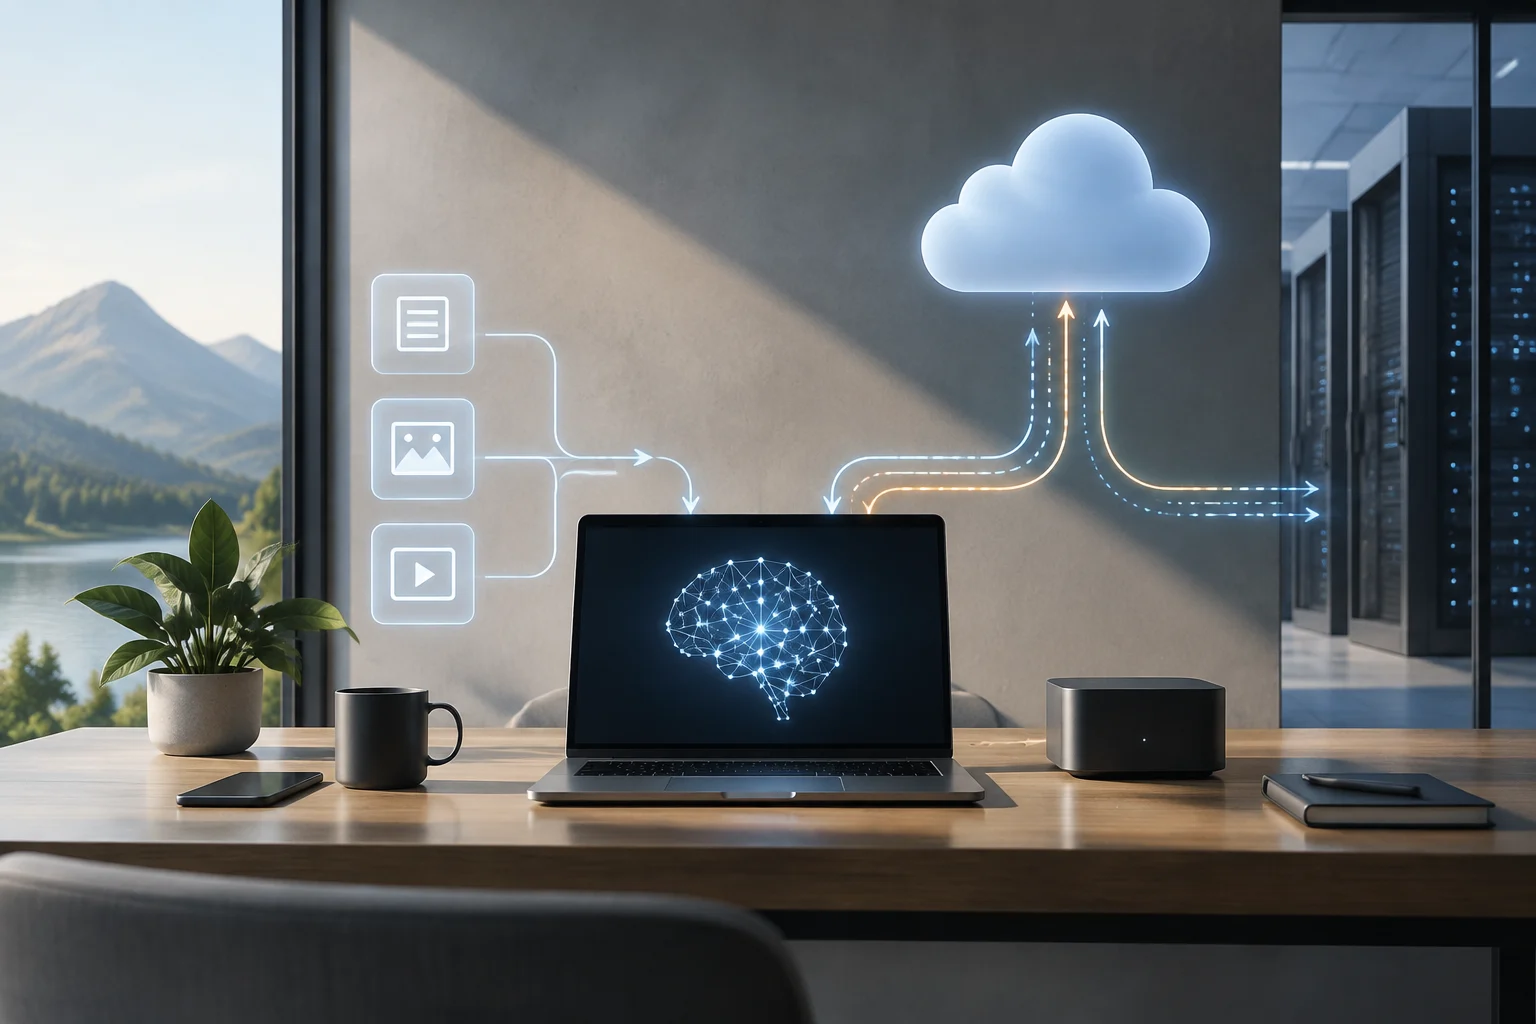
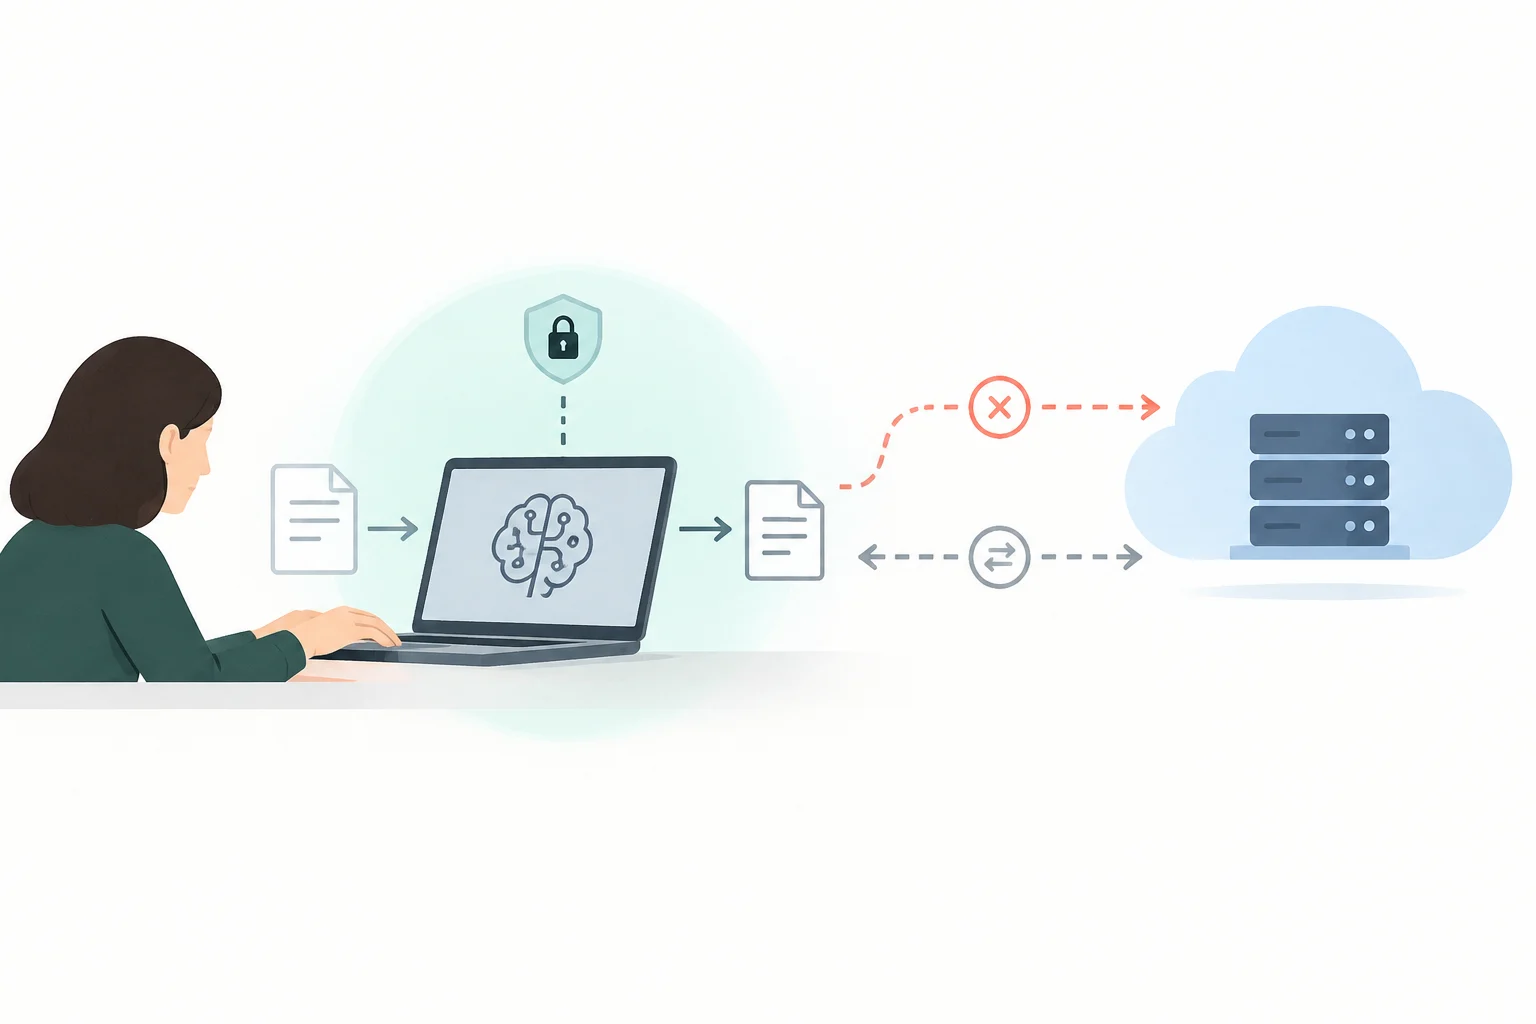
La différence fondamentale avec un service d'IA dans le cloud réside dans l'emplacement du calcul principal : dans le premier cas, il est réalisé sur l'appareil ou dans un environnement local ; dans le second, sur l'infrastructure distante du fournisseur. Cette distinction n'implique pas que chaque composant suive le même chemin. Une application peut traiter une opération localement et recourir à des services distants pour d'autres fonctions.
Ainsi, lors de l'évaluation d'une fonction, il est plus précis de demander quelle partie est traitée localement que d'étiqueter toute l'application comme locale. Le téléchargement du modèle, l'authentification, les mises à jour et les fonctions auxiliaires peuvent toujours dépendre d'une connexion ou de services externes. Le mot « local » ne prouve pas, à lui seul, qu'il n'y a pas d'échange de données avec des tiers.
Fonctionnement : modèle, entrées et ressources
En termes simples, le système doit disposer du modèle sur l'appareil ou le serveur choisi et y exécuter les opérations correspondantes à une requête. Le CPU, le GPU et la mémoire font partie des ressources pouvant intervenir. Si la tâche est achevée dans cet environnement, l'entrée n'a pas besoin d'être envoyée à un serveur distant pour ce traitement ; cela n'exclut pas d'autres communications liées à l'application.
L'appareil doit disposer de ressources suffisantes pour charger le modèle et traiter la tâche. La mémoire disponible est une limite importante, mais pas la seule : la puissance de calcul, le format du modèle et l'application qui l'exécute comptent aussi. Il ne suffit pas que le fichier tienne dans le stockage ; le système doit pouvoir l'utiliser pendant l'inférence.
Certains exemples illustrent la différence entre installer un modèle et pouvoir l'exécuter. Un guide secondaire cite des modèles de 12 milliards de paramètres associés à environ 7,6 Go et de 27 milliards associés à 18 Go. Ce sont des exemples concrets de cette source, pas des exigences universelles : les besoins réels varient selon le modèle, son format, la configuration et le matériel.
Le traitement peut se produire sur un ordinateur personnel ou sur un serveur administré par une organisation. Ce dernier peut offrir des ressources différentes de celles d'un mobile, mais « local » ne signifie pas automatiquement que l'utilisateur a un contrôle exclusif sur le serveur. Pour comprendre le déploiement, il faut distinguer l'emplacement physique, l'administration et l'accès : ce sont des questions liées, mais non équivalentes.
Local, sur l'appareil, hors ligne et auto-hébergé
Ces termes décrivent des aspects différents et peuvent se chevaucher. L'IA sur l'appareil indique généralement que le calcul se produit sur un mobile, un ordinateur ou un autre équipement personnel. « L'IA locale » peut couvrir ce cas, mais aussi un serveur dans un réseau ou une infrastructure administrée localement. « Auto-hébergé » met l'accent sur qui maintient ou administre le système, pas nécessairement sur le fait qu'il s'exécute sur le même appareil que celui utilisé par la personne.
« Hors ligne » décrit une condition de connectivité : la fonction peut fonctionner sans accès à Internet. Ce n'est pas synonyme de « local ». Un modèle peut s'exécuter sur l'appareil et avoir besoin d'Internet pour se télécharger, se mettre à jour ou accéder à une fonction complémentaire. À l'inverse, un serveur d'un réseau local peut traiter des requêtes sur ce réseau même si les appareils clients y sont connectés.
Le cloud désigne ici un traitement réalisé sur une infrastructure distante gérée par un fournisseur. Les configurations peuvent être hybrides : une étape s'exécute sur l'appareil et une autre est envoyée à un service distant. Le tableau résume les distinctions pratiques ; ce ne sont pas des catégories nécessairement exclusives ni ne garantissent-elles à elles seules un résultat de confidentialité déterminé.
| Configuration | Où se produit le calcul principal | Besoin d'Internet ? | Ce qui peut être conclu sur la confidentialité |
|---|---|---|---|
| IA sur l'appareil | Sur le mobile ou l'ordinateur utilisé par la personne | Pas nécessairement pour chaque tâche ; le téléchargement ou les fonctions supplémentaires peuvent nécessiter une connexion | L'entrée traitée localement n'a pas à être envoyée pour cette opération ; il faut vérifier d'autres communications |
| IA auto-hébergée | Sur une infrastructure administrée par la personne ou l'organisation, comme un serveur privé | Dépend de l'accès au serveur, des mises à jour et des services associés | L'administration peut être sous contrôle propre ; cela ne prouve pas que le serveur ou l'application est exempt d'accès ou de transferts |
| Traitement dans le cloud | Sur l'infrastructure distante du fournisseur | Une connexion est généralement requise pour envoyer les requêtes et recevoir les résultats | La requête est traitée hors de l'appareil ; les politiques et le parcours des données dépendent du service |
| Configuration hybride | Une combinaison d'appareil, d'infrastructure locale et de services distants | Dépend de la fonction concrète | Il faut identifier quelles données et étapes passent par chaque environnement |
Confidentialité, sécurité et connectivité
Si une requête est traitée localement et non transmise à un autre système, l'exposition associée à l'envoi de cette entrée à un fournisseur distant peut être réduite. C'est un avantage potentiel de contrôle, pas une garantie générale de confidentialité. Pour savoir ce qui se passe en pratique, il faut vérifier le parcours des données de chaque fonction, y compris les étapes avant et après l'inférence.
Le terme local ne certifie pas non plus la sécurité de l'équipement. Un appareil ou un serveur peut être mal configuré, permettre des accès non autorisés ou stocker des données de manière inattendue pour l'utilisateur. La protection dépend des mesures appliquées, de qui a accès et de la gestion des journaux, des copies et des mises à jour. L'emplacement du calcul n'est qu'une pièce de cette évaluation.
La connexion peut toujours être nécessaire pour obtenir le modèle, le mettre à jour ou utiliser des capacités distantes. De plus, une application peut combiner traitement local et requêtes à des services externes. Par conséquent, fonctionner localement n'équivaut pas à fonctionner toujours sans réseau. La question utile est quelles tâches peuvent être achevées hors ligne et quelles données sont transmises lorsque la connexion est de nouveau disponible.
Pour des informations sensibles, il ne convient pas de déduire la confidentialité d'une étiquette commerciale ou d'un réglage isolé. Cherchez des explications du fournisseur sur ce qui est traité sur l'appareil, ce qui est envoyé aux serveurs, combien de temps cela est conservé et quels services sont activés. Si la documentation ne permet pas de répondre, ce manque de détail limite ce qui peut être conclu ; cela ne prouve pas, à lui seul, qu'il y a un transfert.
Applications possibles et limites de performance
Le traitement local peut être pertinent lorsqu'on veut qu'une tâche soit résolue près des données ou réduire la dépendance à un service distant. Parmi les tâches souvent envisagées figurent la résumation de documents, la transcription de contenu ou l'analyse d'images. Ce sont des applications possibles de l'approche, pas une garantie que tout modèle local puisse effectuer chaque tâche avec une qualité adéquate.
Le choix dépend de la tâche et du modèle, en plus du matériel. Un modèle spécialisé dans le texte n'est pas équivalent à un modèle préparé pour analyser des images ; deux modèles de taille similaire ne répondent pas nécessairement de la même manière. Pour des documents étendus, par exemple, la capacité à gérer le contexte et la manière dont l'application incorpore les informations comptent. La taille ou le nom du modèle ne suffisent pas à anticiper son utilité.
Sur l'appareil, la mémoire et la puissance de calcul limitent quels modèles peuvent s'exécuter et avec quelle fluidité. Les modèles plus grands peuvent nécessiter plus de ressources ; la documentation disponible ne permet pas d'offrir une figure universelle de vitesse, de consommation ou de qualité pour chaque type d'équipement. La décision pratique est de vérifier les exigences du modèle concret et la compatibilité de l'application, sans supposer que l'installation suffit.
Il y a aussi des coûts opérationnels moins visibles : réserver de l'espace, obtenir de nouvelles versions et maintenir l'environnement. Dans une installation administrée, ces tâches incombent à celui qui maintient l'infrastructure. Dans un service distant, une partie de cette maintenance peut revenir au fournisseur, bien que l'utilisateur dépende toujours de son service et de sa connexion. Le contrôle et le confort peuvent impliquer des compromis différents, pas une hiérarchie valable pour tous.
Comment vérifier où une fonction est traitée
Commencez par la documentation officielle du fournisseur et cherchez une explication se référant à la fonction concrète : exécution sur l'appareil, traitement distant ou modalité hybride. Vérifiez aussi si la fonction nécessite de télécharger un modèle, de se connecter à un serveur ou d'activer des services supplémentaires. Une description générale de l'application peut ne pas clarifier le comportement de chaque capacité.
Les autorisations du système d'exploitation fournissent un contexte sur les accès qu'une application demande, mais n'identifient pas à elles seules la destination des données ni l'endroit où un modèle s'exécute. Sur Android, par exemple, <uses-permission-sdk-23> permet de déclarer qu'une autorisation est requise pour les installations sur Android 6.0 (niveau API 23) ou ultérieur. Cette déclaration concerne les autorisations et la compatibilité, pas de prouver que l'IA fonctionne localement.
Il est aussi utile de vérifier si une tâche reste disponible en désactivant la connexion, mais ce résultat n'informe que sur le besoin de réseau dans cette circonstance. Il ne certifie pas à lui seul quelles données ont été transmises auparavant, s'il y a des journaux ni comment se comportent d'autres fonctions. De même, un indicateur « sur l'appareil » doit être lu avec la documentation et la portée exacte à laquelle il se réfère.
Une liste de contrôle brève aide à éviter des conclusions hâtives :
- Identifiez la fonction et le modèle, pas seulement le nom de l'application.
- Cherchez où l'inférence s'exécute et quelles opérations utilisent des services distants.
- Revoyez les exigences de téléchargement, de mise à jour et de connexion.
- Consultez quelles données sont stockées, transmises ou journalisées, et pendant combien de temps.
- Si la réponse n'est pas documentée, considérez l'emplacement du traitement non confirmé, au lieu de l'inférer à partir d'autorisations ou de messages promotionnels.